
 洗子
 匿名

手机拍下的人脸,记录的是肤色,还是光照?
两者都有。额头上的亮斑可能来自皮肤表面反射,鼻翼的阴影可能来自表面方向,照片中的颜色还会受到闪光灯、曝光和相机处理的影响。直接把照片贴到三维模型上,原来的高光和阴影就可能被一起固定下来。换一盏灯,这张脸反而不自然了。
这篇CVPR2023论文希望用较容易获得的设备,把这些成分分开:给手机镜头和闪光灯分别加上偏振膜,在暗室里采集交叉偏振与平行偏振两组数据,再通过可微渲染优化,得到可供重新打光的人脸皮肤资产。
它的关键不是“让手机直接拍到全部材质参数”,而是先通过偏振减少反射分解的歧义,再利用已知照明和多视角观测,把肤色、高光与细节方向逐步优化出来。
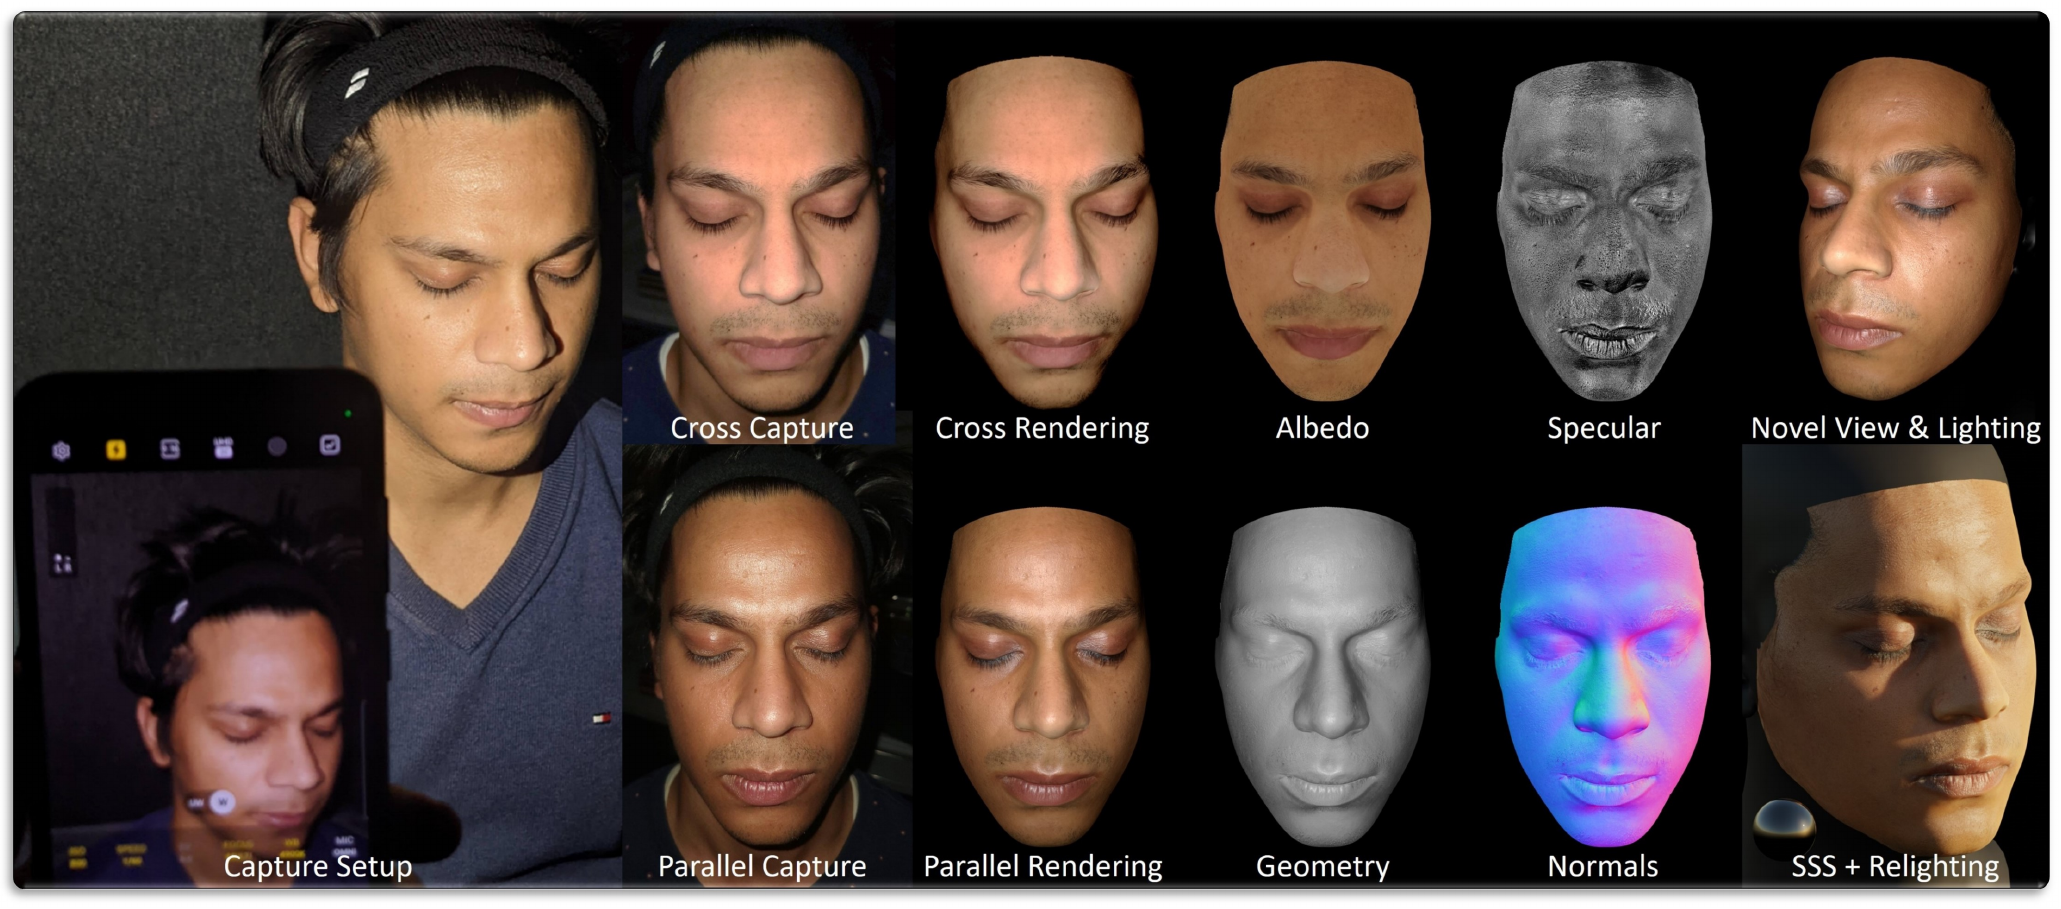
图1|手机偏振采集、交叉和平行偏振观测、重建贴图及重新打光结果。输出可用于Blender等常规渲染软件。来源:原论文图1。
最终结果包括基础人脸网格、4K漫反射反照率、镜面增益和法线贴图,以及全脸共享的粗糙度混合参数。毛孔等细节主要体现在这些高分辨率外观贴图中,不应直接解释为已经测出了每个毛孔的三维深度。
论文信息
| 项目 | 内容 |
|---|---|
| 英文标题 | High-Res Facial Appearance Capture from Polarized Smartphone Images |
| 中文标题 | 从偏振智能手机图像中采集高分辨率人脸外观 |
| 发表 | CVPR 2023 |
| 作者 | Dejan Azinović、Olivier Maury、Christophe Hery、Matthias Nießner、Justus Thies |
| 机构 | Technical University of Munich、Meta Reality Labs、Max Planck Institute for Intelligent Systems |
| 项目主页 | https://dazinovic.github.io/polface/ |
| 项目仓库 | https://github.com/dazinovic/polface(当前展示为项目网页文件,未见重建优化实现) |
| 关键词 | 偏振成像、手机人脸采集、逆渲染、材质分解、法线贴图、粗到细优化 |
一、为什么要给镜头和闪光灯都加偏振膜?
皮肤的反射可以粗略分成两类。光在表面反射,形成明显高光;光进入皮肤后经历散射,再从表面出射,形成较柔和的颜色响应。
论文利用的近似是:表面镜面反射较多保留入射光的偏振状态,而内部散射会使偏振状态发生去偏振。
因此,闪光灯前的偏振膜先让照明具有确定的线偏振方向,镜头前的偏振膜再选择哪些偏振分量能够进入相机。
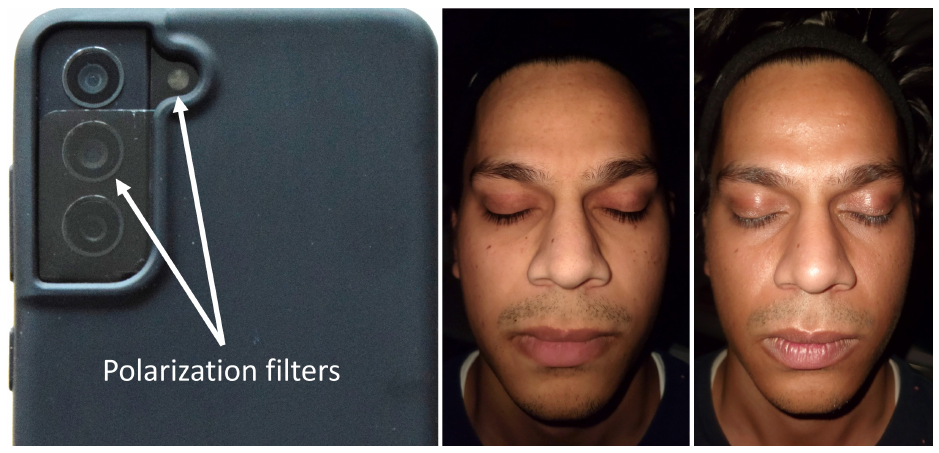
图3|左侧为贴有偏振膜的手机,中间为交叉偏振照片,右侧为平行偏振照片。交叉偏振显著抑制表面高光,平行偏振保留更明显的镜面响应。来源:原论文图3。
当两片膜的方向垂直时,得到交叉偏振观测,主要用于估计漫反射部分;方向平行时,得到漫反射与镜面反射混合的观测,用于进一步恢复高光参数。
这里不是直接拿两张照片逐像素相减。两组数据是手持手机分别拍摄的,视角、位置与投影关系并不完全相同。系统先重建几何与相机位姿,再通过渲染模型解释不同视角的观测。
偏振提供的是更清楚的观测条件,几何、校准和优化仍然不可缺少。
二、实际采集:两段视频之外,还要拍照片
作者使用Samsung Galaxy S21 FE 5G,在暗室中以手机闪光灯作为主要受控照明,分别采集交叉偏振和平行偏振数据。
视频以4K、30 fps记录,每10帧选取一张较清晰的图像,清晰度依据拉普拉斯方差判断。此外,两种偏振设置还分别拍摄照片,用更明亮的拍照闪光获得更好的细节观测。
这几类数据的作用不同:
| 数据 | 用途 |
|---|---|
| 视频帧与照片共同使用 | 估计相机位姿、重建基础几何,提高几何求解稳定性 |
| 交叉偏振照片 | 优化漫反射反照率与初始法线 |
| 平行偏振照片 | 优化镜面增益、最终法线与全局粗糙度参数 |
纹理优化只使用照片。 视频为几何提供更密集的视角,照片为材质提供更清晰的观测。这一点比“用两段手机视频重建人脸”的简写更接近实际流程。
原文报告完整采集约5分钟,几何重建平均使用约420个视频帧和70张照片。拍摄时需要保持相机设置稳定,也需要被摄者维持静态表情、闭眼和闭口。
手机降低了采集设备门槛,但并没有把任务变成随手拍一张,也没有要求所有计算在手机上完成。
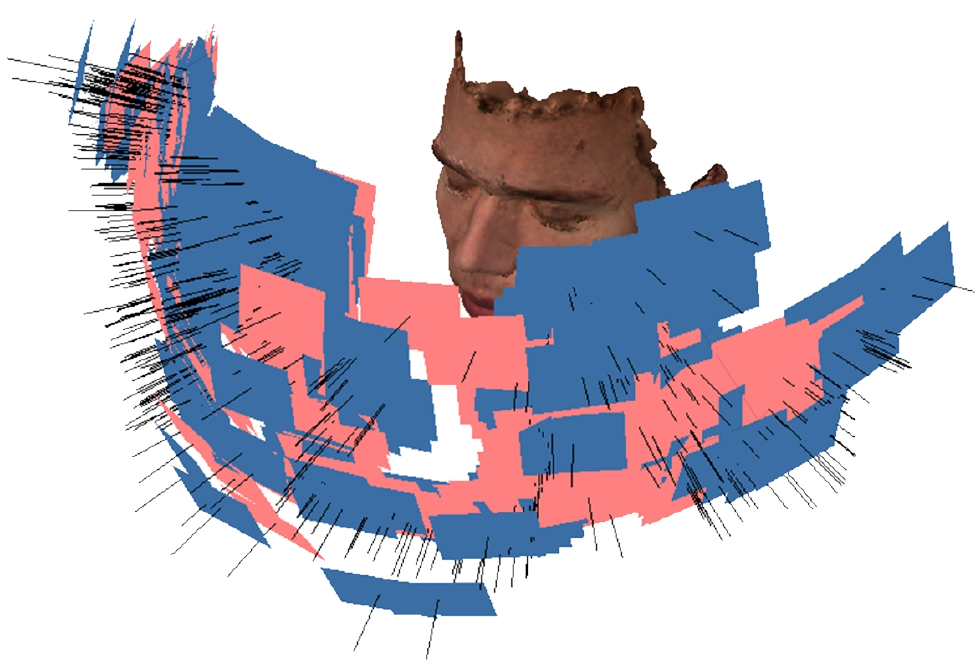
图13|红色为交叉偏振视角,蓝色为平行偏振视角。两组观测覆盖不同方向,并非严格成对、位置完全重合的照片。来源:原论文附录图13。
三、几何先对齐:否则清晰照片也会被贴糊
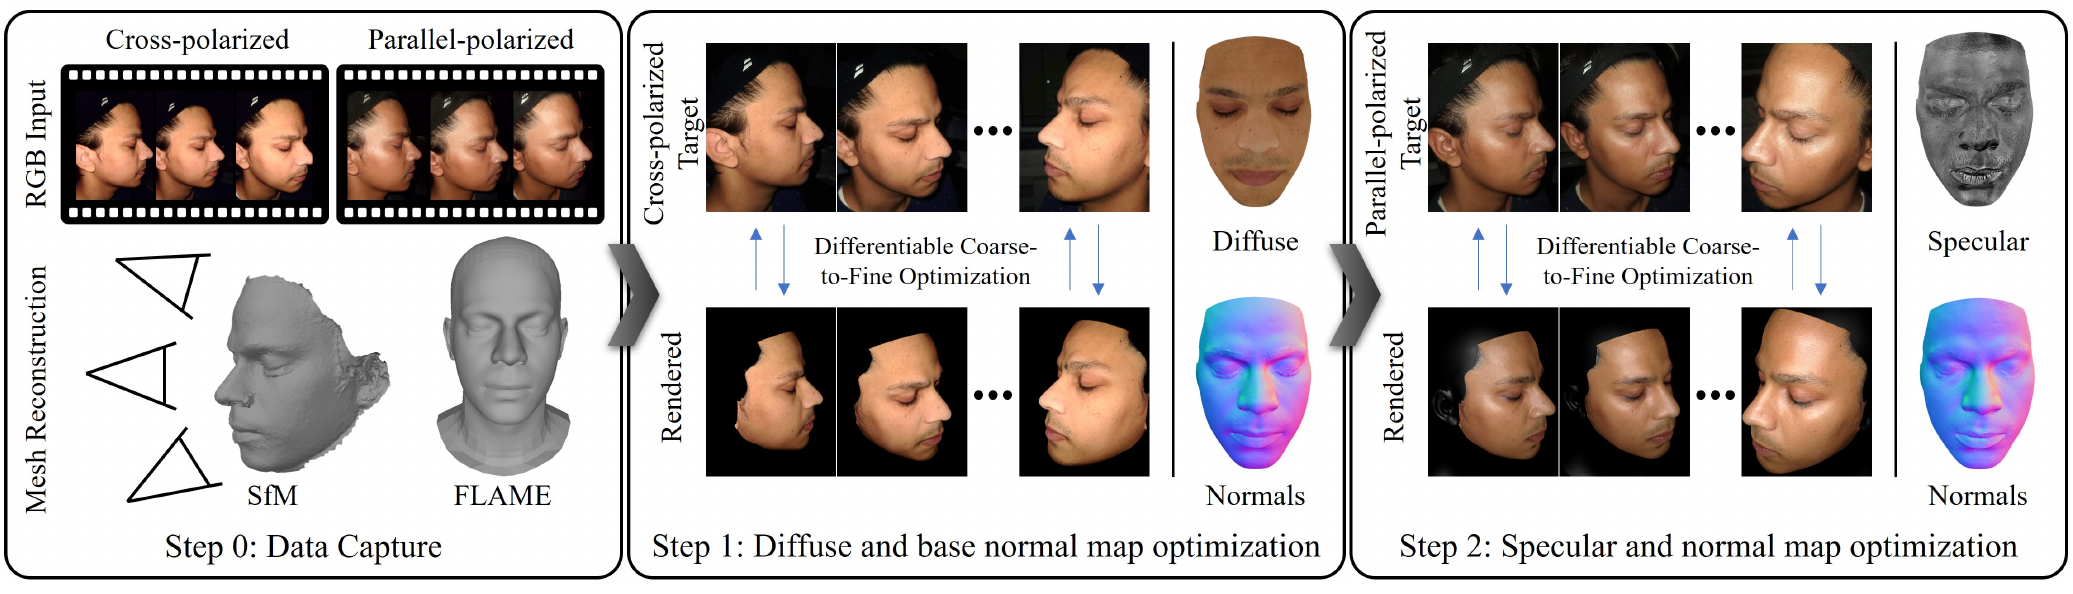
图2|先重建几何并拟合FLAME,再用交叉偏振估计漫反射与初始法线,最后用平行偏振估计镜面增益与最终法线;同时优化全局粗糙度参数。来源:原论文图2。
系统先用Agisoft Metashape对所有选取的数据进行运动恢复结构与多视角立体重建,得到初始网格和相机位姿。面部掩码有助于减少背景对求解的干扰。
直接使用扫描网格仍可能存在噪声和孔洞。作者因此拟合FLAME参数化人头模型,先调整形状和整体对齐,再通过非刚性变形细化,使模型贴近扫描。
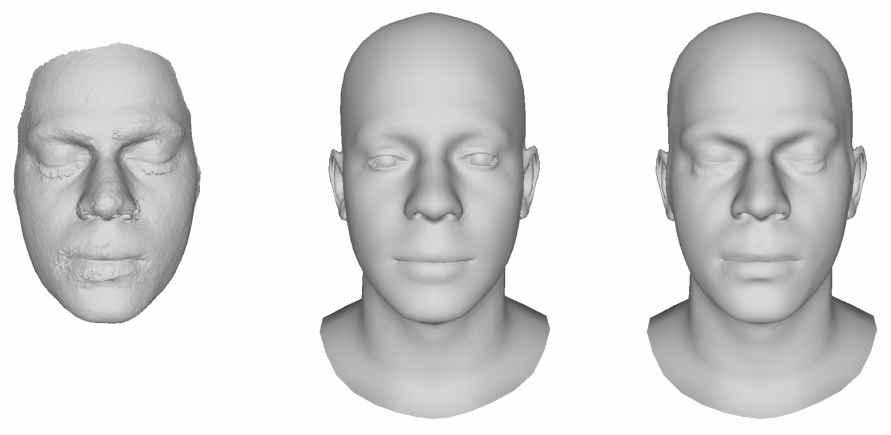
图4|从左到右为初始重建、拟合的FLAME模型和进一步细化的网格。来源:原论文图4。
附录进一步说明:系统用面部关键点初始化三维对齐,随后优化刚性变换与FLAME形状参数;对面部区域进行细分,移除眼球部分,再用ARAP非刚性变形改善贴合。
这一步不仅是为了脸型好看,还决定各张照片能否落到正确的纹理位置。如果同一条细纹在不同视角中投到不同位置,优化就会把它们平均成较模糊的结果。
FLAME还提供一致的UV参数化。UV相当于三维皮肤表面的一张二维地图,后续漫反射、镜面增益与法线都在这张地图上优化。
四、相机与闪光灯共位:怎样把光照问题变简单?
一般逆渲染需要同时处理相机方向、光源方向和复杂环境光。手机闪光灯靠近镜头,作者将两者近似为共位,于是表面点指向相机和指向光源的方向可以用同一个向量表示:
$$ \boldsymbol\omega_i=\boldsymbol\omega_o=\boldsymbol\omega. $$
再假设暗室中主要只有这一点光源,原论文式(1)将出射辐亮度写为:
$$ L_o(\mathbf{ x },\boldsymbol\omega) =\frac{f(\mathbf{ x },\boldsymbol\omega) (\mathbf{ n }^\top\boldsymbol\omega) L_i(\mathbf{ x },\boldsymbol\omega)} {\|\mathbf{ x }-\mathbf{ l }\|_2^2}. \tag{1} $$
$\mathbf{ x }$是表面点,$\mathbf{ l }$是光源位置,$\mathbf{ n }$是用于着色的表面法线,$f$描述皮肤反射,$L_i$表示式中采用的光照强度因子。
这条式子可以拆成三个影响:材料怎样反光,表面以多大角度朝向光源,以及表面距离光源有多远。距离平方项使近场闪光照明随距离衰减,点积项描述表面方向对接收光照的影响。
为方便阅读,下文把点积记为:
$$ \mu=\mathbf{ n }^\top\boldsymbol\omega. $$
共位近似的好处,是不必再独立估计每帧复杂的光源方向或环境贴图。不同视角仍能观察到不同法线夹角下的反射变化,为材质和法线提供约束。
但共位不意味着不需要校准,也不意味着所有材质参数都变得唯一可解。后面的偏振分阶段估计、全局参数设置与像素筛选,仍在帮助控制歧义。
五、手机闪光灯不理想,为什么必须先拍一面白墙?
式(1)假设的点光源是一个简化模型。真实闪光灯在不同方向上并不等亮,手机外壳还可能遮挡部分掠射方向的光,相机镜头本身也会影响图像边缘亮度。
如果忽略这些差异,优化器可能把硬件造成的变暗,误写进肤色或法线里。
作者先在白色平面上贴标记,拍摄交叉偏振序列。标记帮助求出相机位姿和三维平面,再利用这组数据估计逐像素衰减图$\mathcal M$。
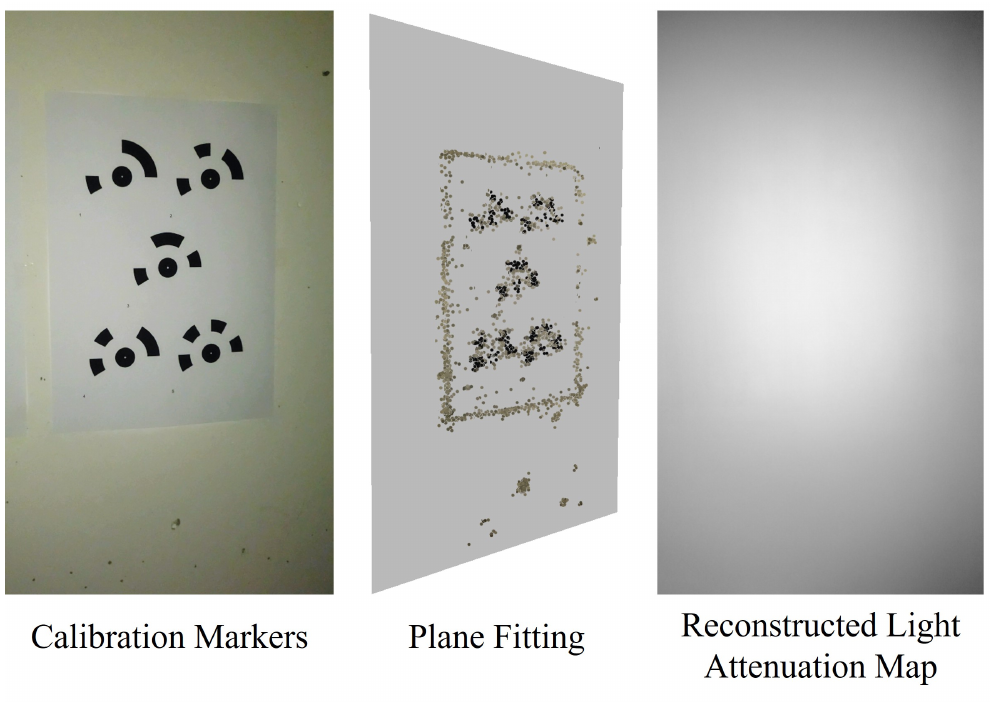
图11|用带标记的白色平面标定手机光照衰减,得到之后所有人脸优化都会使用的衰减图。来源:原论文附录图11。
附录式(7)为:
$$ \underset{\mathcal M,k_d}{\operatorname{argmin}} \left|\hat I-I\right|, \qquad \hat I=\mathcal M\cdot L_o. \tag{7} $$
$I$是标定图像,$\hat I$是带衰减修正的渲染结果,$k_d$是平面漫反射纹理。求出$\mathcal M$后,后续人脸材质优化中保持它固定,而不是让它继续自由吸收皮肤外观误差。
偏振膜还会带来与波长有关的衰减,使两组图像产生不同色偏。作者在两种偏振状态下分别拍摄Macbeth色卡,计算到参考颜色的仿射变换,并用于后续拍摄。
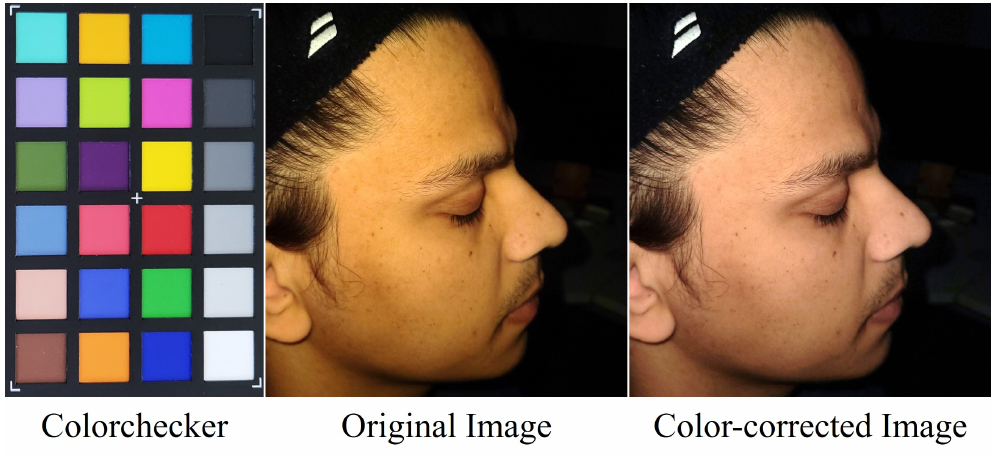
图12|偏振方向改变可能带来颜色偏移,需要分别校准,使两类观测可以在相同颜色基准下参与优化。来源:原论文附录图12。
因此,这套系统的低成本建立在“手机加偏振膜并认真标定”的基础上,不能只保留便宜的硬件,省略校准环节。
六、反射模型:肤色、高光和细节方向怎样配合?
作者将反射模型分成漫反射、镜面反射,并增加一个补偿间接贡献的环境项。下面按它们分别负责什么来读公式。
1. 镜面项:反光强度与高光形状是两件事
原论文式(2)采用Cook–Torrance形式:
$$ f_s(\mathbf{ x },\boldsymbol\omega) =k_s(\mathbf{ x }) \frac{D(\boldsymbol\omega,\mathbf{ n },\alpha) G(\mathbf{ n },\boldsymbol\omega) F(\mathbf{ n },\boldsymbol\omega)} {4(\mathbf{ n }^\top\boldsymbol\omega)^2}. \tag{2} $$
$k_s(\mathbf{ x })$是空间变化的镜面增益,决定各位置镜面分量的强弱;$D$描述微表面方向的分布,影响高光集中还是扩散;$G$描述遮蔽与掩蔽效应;$F$描述菲涅耳效应,也就是反射比例随角度变化。
这里的$\alpha$是全局粗糙度混合参数。作者使用两种Blinn–Phong分布$D_{12}$和$D_{48}$的混合,不是逐像素估计一张任意变化的粗糙度图,也不是直接套用一个GGX粗糙度参数。
共位近似为什么会让分母变成同一个点积的平方?一般微表面反射分母含有入射和出射两个夹角余弦;在这里,两者方向一致,因此相乘得到$\mu^2$。这是对原式的几何解释。
菲涅耳项采用Schlick近似,原论文式(3)为:
$$ F(\mathbf{ n },\boldsymbol\omega) =F_0+(1-F_0)(1-\mu)^5, \qquad F_0=0.04. \tag{3} $$
正面观察时$\mu$接近1,反射项接近$F_0$;越接近掠射方向,菲涅耳项越大。因此,同一块皮肤在不同观察角度下的亮度变化,不能全部归结为其镜面增益改变。
2. 漫反射项:不能只用一个与角度无关的颜色系数
论文采用Ashikhmin–Shirley漫反射形式。原论文式(4)为:
$$ f_d(\mathbf{ x },\boldsymbol\omega) =\frac{28k_d(\mathbf{ x })}{23\pi}(1-F_0) \left[1-\left(1-\frac{\mu}{2}\right)^5\right]^2. \tag{4} $$
$k_d(\mathbf{ x })$是要恢复的漫反射反照率。其余因子使漫反射响应也随角度变化,体现光进入皮肤前后受到表面反射影响的近似。
如果只使用简单Lambertian模型,漫反射BRDF不随方向变化,那么一些实际存在的角度差异就可能被优化器错误地分配给肤色或法线。图8的消融会验证这个问题。
式(4)的作用是提供可用于优化的皮肤漫反射近似,并没有显式模拟光在皮下传播、从邻近位置出射的完整路径。因此不能把它等同于已经恢复了皮肤的生物物理散射参数。
3. 环境项:吸收残余贡献,但限制它不要抢走肤色
暗室也不意味着完全没有间接光。光可以从环境或人脸其他位置反弹回来,尤其会影响某些掠射区域。
原论文式(5)增加一个经过菲涅耳调制的环境项:
$$ f_a(\mathbf{ x },\boldsymbol\omega) =k_a(\mathbf{ x }) \left\{1-(1-F_0) \left[1-\left(1-\frac{\mu}{2}\right)^5\right]^2\right\}. \tag{5} $$
$k_a$是环境补偿图。作者用总变分约束使其平滑,并使其接近零,避免这个自由量把过多细节和颜色都吸收进去。
这是一种补偿,不是完整全局光照求解。它改善渲染与观测的一致性,同时仍保留了模型近似带来的局限。
七、为什么要分两阶段,而不是把全部参数一起调?
假设直接用带高光照片,同时优化肤色、高光强度和法线。一个亮斑可以被解释为镜面反射,也可以被错误地涂进漫反射图;一条明暗变化可以来自方向,也可以来自颜色。
作者用交叉偏振观测先限制这个自由度。
第一阶段只使用交叉偏振照片,将镜面项设为零,优化漫反射反照率和初始切线空间法线图。这里设$f_s=0$是反射分离近似,不能理解为真实皮肤没有任何镜面反射。
第二阶段固定漫反射纹理,再使用平行偏振照片优化镜面增益、全局粗糙度混合参数和最终法线。同时为漫反射加入按颜色通道的缩放因子,补偿两种偏振设置可能产生的透光差异。
这是一种有条件的联合细化:第二阶段仍然会同时调整多个量,但最容易被高光污染的漫反射纹理,已经先用另一类观测确定。
法线图会改变渲染使用的局部表面方向,让毛孔和细纹产生更细腻的明暗;它没有自动把这些细节全部变成基础网格上的可测量凹凸。
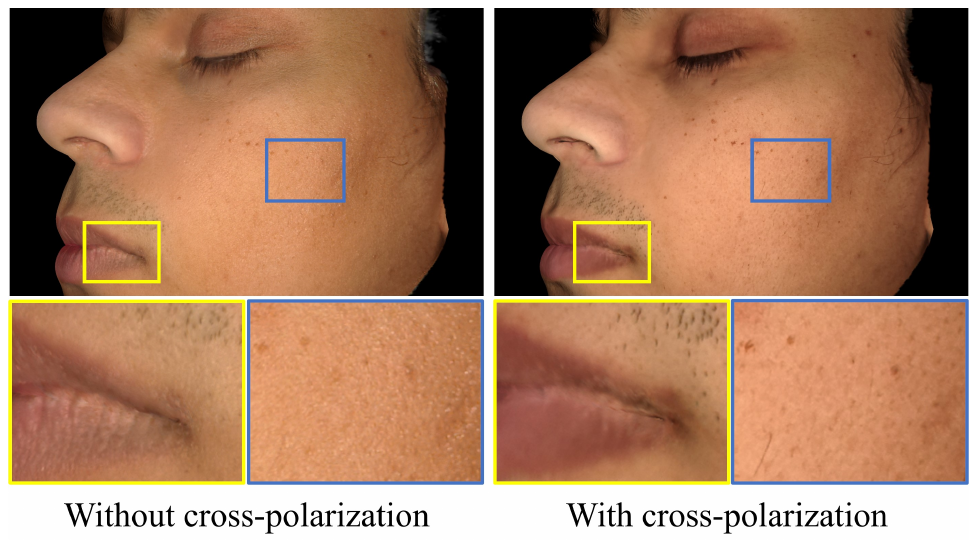
图9|只看漫反射渲染时,全部纹理一起优化会把高光和法线信息泄漏进肤色;两阶段偏振优化得到的漫反射更干净。来源:原论文图9。
这张图对应了偏振的实际价值:不只是让输入照片少一点反光,而是让不同反射成分在优化之前就获得不同的约束。
八、优化目标与mip权重:为什么有些像素应少说话?
整个流程采用analysis-by-synthesis,也就是用当前参数渲染,再比较渲染图与真实图,反向调整参数。
原论文式(6)为:
$$ \mathcal L(\hat I,I) =\left|W\cdot(\hat I-I)\right|, \qquad \hat I=\mathcal M\cdot L_o. \tag{6} $$
$I$是校色后的目标照片,$\hat I$是带硬件衰减修正的渲染,$W$是逐像素权重。权重回答的是一个实际问题:同样一个照片像素,能不能同样可靠地约束4K纹理?
远处的人脸在照片中占的像素少,一个像素会覆盖较大的皮肤区域。掠射视角也会使表面在图像中被压缩。把这类观测与正面近距离照片等量使用,就可能把清晰纹理平均糊。
作者借用mipmapping的尺度概念,计算每个照片像素对应的UV纹理覆盖范围,得到应查询的mip层级$\ell$。按原文文字,权重为:
$$ W= \begin{cases} \mu(1-\ell), & \ell<1,\\ 0, & \ell\ge1. \end{cases} $$
这个分段写法是对原文权重规则的整理,不是新增的论文编号公式。$\mu$降低掠射观测的贡献,mip条件排除相对于当前纹理尺度过于粗糙的观测。
但如果一开始就只优化4K,很多远距离观测都难以有效提供细节。系统因此采用四级粗到细策略:
$$ 512^2\ \rightarrow\ 1024^2\ \rightarrow\ 2048^2\ \rightarrow\ 4096^2. $$
先在较低分辨率确定大范围颜色与响应,再逐级增加分辨率,让足够清晰的观测约束新增细节。两阶段优化都采用这一过程。
高分辨率不是只把输出画布放大,还要判断每张照片究竟能支持哪一层细节。
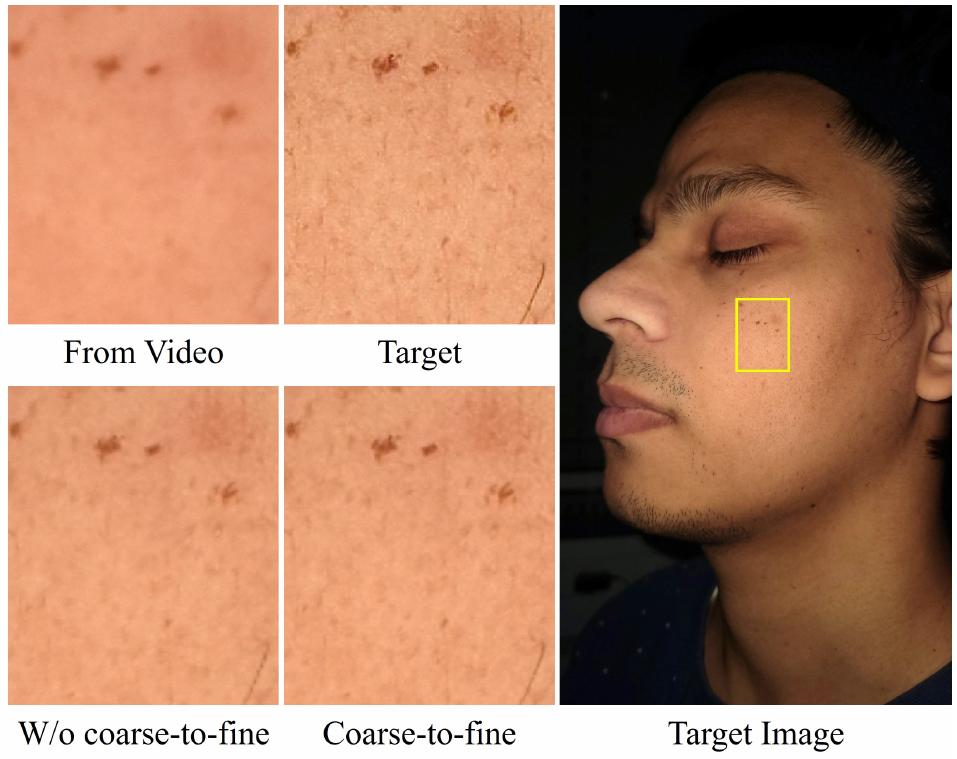
图10|使用照片相比只用视频帧保留更多细节,粗到细与合适mip权重进一步改善清晰度。来源:原论文图10。
该实验也解释了前面为什么额外拍照片。输入中已经缺少的高频,不能仅靠把最终纹理设为4K来补回。
九、真实结果:高分辨率外观分别保存了什么?
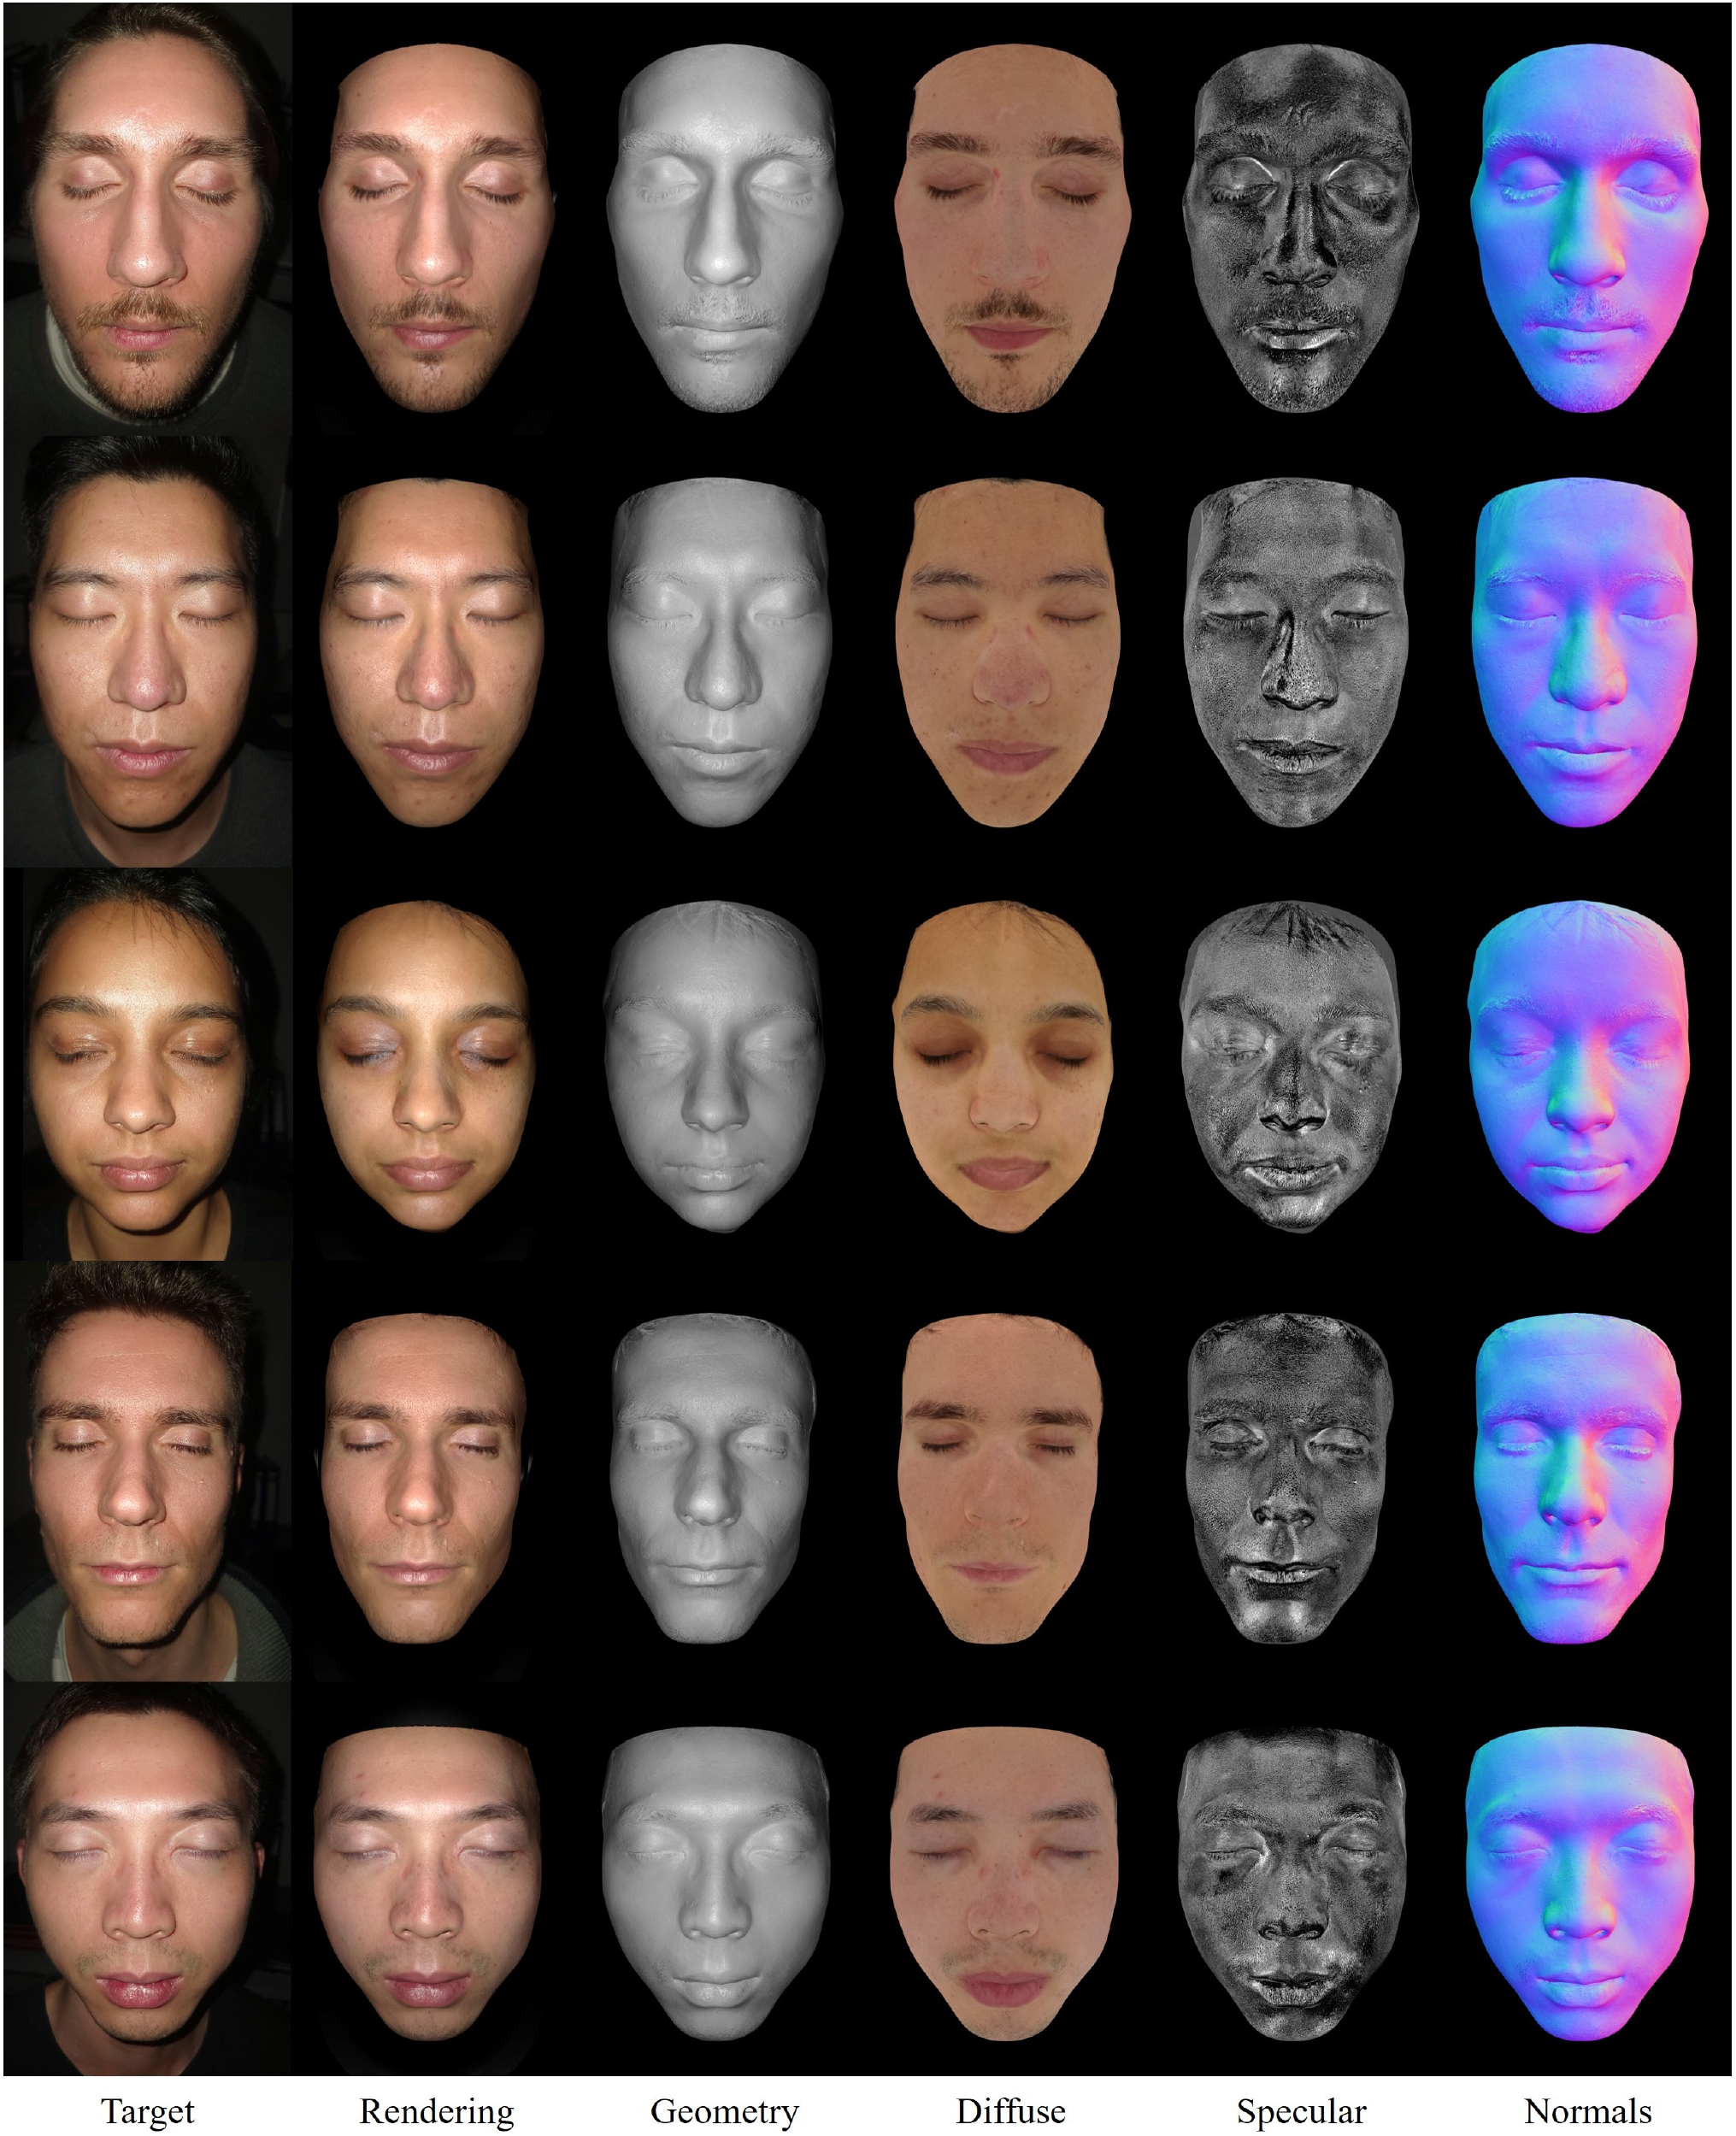
图5|从左到右为目标照片、渲染、基础几何、漫反射反照率、镜面增益与法线。来源:原论文图5。
漫反射图主要承载肤色与色素等变化,不应把固定光源的高光直接画在上面。镜面增益图描述不同区域反光强弱;法线图描述局部方向,使皮肤在光源移动后出现相应细节。
这里三种贴图具有不同含义,不能把它们的灰度与颜色都当成同一种“皮肤纹理”。尤其是镜面增益,不等于毛孔深度;法线方向变化,也不等于已知尺度的表面位移。
作者展示了不同肤色与皮肤特征的样例。渲染能够较好贴近目标,高光与漫反射也有明显分离。这支持方法用于皮肤外观资产构建,但仍需要通过新视角和新光照测试,判断是否只拟合了已见照片。
十、定量结果:验证的是留出照片,不是所有照明环境
作者在优化时留出验证帧,在10名受试者上比较图像指标。结果如下:
| 方法 | PSNR ↑ | SSIM ↑ | LPIPS ↓ |
|---|---|---|---|
| Neural Light Transport(NLT) | 31.51 | 0.96 | 0.11 |
| NextFace | 22.85 | 0.89 | 0.31 |
| 本文 | 32.37 | 0.96 | 0.10 |
数值来源:原论文表1。SSIM按报告精度并列;PSNR越高、LPIPS越低越好。
本文相对NLT的PSNR提高0.86 dB,LPIPS降低0.01;SSIM在表中的精度下相同。它支持留出图像上的渲染质量优势,不能读成每个指标都严格更好。
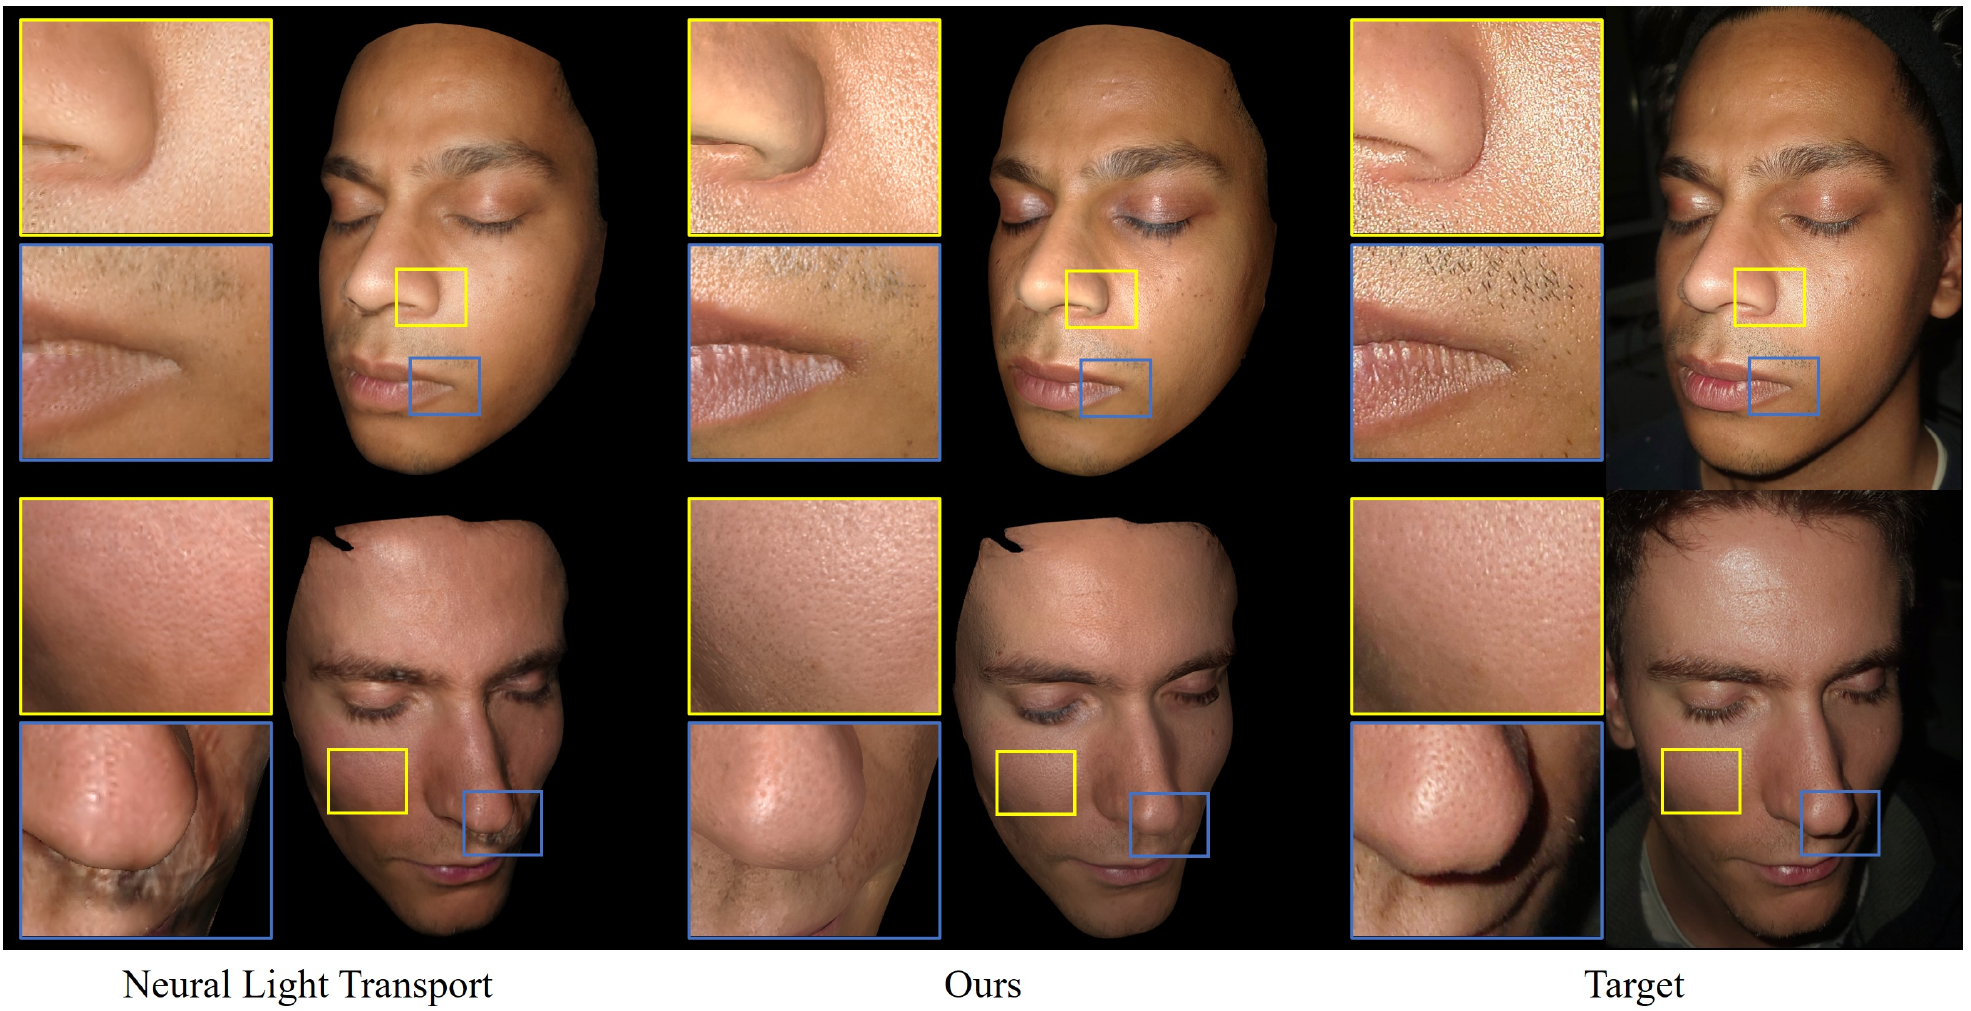
图6|验证帧未参与优化,局部比较显示本文更清晰的皮肤纹理与高光。来源:原论文图6。
需要注意采集条件:训练与验证照片都来自手机闪光灯随相机移动的场景。留出视角同时带来新的光源位置,但仍属于这一共位采集设置。表1没有为任意HDR环境或完全独立的光源运动给出同样的定量真值验证。
NLT的比较也做了特定处理:由于该方法没有直接建模文中光强与衰减,作者先优化其验证渲染亮度,再计算误差。因此不能把差异简单归因于一个方法亮度正确、另一个亮度错误。
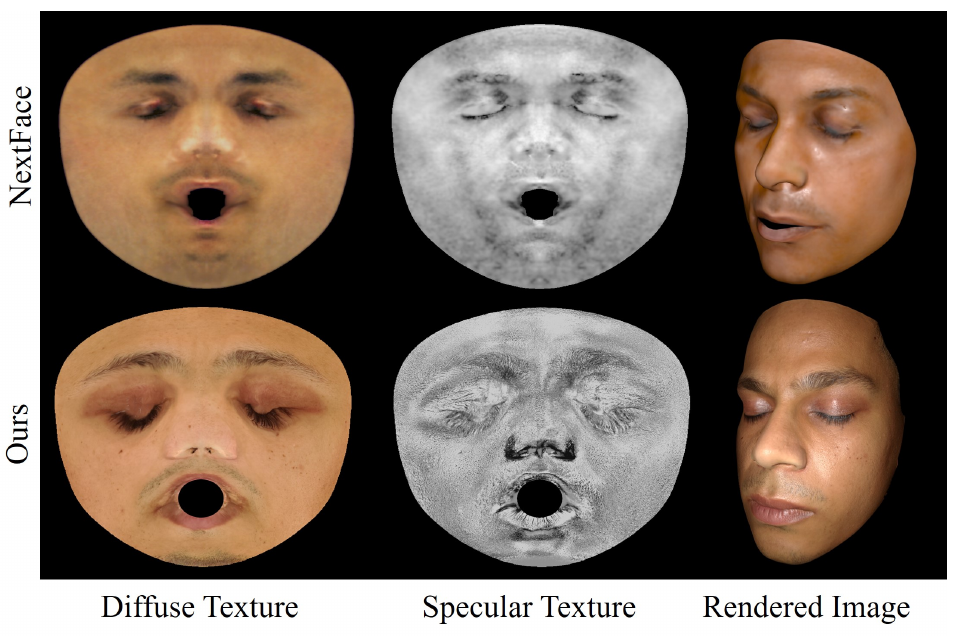
图7|本文与NextFace的外观贴图比较。几何贴合、输入照明和反射分解都会影响纹理清晰度。来源:原论文图7。
NextFace部分经过多种输入与照明配置尝试,包括替换照明模型。作者报告最佳结果来自均匀照明下覆盖人脸的3帧,并指出模型拟合偏差会使纹理变糊。
因此,这组比较既包含算法能力,也包含各自适用的采集与拟合条件,不能概括成所有方法都在完全相同的输入协议下测试。
十一、物理模型的消融:细节不是只靠更多参数堆出来的
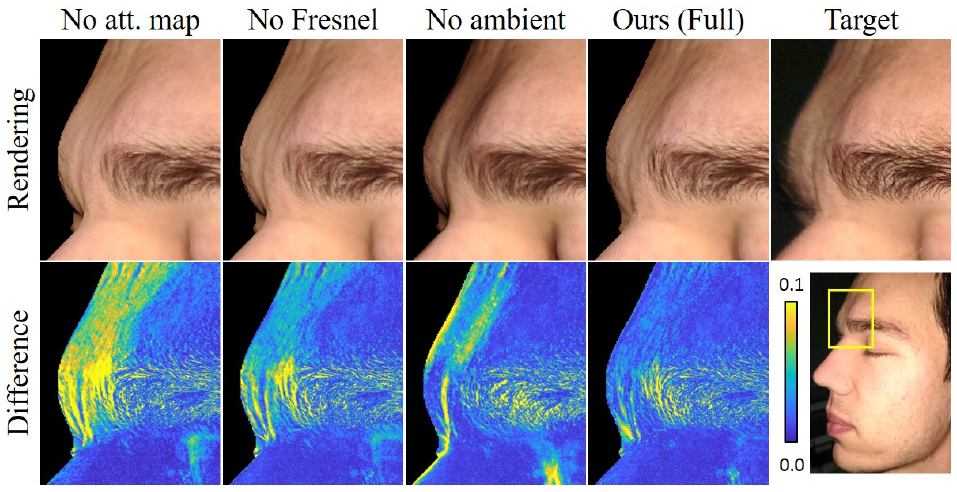
图8|忽略方向相关闪光衰减、菲涅耳效应或环境贡献,会降低跨视角重现能力。来源:原论文图8。
这组消融与前面的公式逐项对应。
不校正闪光衰减,硬件造成的亮度变化就容易进入材质。用简单Lambertian漫反射替代式(4),会缺少实际皮肤的角度响应。去掉环境项,一些无法由直接光解释的残余贡献就可能被其他参数错误吸收。
配合图9和图10,可以看到系统的效果并非只来自优化更多纹理像素:偏振帮助分反射,物理近似帮助解释方向变化,标定帮助排除硬件偏差,mip权重则限制不够清晰的观测对细节的影响。
这些设计共同减少了“图像拟合得不错,但错误成分被写进错误贴图”的风险。
十二、重新打光与皮下散射:能用SSS,不等于测出了BSSRDF
论文将网格与贴图导入Blender,在新的照明下渲染,还展示了加入次表面散射的效果。
这说明输出不是只能由某个专用神经网络播放的图像,而是可以进入常规资产制作流程、进一步编辑与渲染的材质和几何。
不过,优化阶段使用的是简化漫反射模型。论文解释,生产级散射着色器可以从漫反射反照率出发,通过反照率反演等步骤构造体散射所需参数,从而使用这些贴图。
因此,SSS展示证明了资产与相应渲染流程的兼容性,并不等于采集阶段已经独立恢复皮肤各层的吸收、散射或完整BSSRDF参数。
这一点也有助于区分不同研究任务:有的方法重点测量皮肤内部传播,有的方法重点获得可编辑外观资产,而这篇主要属于后者。
十三、成本与限制:便宜的是采集设备,不是全部计算
原文报告,完整重建约2.5小时,包括约1小时多视角几何重建和约90分钟光度纹理优化。后者在NVIDIA RTX A6000上运行,当纹理为4096×4096、目标图像为3840×2160时,需要约30GB显存。
这是一套把采集端简化为手机的离线方法,不能写成手机实时重建或普通设备几分钟即可完成全部处理。
当前系统也只恢复静态人脸的皮肤区域。它要求闭眼、闭口,不处理眼球、口腔内部与头发;动态变化的表情和纹理仍是后续研究方向。两次偏振采集之间的表情变化,也会增加对应与优化的困难。
此外,全局粗糙度混合参数限制了空间变化材质的表达,环境补偿图不能替代完整全局光照,眼周凹陷等区域仍可能需要更准确的光传输模型。
十四、这篇工作的启发:先让观测可分,再让结果清晰
PolFace把专业采集中常用的偏振思路,放进了手机相机与闪光灯的组合里。但真正使它成为一套方法的,是后面连续的处理:校准设备、对齐几何、分阶段恢复反射,再按观测尺度逐步细化纹理。
对于高精度人脸研究,它展示了一条很具体的路径:先通过物理采集给肤色与高光提供不同约束,再用材质模型和多视角数据恢复局部方向。这样得到的高频,更容易解释其来自哪类反射信息。
与此同时,4K贴图中的细节、可重打光的真实感与有尺度的微细几何精度,仍然是不同的评价目标。前两者在本文中已有相应展示与图像验证;如果要进一步走向毛孔级几何,还需要把局部方向与空间表面一致地联系起来,并引入独立的几何参考进行验证。
