
 洗子
 匿名

用手机拍一段人脸视频,已经能生成不少看起来相当逼真的三维头像。但如果把这个头像搬进另一间屋子,再从侧面打一束光,问题就容易暴露:额头上的亮斑可能还留在原来的位置,眼睛像蒙了一层灰,头发和嘴巴内部也未必完整。
原因在于,相机记录下来的颜色,同时混合了脸的形状、皮肤与眼球的材质,以及拍摄时的照明。想得到一个能在新环境里自然接受光照的数字人,就得把这些因素尽可能分开。
清华大学的这篇 CVPR2024 论文提出了 CoRA。它以一段在较暗室内拍摄的手机闪光灯视频为输入,恢复人脸几何与反射属性,并导出可以放进 Blender 的三维资产。皮肤、头发、口腔内部和眼球,都纳入同一个重建流程。理解这篇论文,可以抓住两个具体问题:怎样让眼睛在换光后仍然像眼睛?怎样从没有偏振分离的普通图像中,估计皮肤自身的颜色和高光属性?
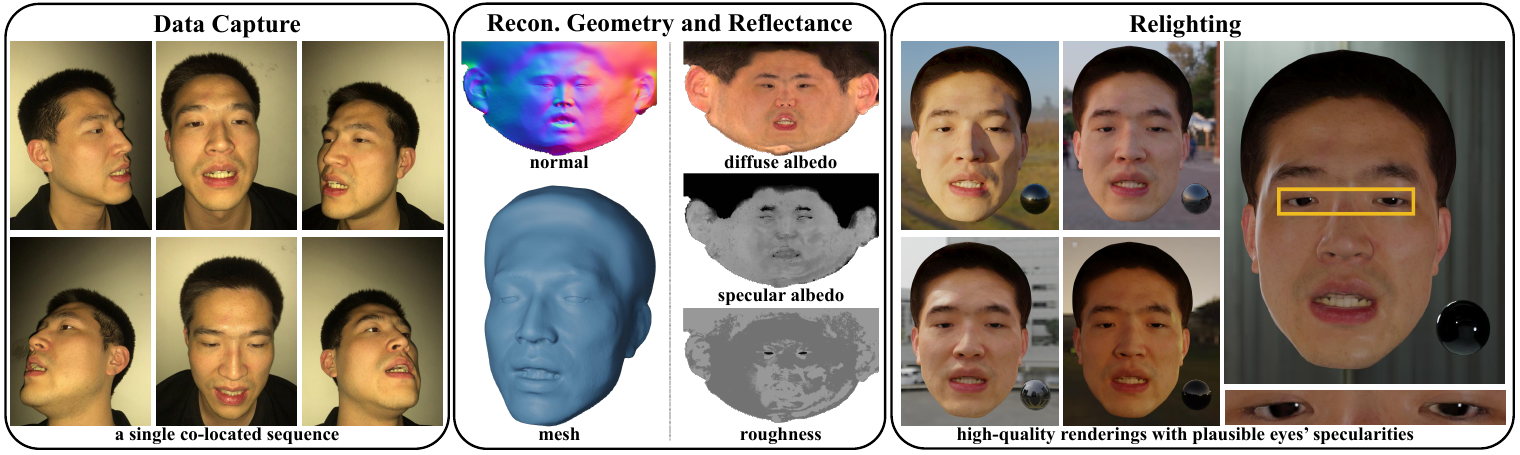
图1|论文整体效果,来源:原论文图1。左侧为不同视角的采集图像;中间为网格、法线和材质贴图;右侧为新环境中的重打光结果。黄色框强调眼部高光。
图1中最值得留意的是中间那几张分开的贴图。它们分别描述脸的形状、底色、镜面反射强度与粗糙程度。右侧换光后的结果,依赖的就是这些属性能否被合理恢复。
论文信息
| 项目 | 内容 |
|---|---|
| 英文标题 | High-Quality Facial Geometry and Appearance Capture at Home |
| 中文标题 | 居家高质量人脸几何与外观采集 |
| 作者 | Yuxuan Han、Junfeng Lyu、Feng Xu |
| 机构 | 清华大学软件学院、北京信息科学与技术国家研究中心(BNRist) |
| 项目主页 | https://yxuhan.github.io/CoRA/index.html |
| 代码 | https://github.com/yxuhan/CoRA |
| 关键词 | 人脸重建、逆渲染、神经隐式表面、混合表示、反射属性分离、重打光 |
一、让一张脸接受新光照,需要恢复哪些东西?
设想拍摄额头上的一个小亮点。它可能来自皮肤本身较浅的颜色,也可能来自闪光灯恰好被表面反射进了镜头。单看一个像素,这两种情况都只是“亮”。如果把亮点直接画进纹理,换一盏灯之后它仍会留在额头上,仿佛成了皮肤的一部分。
所以,论文要恢复的“外观”包含有物理含义的材质参数。漫反射反照率描述表面的底色;镜面反射反照率控制镜面反射分量的强度;粗糙度影响高光的集中或扩散。另一个关键量是法线,也就是表面局部朝向。同一块材质,朝向不同,接收到的光和反射到相机的光也会不同。
把这些未知量放进一个渲染器,算出模型应该呈现的图像,再与实拍图像比较,就能反过来调整形状和材质。这个过程叫逆渲染。它的困难是,多种不同的形状、材质与光照组合,都可能解释同一张照片。
专业的 Light Stage 会用大量可控灯光、相机和偏振采集装置,增加观测条件,缓解这种歧义。居家采集拿掉了许多硬件,也就必须用更合适的拍摄方式和模型约束来补充信息。
在 CoRA 之前,PolFace 已经利用手机闪光灯与偏振采集恢复高分辨率人脸外观;SunStage 则利用太阳光与自拍视频。CoRA 的切入点,是进一步降低采集要求,并把眼球等区域纳入完整的人脸资产。它延续了主动光照和逆渲染的思路,同时调整了表示方式与训练约束。
二、为什么要开着手机闪光灯,绕着脸拍?
CoRA 使用 iPhone X,在较暗的房间里拍摄约 25 秒的视频,处理前将图像缩放到 $960\times720$,再标定每帧的相机参数。拍摄时,相机与闪光灯一起围绕被摄者移动,被摄者保持一个固定表情。
这个设置的作用,是让主要光源的位置变得容易描述。手机闪光灯紧邻镜头,论文近似认为二者处于同一位置。于是,从脸上某一点看过去,指向相机的方向与指向光源的方向近似相同。相机移动时,光源也以已知的方式移动。
闪光灯还提供了比较集中的照明。这里所谓“高频光照”,指光照在方向空间中的变化比较集中、尖锐,例如点光源和太阳光;它与视频帧率无关。相比均匀柔和的环境光,这种照明通常能为法线和高光形状提供更明显的线索。
房间可以留有少量环境光。作者把它作为低频照明另行估计,而不是假设视频只包含闪光灯贡献。相机与光源接近的位置关系,也使主要由闪光灯产生、且能被相机看见的投影阴影较少,从而降低优化难度。环境遮挡、反射和间接光照并没有因此全部消失。
采集条件简化之后,接下来需要决定:这张完整的人脸,应该在计算机里用什么形式表示?
三、皮肤和眼球,为什么要分开建模?
皮肤、鼻子、嘴唇和头发具有复杂的个体形状,让模型自由调整比较合适。眼球则有一个特别强的几何先验:整体形状接近球体,同时表面高度反光。把两者都交给完全自由的神经场,未必是最有效的选择。
眼睛的难点在于,高光会随着观察方向移动。如果模型不能准确区分“表面真的长这样”与“这里只是反射出一个亮点”,就可能用错误的眼球形状解释图像。即便最后的照片拟合得像,换一盏灯,错误几何产生的反射仍会暴露问题。
CoRA 将人脸划分为眼球区域 $E$ 和其他区域 $S$。这里的 $S$ 包括皮肤、头发和口腔内部,不能简单理解成“皮肤”。两类区域组成完整人脸 $F=E\cup S$。[1,§3.2]
对 $S$,模型用两个神经场:一个预测几何,一个预测材质。输入都是三维点的位置 $\mathbf{ x }\in\mathbb{R}^{3}$。几何场 $f_{sdf}$ 输出一个有符号距离值;材质场 $f_{brdf}$ 输出 RGB 漫反射反照率 $c\in\mathbb{R}^{3}$、标量镜面反射反照率 $s_S$ 和标量粗糙度 $\rho_S$。在这一简化材质模型中,一个三维位置对应的材质输出一共是 5 个数。
有符号距离函数(SDF)可以理解成给空间中每个点标注“距离表面多远”。通常约定,物体外部为正,内部为负,表面为零。模型学到这个函数之后,就可以从零值附近提取表面。
对眼球,作者直接放置两个具有相同半径的球形网格,并预设镜面反射强度 $s_E$ 与粗糙度 $\rho_E$。眼球随位置变化的底色,仍由材质场学习。因此,眼睛的外观并没有被统一涂成一种颜色。
这里需要区分“减少未知量”和“自动恢复所有眼球参数”。在本文解读的会议版中,左右眼球的位置和共同半径由人工设置。方法利用这些先验提高整个脸的重建合理性,并未声称完成精确的眼球解剖结构测量。
四、一个球形网格,怎样加入神经场的渲染过程?
眼球是显式网格,其余部分是隐式神经场。要让二者在同一条相机射线上共同产生颜色,作者先把眼球也转换成可以查询的距离函数,再统一选择几何与材质。
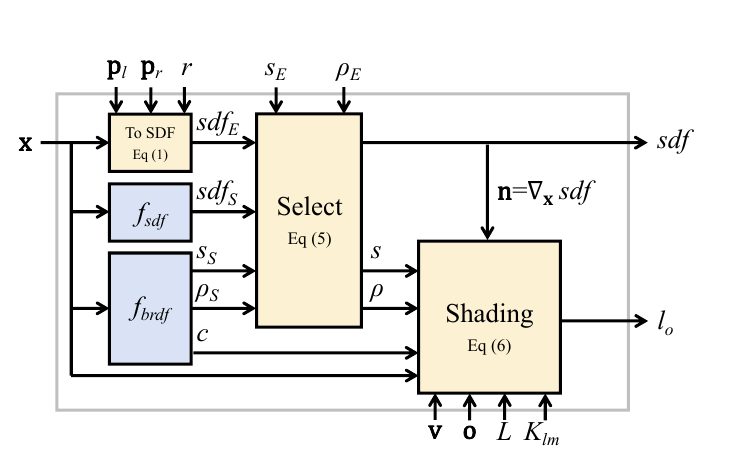
图2|网格感知体渲染,来源:原论文图2。蓝色模块是学习得到的神经场;浅黄色模块执行眼球距离计算、属性选择和物理着色。同一个三维采样点沿不同分支得到几何与材质,最终进入统一渲染。此图从 PDF 重新提取,恢复了素材中缺损的梯度符号。
从球心和半径,到眼球的距离函数
相机射线上的采样点写成 $\mathbf{ x }=\mathbf{o}+t\mathbf{d}$:$\mathbf{o}$ 是相机位置,$\mathbf{d}$ 是射线方向,$t$ 是沿射线的距离。若左右眼球中心为 $\mathbf{p}_l,\mathbf{p}_r$,共同半径为 $r$,原论文式(1)为:
$$ sdf_E=\min\left(\|\mathbf{ x }-\mathbf{p}_l\|_2-r,\;\|\mathbf{ x }-\mathbf{p}_r\|_2-r\right). \tag{1} $$
这个公式可以从球体定义直接理解。点到球心的距离是 $\|\mathbf{ x }-\mathbf{p}\|_2$,减去半径,就得到了带内外符号的球面距离。对两个眼球分别计算,再取较小值,便可表示二者的并集。这里的两个球分别代表左右眼球,不是在估计某种“左右眼特征融合”。
其余区域的距离 $sdf_S$ 由神经场给出。接下来,论文用同一个选择规则处理几何与镜面材质:
$$ s=\operatorname{select}(s_E,s_S;sdf_E,sdf_S),\tag{2} $$
$$ \rho=\operatorname{select}(\rho_E,\rho_S;sdf_E,sdf_S),\tag{3} $$
$$ sdf=\operatorname{select}(sdf_E,sdf_S;sdf_E,sdf_S),\tag{4} $$
$$ \operatorname{select}(*_E,*_S;sdf_E,sdf_S)= \begin{cases} *_E,&sdf_E\le sdf_S,\\ *_S,&sdf_E>sdf_S. \end{cases}\tag{5} $$
星号只是“待选择的属性”的占位符。当前采样点由眼球分支主导,就采用眼球的几何与镜面材质;由另一分支主导,就采用神经场的对应输出。式(4)因此等价于 $sdf=\min(sdf_E,sdf_S)$。
这是一个按距离比较进行的分支选择,不是把两套材质做平均。它在分支内部可以传播梯度,切换边界则需要按分段函数理解,不能把论文中的“可微”理解成处处光滑。取最小值也是构造隐式并集的常见做法;对一般重叠形状,它不保证处处等于严格的欧氏有符号距离。
表面朝向接着由距离场的梯度给出:$\mathbf{n}=\nabla_{\mathbf{ x }}sdf$。直观上,距离值增加最快的方向,指向表面外侧。在理想 SDF 上,梯度的长度为 1;神经场通过相关正则项尽量维持这种性质。
几何和材质齐了,怎样计算颜色?
CoRA 将采样点的出射颜色拆成闪光灯与环境光两部分。原论文式(6)至(8)为:
$$ l_o=l_{flash}+l_{amb},\tag{6} $$
$$ l_{flash}=\frac{L}{\|\mathbf{ x }-\mathbf{o}\|_2^2} \cdot f_{pbr}(\mathbf{l},\mathbf{v};c,s,\rho) \cdot\max(\mathbf{n}\cdot\mathbf{v},0),\tag{7} $$
$$ l_{amb}=c\cdot\operatorname{SoftPlus} \left(\sum_{l=0}^{2}\sum_{m=-l}^{l}K_{lm}Y_{lm}(\mathbf{n})\right). \tag{8} $$
式(7)的三个因子各有明确作用。$L$ 是预设的 RGB 光源强度;除以距离平方,描述点光源随距离衰减。$f_{pbr}$ 是使用当前材质参数的 Disney 双向反射分布函数(BRDF),描述给定入射和观察方向时的反射响应。最后的点积项描述表面朝向与照明方向的关系,背向光源时将这一贡献截为零。
这里 $\mathbf{v}=-\mathbf{d}$ 指向相机,$\mathbf{l}$ 指向光源。由于二者近似同位置,$\mathbf{l}=\mathbf{v}$,所以论文把余弦项写成 $\mathbf{n}\cdot\mathbf{v}$。
补充推导:同位置照明为何有利于约束高光? 对常见微表面镜面模型,半程方向为 $\mathbf{h}=(\mathbf{l}+\mathbf{v})/\|\mathbf{l}+\mathbf{v}\|_2$。代入单位方向 $\mathbf{l}=\mathbf{v}$,就得到 $\mathbf{h}=\mathbf{v}$。这使镜面响应与表面法线、观察方向之间的关系更明确,也说明错误的眼球朝向为什么会破坏高光。这个等式是帮助理解的基础推导,不是本文新增的损失函数。
式(8)则用二阶球谐函数表示缓慢变化的环境照明。$Y_{lm}$ 是一组关于法线方向的基函数,$K_{lm}$ 是待学习的系数。$l=0,1,2$ 对应的基函数数量为 $1+3+5=9$,每组 RGB 系数用来组合出低频的环境漫反射着色。这里的索引 $l$ 与式(7)的粗体光照方向 $\mathbf{l}$ 含义不同。
SoftPlus 是将数值平滑映射到正数的函数,可写成 $\log(1+e^z)$。它让估计的环境光贡献保持非负。乘上底色 $c$,得到环境光引起的漫反射颜色。这个模型只考虑环境光的漫反射贡献,并不完整描述环境中的尖锐镜面反射。
到这里,每个采样点都有了距离、朝向和颜色。模型沿相机射线进行体渲染,得到一个像素,再与视频中的真实像素比较。[1,§3.3]
补充说明:体渲染怎样把多个采样点变成一个像素? 常见离散写法是 $\hat C=\sum_jT_j\alpha_j l_{o,j}$,其中 $\alpha_j$ 表示第 $j$ 段的不透明度,$T_j=\prod_{q<j}(1-\alpha_q)$ 表示光线到达该段之前仍未被遮挡的比例。前方已有不透明表面时,后方采样点的贡献就会减小。CoRA 采用基于距离场的体渲染框架;这段通用形式用于解释流程,不是原论文新增编号公式。[1;5]
五、模型有了,为什么还需要两种专门的约束?
让渲染图像接近实拍图像,是训练的基本目标。但图像相似,并不保证每个分支都学到了正确内容。眼球与眼皮可能互相“抢”几何,皮肤底色与镜面反射也可能互相补偿。
作者在光度损失、前景掩膜损失、距离场正则和法线平滑约束之外,设计了两个针对性的约束。一个管理区域归属,一个管理反射属性分离。[1,§3.4]
组合损失:让眼球与其他部分各自承担正确区域
只放入两个眼球,并不能保证神经场会自动把眼睛的位置留出来。如果神经场在眼前又生成一层表面,或者眼球穿出眼皮,仅靠 RGB 误差未必能稳定排除这些解释。
因此,作者利用人脸解析网络提供的区域掩膜,监督两类区域各自在图像中应该占据的范围。原论文式(9)为:
$$ \mathcal L_{comp}= \sum_{i=1}^{n}\|\hat O_i^E-O_i^E\|_1+ \sum_{i=1}^{n}\|\hat O_i^S-O_i^S\|_1. \tag{9} $$
$n$ 是本轮采样的相机射线数;$\hat O_i^E,\hat O_i^S$ 是渲染得到、考虑遮挡的区域不透明度;$O_i^E,O_i^S$ 是解析网络给出的目标区域。它们是用于监督的自动生成标签,并非人工精确测量的三维真值。
例如,某条射线在图像中应当看到眼皮,那么“后方放着一个球”不意味着眼球可以占据该像素。考虑遮挡的区域渲染与掩膜监督,促使两个表示在可见图像里形成正确分工。
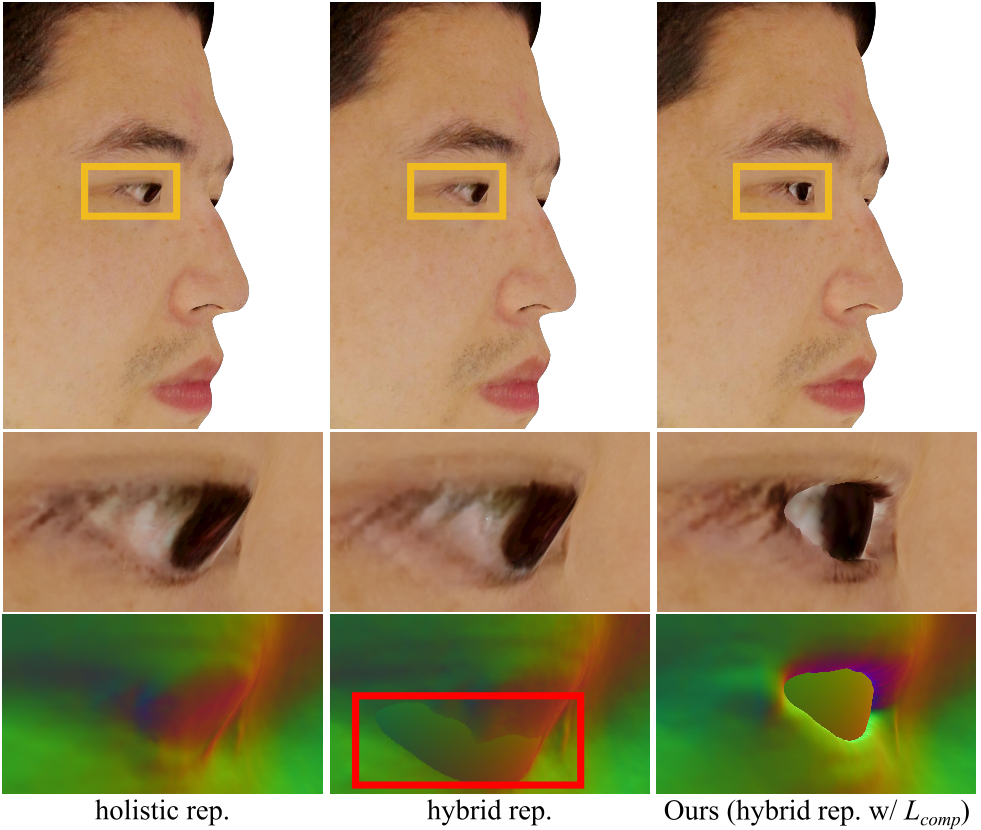
图3|眼部几何消融,来源:原论文图3。左列统一使用神经场;中列加入眼球网格但没有组合损失;右列使用完整方法。第二、三行分别放大纹理与法线,黄色框标出眼部,红框标出中列的异常区域。
图3验证了两个相互依赖的设计:眼球先验提供合理几何,组合损失约束它与其他区域如何拼在一起。只加眼球、不给区域约束,中列仍会出现明显的几何异常。
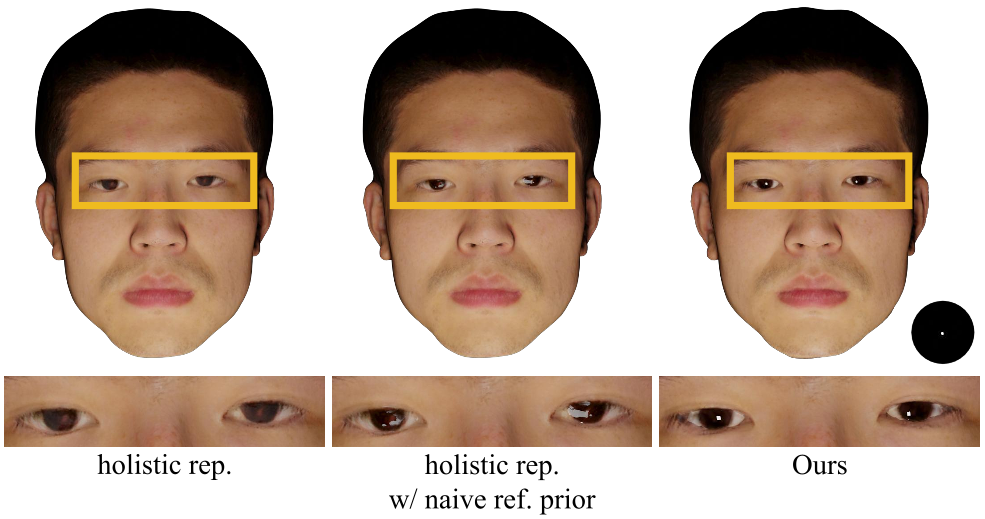
图4|正面点光源下的重打光消融,来源:原论文图4。中列在统一神经场的导出结果上,手工替换眼部镜面参数;右列同时使用眼球几何与反射先验。
图4进一步排除了一个简单解释:能否只在最后给眼睛“加一点反光”?中列确实补了镜面材质,但几何已经出错,高光仍然不自然。因为镜面反射同时依赖材质与法线,前面的几何建模会直接影响后面的换光效果。
反射正则:借助人脸先验,减少底色与高光的混淆
接下来是皮肤材质的问题。没有不同偏振状态的直接分离观测,模型可以把一部分亮度归给底色,也可以归给镜面反射。为了限制这种任意分配,作者借助已有的 AlbedoMM 人脸反照率模型。
AlbedoMM 从专业采集的人脸数据中学习反照率的统计变化。CoRA 在多视角图像上拟合它,将估计的镜面反射反照率扩展到整幅图像,作为伪真值 $I^s$。这给自由度更高的神经材质场提供一个合理范围,而不是要求最终结果永远停留在统计模型的表达空间里。
原论文式(10)为:
$$ \mathcal L_{ref}=\sum_{i=1}^{n}\|k\hat I_i^s-I_i^s\|_1. \tag{10} $$
$\hat I_i^s$ 是当前模型沿射线渲染得到的镜面反射反照率;$I_i^s$ 是统计模型给出的对应伪真值;$k$ 是可学习的标量,用来补偿预设闪光灯强度带来的尺度歧义。注意,这里监督的是镜面材质参数,不是照片中已经包含光照与几何影响的高光图像。
补充推导:为什么需要这个尺度补偿? 对线性的光照模型,材质反射项乘以一个比例、光强除以相同比例,最终亮度可能保持不变。如果光源绝对强度没有被准确测量,恢复出的材质数值就可能与另一套采集系统中的数值相差一个比例。$k$ 给这个比例留下了调整空间,避免把尺度差异全部解释成皮肤材质错误。
眼球已有镜面材质先验,因此不施加这一反射正则。头发则采用一个明确的近似:将镜面反射反照率约束为零。作者发现,在当前模型下给头发拟合镜面反射,会在新环境中产生伪影。这是为稳定重建采取的建模选择,不能据此说真实头发没有镜面反射。
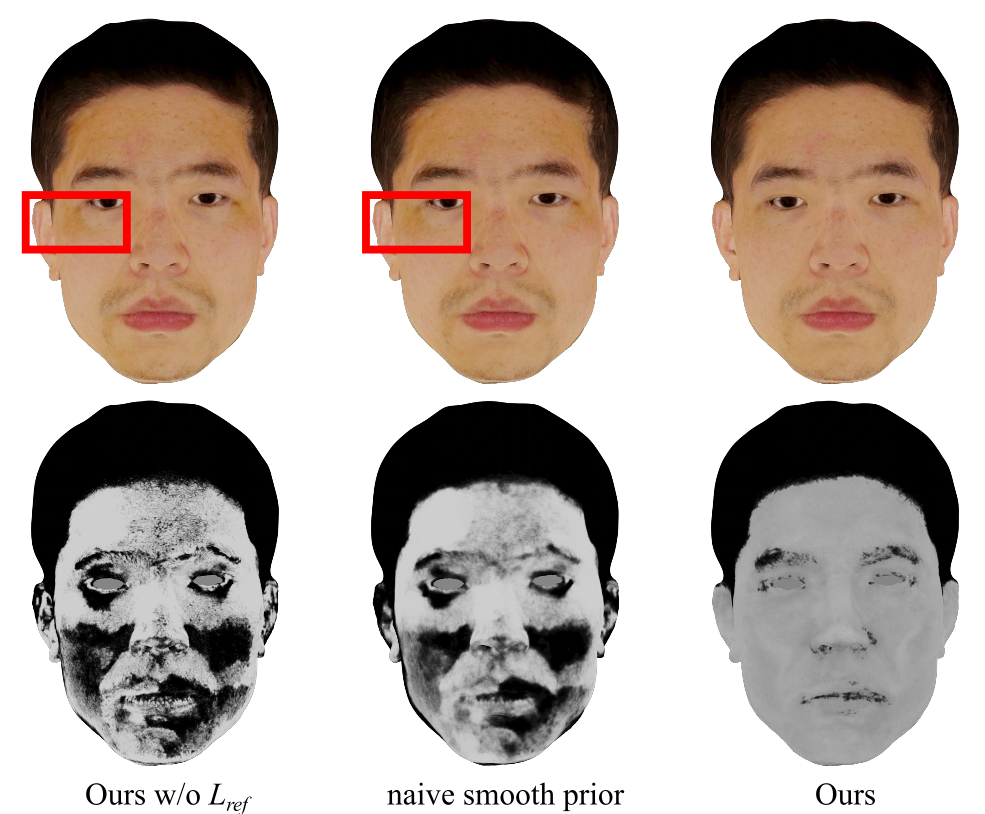
图5|反射正则消融,来源:原论文图5。上行为漫反射反照率,下行为镜面反射反照率;从左到右分别为去掉反射正则、采用朴素平滑先验、完整方法。
图5下排最能说明问题。没有反射先验时,估计的镜面反射反照率出现较强的块状变化;简单平滑能减弱部分波动,却仍可能保留错误的分配。AlbedoMM 提供的是“人脸反射属性通常如何变化”的统计信息,因而比单纯要求附近像素相似更有针对性。不过,这里主要是定性消融,没有独立材质测量误差来证明每个像素都恢复了物理真值。
六、实验结果,究竟证明了多少?
与 NextFace++ 相比:更能拟合个体差异和完整人脸
作者没有直接使用原始 NextFace 作为唯一比较,而是为其加入相同的相机参数与组合光照模型,并引入尺度补偿,形成 NextFace++。这一处理尽量减少相机与光照条件差异,让对比更集中于表示能力。
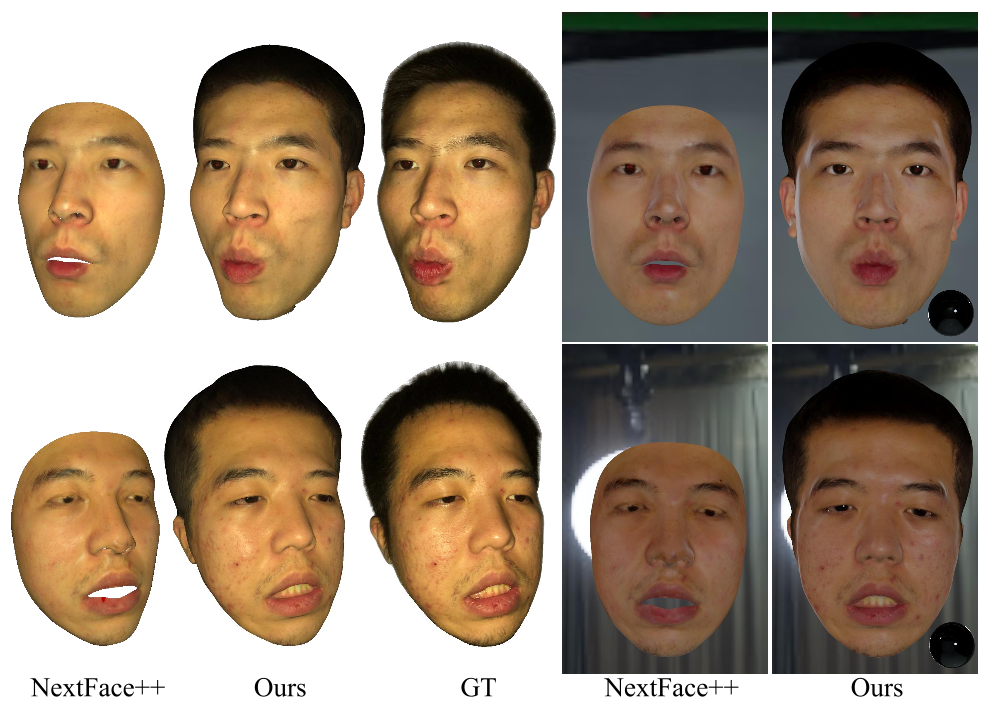
图6|方法对比,来源:原论文图6。左侧比较重建与实拍参考 GT,右侧比较新环境下的重打光。NextFace++ 依赖统计人脸几何,CoRA 的表示覆盖了更多区域和个体形状。
图6中,嘴部、眼部以及头发区域的差别比较明显。NextFace++ 的统计几何空间限制了它对个体形状与非皮肤区域的表达,CoRA 的自由神经表面与眼球先验提供了另一种取舍。
表1|原论文表1的完整数值转写。结果为 5 位受试者的平均值;PSNR、SSIM 越高越好,LPIPS 越低越好。
| 方法 | PSNR ↑ | SSIM ↑ | LPIPS ↓ |
|---|---|---|---|
| NextFace++ | 17.62 | 0.7339 | 0.2727 |
| CoRA | 26.12 | 0.8808 | 0.1642 |
PSNR 反映像素误差,SSIM 关注图像结构相似性,LPIPS 用学习到的图像特征衡量感知差异。三项指标方向一致,说明在这个比较中,CoRA 更接近参考图像。
按表中数值计算,PSNR 增加了 8.50 dB,SSIM 增加 0.1469,LPIPS 减少 0.1085。这些是对原表的算术比较,原文没有给出重复实验方差或显著性检验。
还需要看清测试条件:表1使用同一采集序列中留出的验证图像,评估的是图像重建。它没有直接测量三维表面的毫米误差,也没有单独证明任意新光照下的材质准确性。重建图像更像,是必要证据,但不能独自替代几何和材质的独立评价。
环境光建模:收益取决于环境里有多少光
作者还移除了环境光分支,只保留点光源,比较三个环境中的 PSNR。完整方法相对该基线的增益如下。
| 采集环境 | 加入环境光模型后的 PSNR 增益 |
|---|---|
| 夜间,拉上窗帘 | +0.08 dB |
| 中午,拉上窗帘 | +0.05 dB |
| 中午,打开窗帘 | +0.61 dB |
前两种情况下收益很小;打开窗帘之后增益更明显。这与设计动机吻合:环境光越不能忽略,越需要让模型有一个位置去解释它。三个数字并非严格单调增加,也不能据此宣称所有场景都有同等幅度的提升。
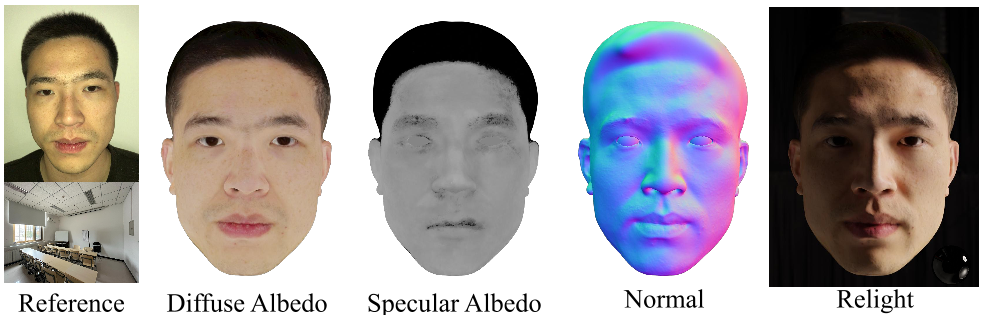
图8|中午打开窗帘时的采集与恢复,来源:原论文图8。最左侧展示视频参考帧与房间环境,随后依次为漫反射反照率、镜面反射反照率、法线和新环境重打光。
图8说明方法在作者展示的较亮室内场景中仍能工作。但它仍建立在闪光灯和低频环境照明的模型上,不能自动推广为对任意复杂照明都鲁棒。
与 Light Stage 相比:还有哪些差距?
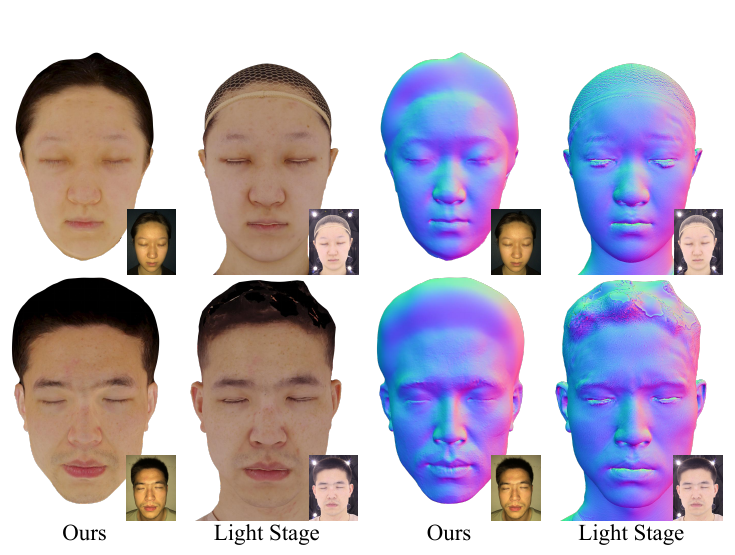
图7|漫反射反照率与法线对比,来源:原论文图7。每组按 CoRA、Light Stage 的顺序展示;小图为各自采集中的正面参考帧。这张图从论文 PDF 补充提取。
图7对这篇工作的定位很关键。作者明确承认,Light Stage 使用偏振滤光片,能更好地分离漫反射与镜面反射,得到更干净的底色;高清单反相机还能保留更高分辨率、包含毛孔级细节的贴图。
CoRA 则受到手机视频画质与约 25 秒采集过程中微小运动的限制。因此,本文的结果应理解为降低居家采集门槛、改善完整人脸资产恢复的实践进展。论文没有提供 CoRA 已达到 Light Stage 毛孔级细节精度的证据。
七、最终得到什么?又能用来做什么?
实现上,作者使用多分辨率哈希网格、基于 SDF 的体渲染和 NerfAcc 加速。论文报告,单张 RTX 3090 可以在 70 分钟内完成训练。这个时间是离线优化开销;约 25 秒是视频采集时间,两者需要分开理解。
训练后导出的资产包括三角网格,以及法线、漫反射反照率、镜面反射反照率和粗糙度等 UV 贴图。UV 可以理解为三维表面与二维纹理之间的对应关系。有了这些标准资产,后续便可以在 Blender 等图形软件中渲染。
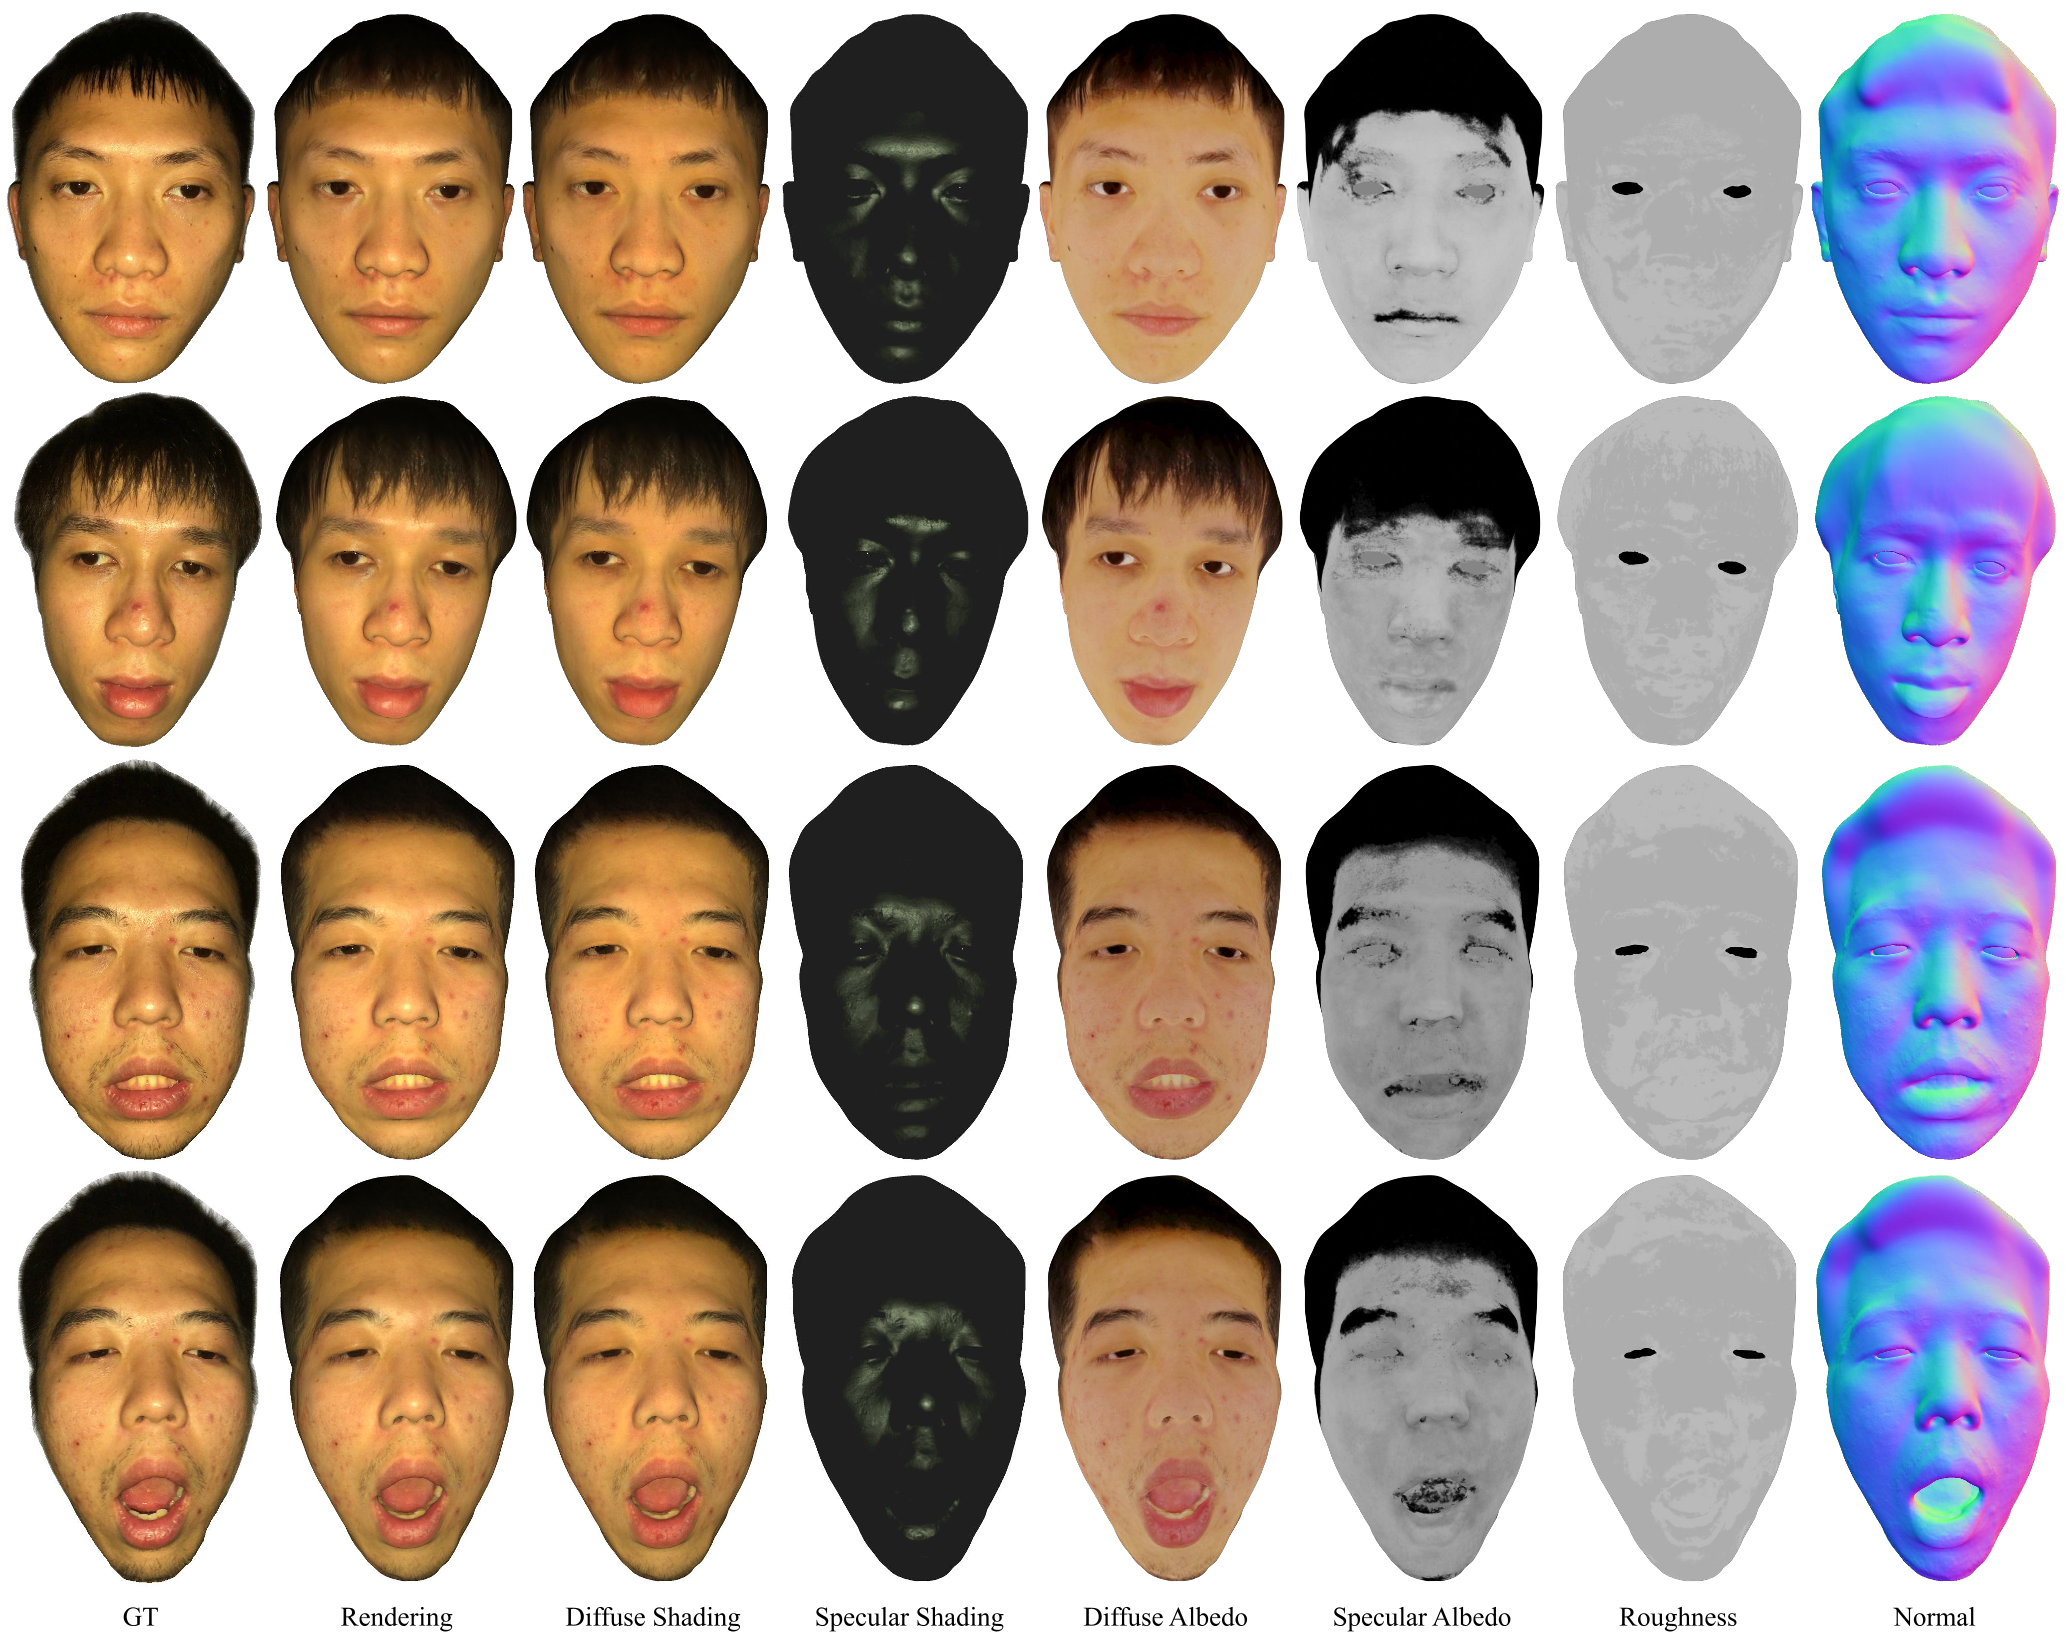
图10|不同人物与表情的采集结果,来源:原论文图10。各列依次为 GT、渲染、漫反射着色、镜面反射着色、漫反射反照率、镜面反射反照率、粗糙度与法线。
阅读图10时,要把“着色”与“反照率”分开。着色列包含光照和表面朝向的影响;反照率列描述估计的材质属性。图中每行对应一次人物与表情状态的恢复,不能将它理解成模型已经连续重建了说话过程中每一帧变化的三维几何。
作者还将恢复的资产接入已有的 Reflectance Transfer 技术,演示表演视频的重打光。
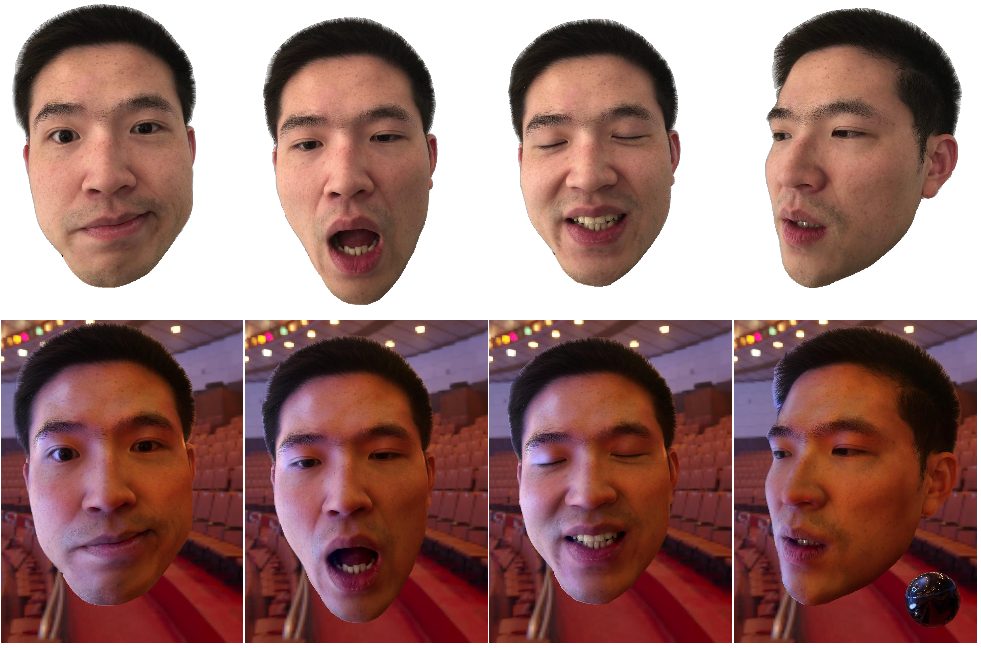
图9|表演重打光应用,来源:原论文图9。上行为原始表演序列,下行为结合反射迁移后的结果。
这个应用表明,静态采集得到的资产可以继续参与视频编辑。它依赖额外的反射迁移流程,因此不能把图9直接当作 CoRA 单独完成动态三维重建的实验。
八、这篇论文值得借鉴的,是怎样的设计判断?
CoRA 的几项设计都对应着明确的歧义来源。眼球的强反光使几何难估计,于是采用球形几何与镜面先验;混合表示可能产生区域交叠,于是增加组合损失;普通图像里的底色与高光难分,于是引入统计反射先验;室内残余照明不能完全关掉,于是使用紧凑的环境光模型。
这种对应关系,使实验结果可以回到设计动机上解释:图3验证区域组合,图4验证眼球几何与反射属性需要配合,图5验证统计先验,环境光消融检验照明模型,图7说明低成本方案仍有细节上限。
实际使用还存在几项约束。会议版需要人工设置眼球位置与半径;被摄者需在拍摄期间保持表情;眼球模型较简化;头发采用漫反射近似。每一个方便优化的先验,都带来相应的表达边界。
以下是基于论文的延伸思考。 若希望进一步恢复真实的皮肤微小起伏,就需要先确认图像中是否包含足够的空间细节,以及拍摄期间能否维持稳定的像素对应。之后还要区分毛孔造成的几何变化、皮肤颜色变化与镜面反射。增加表示容量、提高图像拟合分数,未必能独自解决这些问题。
也正因为如此,偏振、主动照明与高分辨率采集在后续研究里仍有价值。可以把它们看成增加独立观测线索的不同途径,再通过几何真值、法线误差与新光照验证,判断模型恢复出的细节是否可靠。这是从本文限制出发提出的研究方向,并非 CoRA 已经完成的结果。
回到开头那个会随光移动的眼部亮点:要让它在数字人身上表现自然,模型需要同时知道眼球在哪里、表面朝哪儿,以及材质怎样反射光。CoRA 把这些因素放进了一条可训练、可导出、可重新打光的流程,也清楚展示了居家便利与专业采集质量之间仍然存在的距离。
