
 洗子
 匿名

让AI画出一张逼真的人脸,和让这张脸从不同方向看都属于同一个人,是两件难度不同的事。
正面照片里的鼻子、侧面轮廓中的鼻子,以及转头时头发露出的边缘,需要共同对应一个三维对象。如果每个角度都重新生成一张好看的图片,单张图像可能很真实,连起来却会出现五官漂移、发型变化,甚至像换了一个人。
NeRF提供了一种三维表达:网络记录空间中的密度与颜色,从不同方向沿射线采样,就能渲染同一个对象。但普通NeRF通常要为一个场景、一个人物单独训练。能否让一个网络同时学会多个人,再像调整参数化人脸模型一样,在他们之间变形、混合,并生成新身份?
SIGGRAPH2022的MoRF研究的就是这个问题。它把不同人物映射到一个共同的三维空间,再用可控的身份编码描述他们之间的变化。偏振采集在这里也很关键:它为网络提供分离的漫反射与镜面反射监督,让换视角时哪些颜色应稳定、哪些高光应移动,得到更清楚的约束。
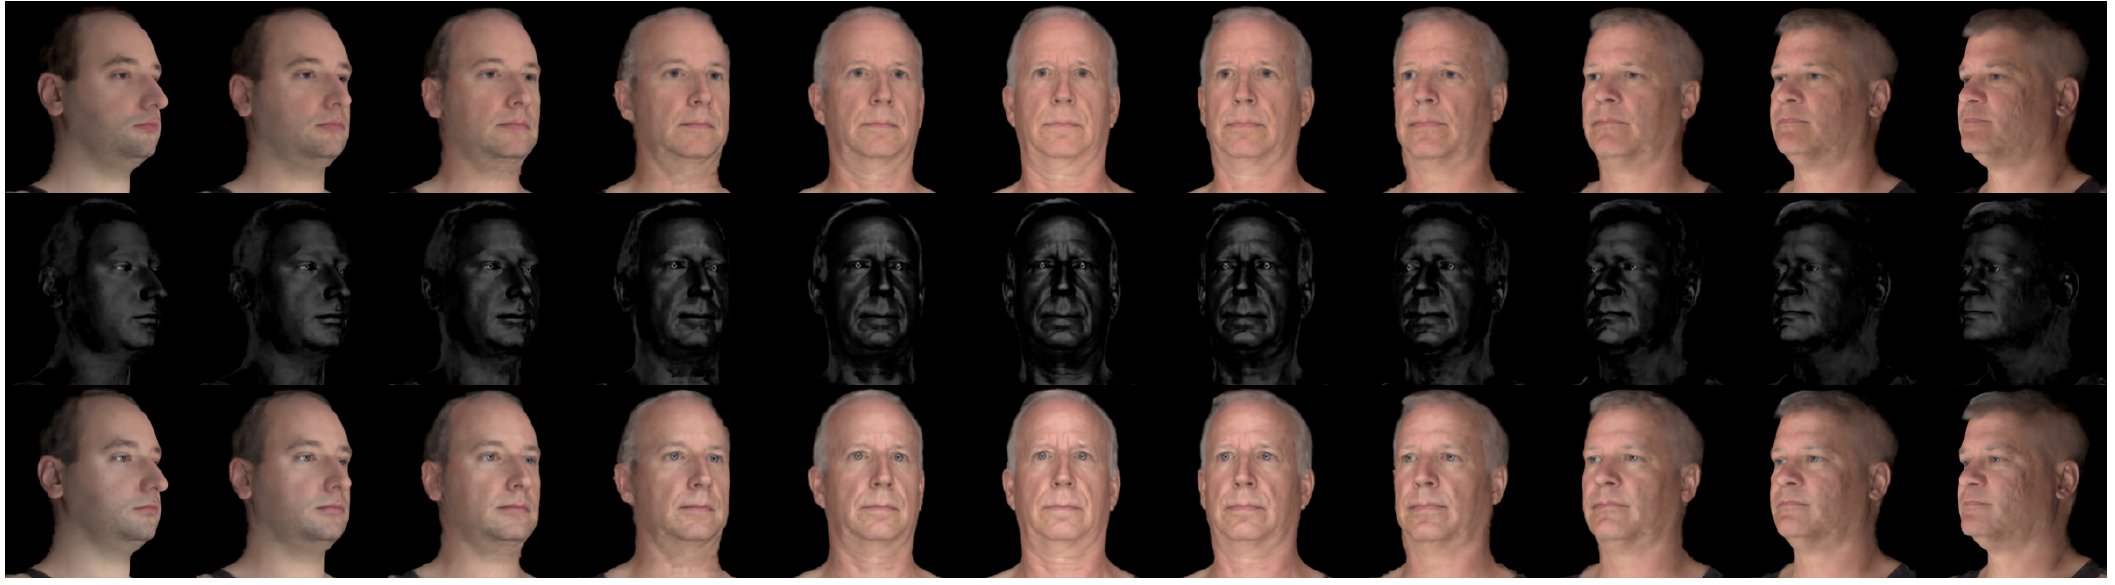
图1|从左到右,身份与视角共同变化;从上到下为漫反射、镜面反射和完整颜色。来源:原论文图1。
图1中间的镜面层值得单独看:额头、头发与眼睛的亮度会随着视角变化,而人物形状与其他外观仍应保持一致。MoRF试图把这几类变化放在同一个可生成的三维表示中。
论文信息
| 项目 | 内容 |
|---|---|
| 英文标题 | MoRF: Morphable Radiance Fields for Multiview Neural Head Modeling |
| 中文标题 | MoRF:用于多视角神经头部建模的可变形辐射场 |
| 发表 | SIGGRAPH 2022,Conference Proceedings |
| 作者 | Daoye Wang、Prashanth Chandran、Gaspard Zoss、Derek Bradley、Paulo Gotardo |
| 机构 | ETH Zurich、Disney Research Studios |
| 论文与补充材料入口 | https://studios.disneyresearch.com/2022/07/24/morf-morphable-radiance-fields-for-multiview-neural-head-modeling/ |
| DOI | https://doi.org/10.1145/3528233.3530753 |
| 关键词 | 可变形辐射场、多身份头部模型、规范空间、偏振监督、球谐、多视角一致性 |
一、先分清三种变化:换相机、换形状、换身份
传统三维可变形人脸模型,把一张脸表示为一组形状和纹理参数。调整参数,就可以改变鼻梁、脸型或肤色。这种方式便于控制,也适合从照片拟合几何,但皮肤网格之外的头发、眼睛,以及复杂的视角反射,往往需要另行处理。
二维生成模型善于生成完整人像,却很难天然保证三维一致性。NeRF通过体积表示改善了这一点,但一个独立NeRF并没有自动获得“从一个人变成另一个人”的参数空间。
MoRF将二者结合:保留NeRF的三维渲染方式,同时学习一个跨人物共享的身份空间。换相机时沿不同方向采样同一个体积;换身份时改变编码,让体积形状和外观随之改变。
这项工作主要针对跨身份建模。它的变形场首先用于对齐不同人的头部,主实验以中性表情为主;表情变化另有小规模概念验证。理解这一点,才能准确判断它与动态表情化身的关系。
二、数据里为什么还需要偏振和三维网格?
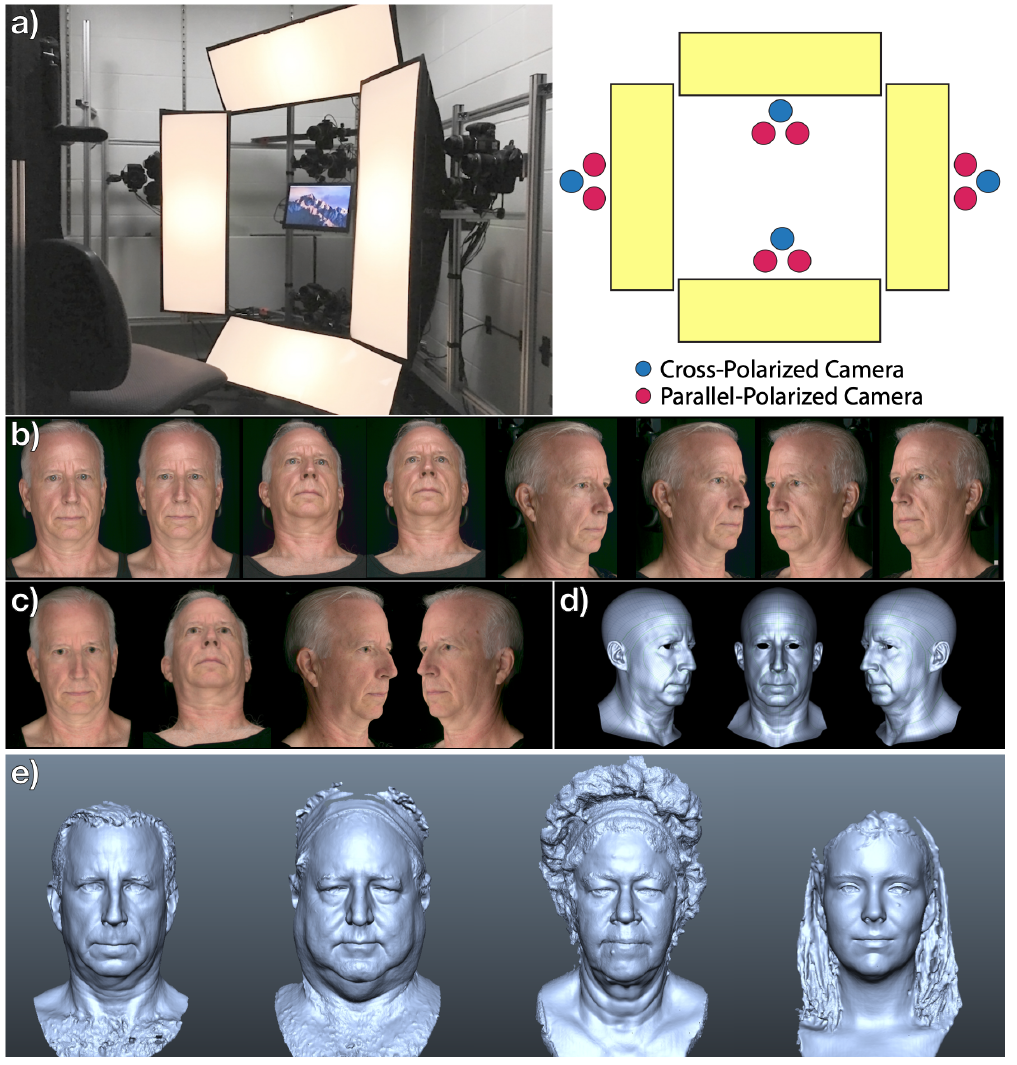
图2|4组相机,每组包含一对平行偏振双目和一台交叉偏振相机;同时得到皮肤模板对应与完整头部立体重建。来源:原论文图2。
MoRF依赖经过标定的摄影棚数据。12台相机分为4组:8台平行偏振相机、4台交叉偏振相机,搭配4块水平偏振摄影灯板。相机与光照经过标定,不同人的刚性头部姿态也被归一化。
交叉偏振主要抑制表面镜面反射,为漫反射提供监督;平行偏振保留高光,为完整颜色提供监督。两类照片合起来,比只看普通RGB图像更容易约束颜色分解。
此外,作者用多视角立体重建获得完整头部几何,并将同一拓扑的模板注册到每个人的皮肤区域。这样,甲的鼻尖和乙的鼻尖、甲的下巴和乙的下巴,就有了明确的对应关系。
发型则很难获得这种对应:短发中的一块空间,在长发人物身上可能是一束头发,在另一个人身上又完全为空。作者因此只在可靠的皮肤区域提供显式形变监督,让其他区域通过图像、密度与网络平滑约束共同学习。
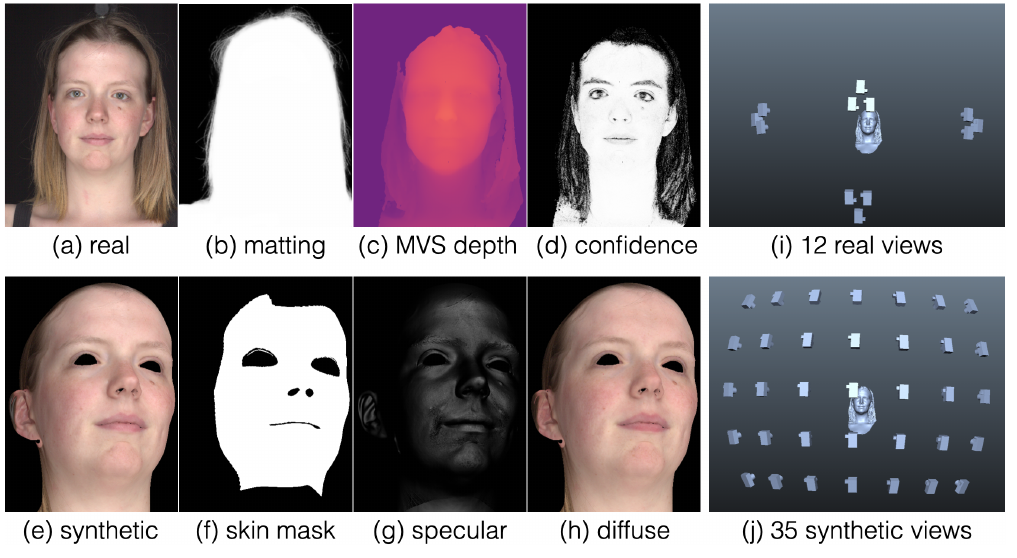
图4|真实照片、前景蒙版、立体深度与置信度,以及合成的皮肤图像;右侧展示真实与新增合成视角。来源:原论文图4。
训练使用15位人物,每人12张真实多视角图像。作者还利用已采集的几何与外观参数,额外渲染每人35个合成训练视角,补充皮肤区域的观测。
这些合成图像只监督皮肤,不能把它们当成额外拍摄的真实头发和眼睛数据。头发的真实观测仍然稀疏,这也解释了后面不少误差为什么集中在那里。
三、网络先把“不同人的同一部位”放到一起
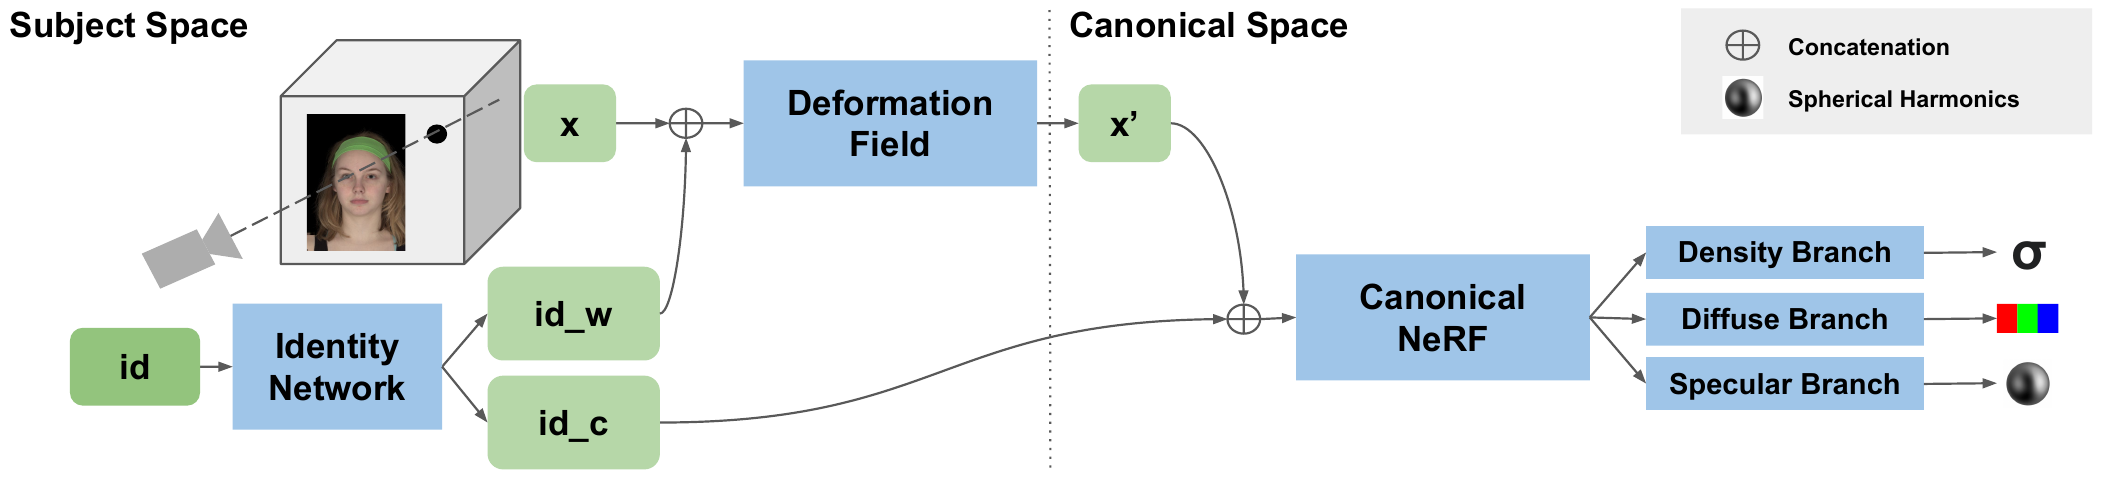
图3|身份网络产生变形编码与规范身份编码;变形场将采样点映射到规范空间,规范NeRF输出密度、漫反射和镜面反射。来源:原论文图3。
可以沿图3从左向右看。输入包括一个人的身份编码$id$,以及当前射线上正在查询的三维点$\mathbf{ x }$。
身份网络先把一个紧凑编码分成两路。原论文式(1)为:
$$ [id_w,id_c]=ID(id). \tag{1} $$
训练实验中,$id$只有4维,两个中间编码$id_w$与$id_c$分别为128维。它们和网络权重一起从多视角数据中优化得到,不是把一张照片直接送进图像编码器所得的结果。
$id_w$控制几何变形。对于某个人的空间点$\mathbf{ x }$,原论文式(2)将它映射到共同空间:
$$ \mathbf{ x }'=DF(\mathbf{ x };id_w). \tag{2} $$
这个共同空间称为规范空间。它的作用可以想象为给不同的人建立统一的三维坐标约定:鼻尖附近的点应该落到鼻尖附近,而不是因为人物脸型不同,就迫使共享网络在同一位置同时解释鼻子和脸颊。
变形网络对每个位置预测局部旋转与平移,因此能描述空间变化的非刚性变形。作者借助输入位置编码的频率控制形变平滑程度,逐步开放较高频率。
有了$\mathbf{ x }'$,规范NeRF再根据规范身份编码$id_c$输出:
$$ [\sigma,\mathbf{ c }_d,\mathbf{ c }_s]=CN(\mathbf{ x }';id_c). \tag{3} $$
$\sigma$是体积密度,决定射线在这里积累多少贡献;$\mathbf{ c }_d$是与视角无关的漫反射RGB;$\mathbf{ c }_s$是一组描述镜面反射随方向变化的系数。
这里有一个重要设计:$id_c$同时影响颜色和密度。如果它只能改颜色,长发需要占据的新空间就无法可靠出现。把所有发型变化都交给连续形变,也很难处理从空区域到长发体积的变化。
因此,两种编码的分工是几何变形与规范空间中的身份变化,具有可观察的解耦效果,但不是严格互不影响的“形状按钮”和“纯颜色按钮”。
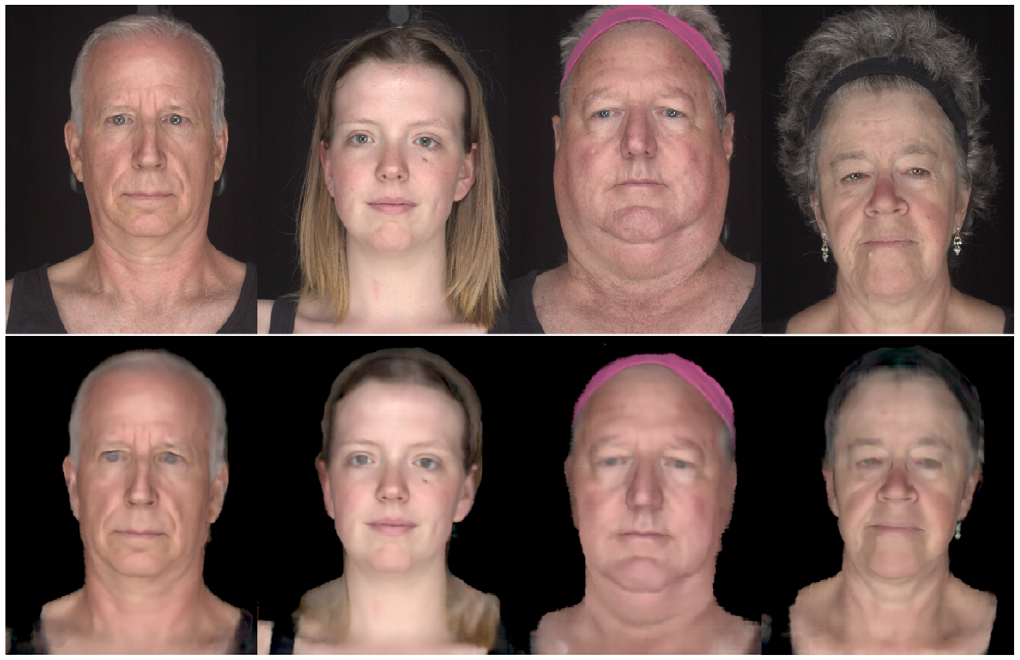
补充图5|上排为真实人物,下排是规范编码只控制颜色、未控制密度时的结果,长发等形态难以表达。来源:原论文补充材料图5。
这张消融图直接说明:对于完整头部,外观变化常常伴随占据空间的变化。网络必须有能力在新的位置生成密度。
四、共同空间怎样避免“看起来对齐,其实没对齐”?
单靠图像误差,网络可能找到一种投机解释:让规范NeRF记住每个人,变形场则几乎不起作用。训练照片仍能被还原,但在两个人之间插值时,中间状态容易变形异常。
作者因此利用已注册模板上的对应顶点,显式约束皮肤的映射。原论文式(5)为:
$$ \mathcal L_{DF}=\lambda_{DF}\sum_{s,\mathbf{ v }} \left\|(\mathbf{ v }'+\xi\mathbf{ n }') -DF(\mathbf{ v }+\xi\mathbf{ n };id_w^s)\right\|_2^2. \tag{5} $$
$\mathbf{ v }$是人物$s$皮肤网格上的顶点,$\mathbf{ v }'$是平均模板上的对应顶点;$\mathbf{ n }$与$\mathbf{ n }'$是两处法线。$\xi$是很小的随机法向偏移。
先把$\xi$设为0看,这个式子就是:把某人的鼻尖顶点送进变形网络,输出应该接近平均模板的鼻尖。再加入同一个小偏移,相当于把约束从一层表面扩展到附近的薄体积,避免网络只在表面上刚好对齐。
原文设置偏移标准差为0.05毫米,并使用细分后约60万个网格顶点。这个数值是监督采样范围,不是重建精度。
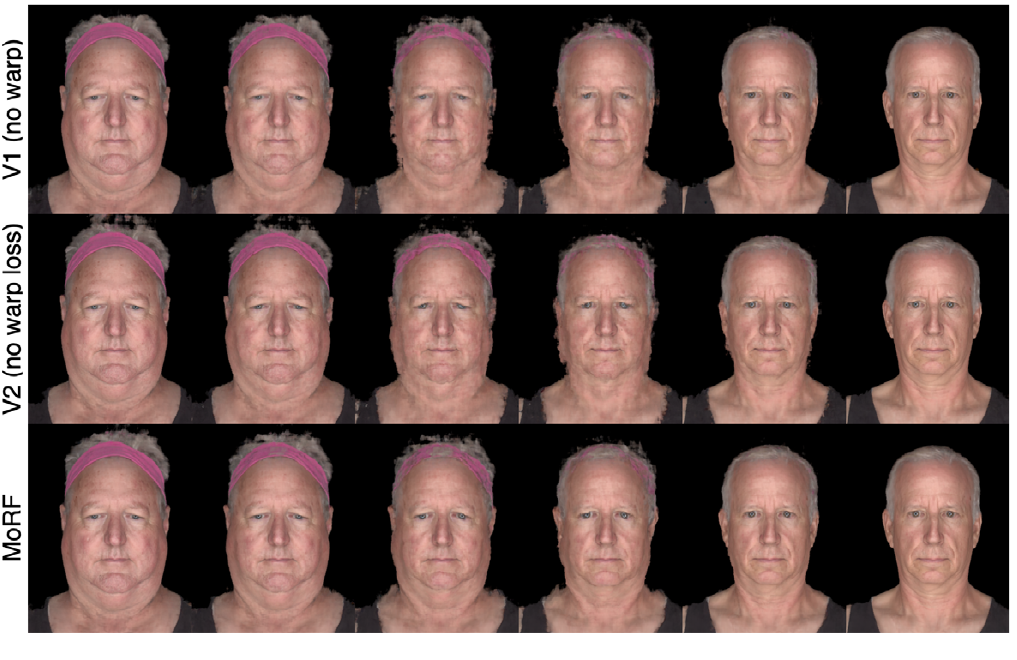
补充图4|从上到下为去掉变形网络、保留变形网络但去掉显式对应监督、完整MoRF。各列展示身份插值。来源:原论文补充材料图4。
观察中间几列的脸侧轮廓,完整模型的过渡更稳定。值得注意的是,在这个4人消融实验里,三种模型的验证PSNR接近,完整MoRF也不是数值最高。
这个结果很有启发:拟合已知人物的能力,与在人物之间产生合理过渡的能力,需要分开检验。一个模型可以记住训练图像,却没有学到适合变形的结构。
五、偏振监督怎样进入渲染公式?
普通NeRF常把位置和视角一起送入网络,直接预测该方向的颜色。MoRF则把颜色分成视角无关部分与平滑变化的镜面部分。
原文在式(3)之后给出的颜色关系是:
$$ \mathbf{ c }(\mathbf{ r }) =\mathbf{ c }_d+\mathbf{ c }_s^T SH(\mathbf{ r }). $$
$\mathbf{ r }$是观察方向,$SH(\mathbf{ r })$是该方向的球谐基函数。网络输出一组系数,和球谐基相乘求和,就能得到当前方向的镜面亮度。
作者采用$K=3$、共9个系数的表示,按通常从0计阶的习惯对应0—2阶。低阶表示限制镜面信号在视角间平滑变化,减少少量相机监督下的任意波动。白光标定条件下,镜面项采用中性标量,并加到RGB漫反射上。
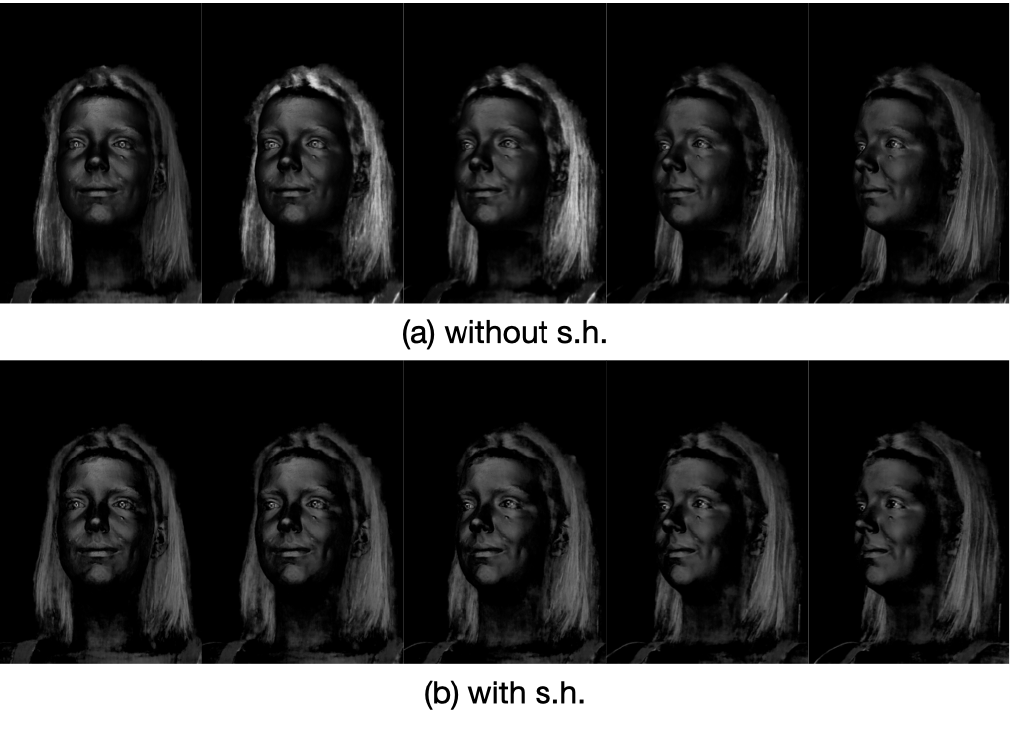
补充图7|上排以位置编码后的视角直接输入MLP,下排使用球谐输出约束。来源:原论文补充材料图7。
这张图重点看头发:真实高光应该随着视角连续变化,缺少约束时却容易出现不稳定的局部亮暗。低阶球谐用表达能力上的限制,换取稀疏观测下的稳定性。它也意味着方向信号的复杂程度受到限制。
随后,沿射线把各个采样点的颜色积累起来。原论文式(7)为:
$$ \mathcal L_{RGB}=\sum_{s,c,p} \left\|I_{cp}-\sum_i\omega_{pi} \left(\mathbf{ c }_{d,pi} +\mathbf{ c }_{s,pi}^{T}SH(\mathbf{ r }) \mathbf{ 1 }_{[c\notin\mathcal C_{XP}]}\right)\right\|_2^2. \tag{7} $$
$I_{cp}$是相机$c$的像素$p$,$i$沿着这条像素射线编号;$\omega_{pi}$由密度与前方透射率决定。它表达了NeRF体积渲染的基本规则:前面的密度会遮挡后面的贡献。
$\mathcal C_{XP}$是交叉偏振相机集合。对应指示函数在交叉视角取0,只监督漫反射;在其他视角取1,监督漫反射与镜面反射之和。偏振数据由此直接进入了损失,而不仅是用来拍摄更干净的照片。
这里学到的是固定采集光照下的漫反射与镜面辐射。漫反射颜色包含已有照明的影响,镜面球谐也是观察方向上的出射亮度分布。论文没有把材质反照率与光照完全分离,因此能分层渲染、能换视角,不等于已经能任意换光。
六、网格还帮助网络知道哪些空间应该为空
只有颜色误差时,一些错误密度也可能通过补偿颜色来匹配照片。MoRF利用蒙版和立体深度,进一步约束空间占据。
背景像素的射线上,网络应尽量不放置密度。对于前景像素,如果立体重建告诉我们表面在某个深度,那么表面前方一段可靠的自由空间,也不应该悬浮一层能遮挡射线的密度。
原论文式(6)的密度损失分别处理这两类情况。深度约束乘以立体置信度,皮肤区域较可信,复杂头发区域较弱;距离表面5毫米以内不施加这项前方清空约束。它提供的是自由空间先验,没有把整张立体网格当成绝对正确的密度表面。
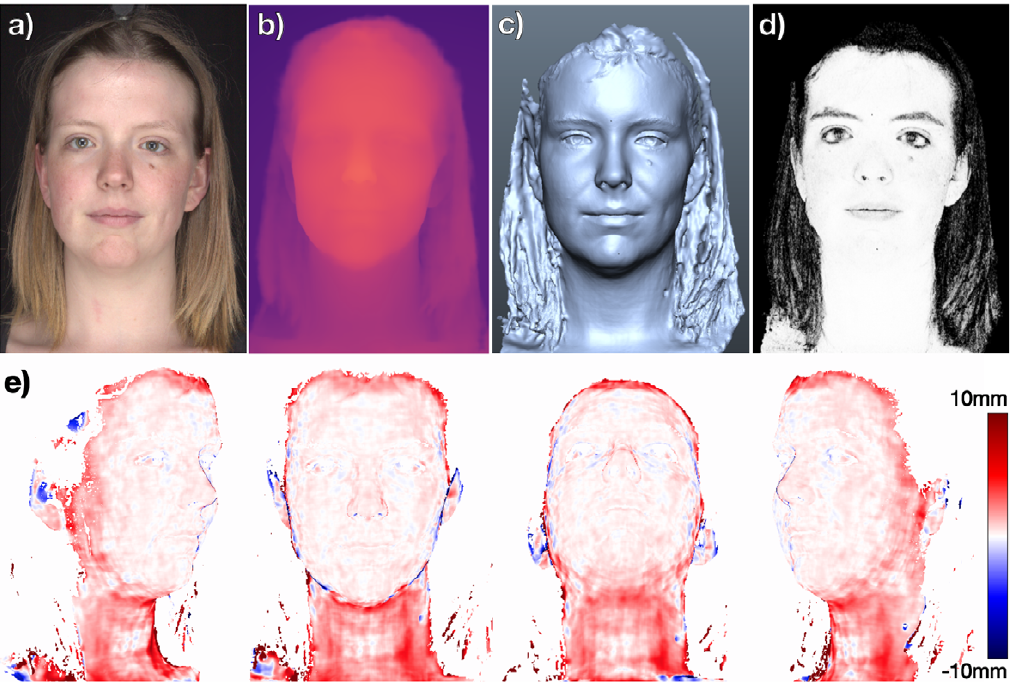
补充图6|真实输入、MoRF深度、立体网格、立体置信度和深度差异;差异色条为±10毫米。来源:原论文补充材料图6。
补充材料报告皮肤区域与立体深度的RMS差异约5毫米。这是两种方法之间的差异,其中立体结果又参与监督,不能把它当成独立真值上的毛孔级测量精度。
训练还对4维身份编码施加靠近原点的正则。所有网络和人物编码一起优化;位置编码由粗到细开放。主实验训练40万次迭代,在一张3090级GPU上约80小时。完整模型的建立仍是一项离线训练任务。
七、学会多个人之后,可以怎样生成新人物?
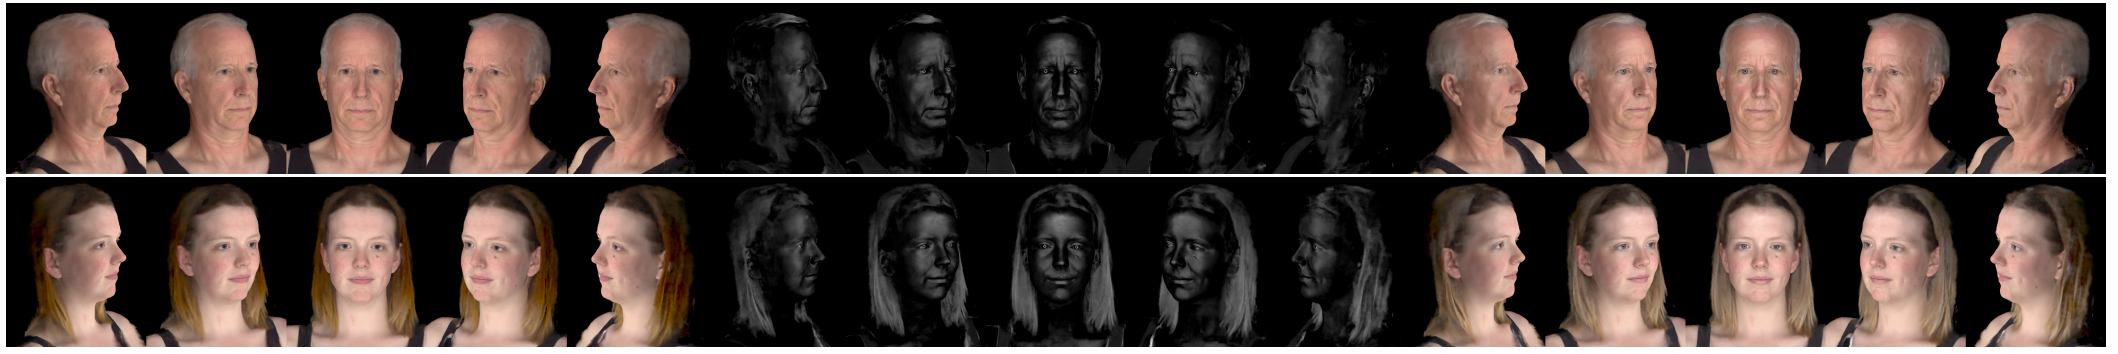
图5|两位训练人物的转台视角,左、中、右分别为漫反射、镜面反射和完整渲染。来源:原论文图5。
先看最基本的能力:同一个共享网络能重建不同训练人物,换视角时保留五官、头发和眼睛的一致性。镜面层会变化,完整身份应该保持。
然后可以混合两个中间编码:取甲的$id_w$,搭配乙的$id_c$。这样,甲的变形结构与乙在规范空间中的外观、发型等因素组合,产生新的头部。
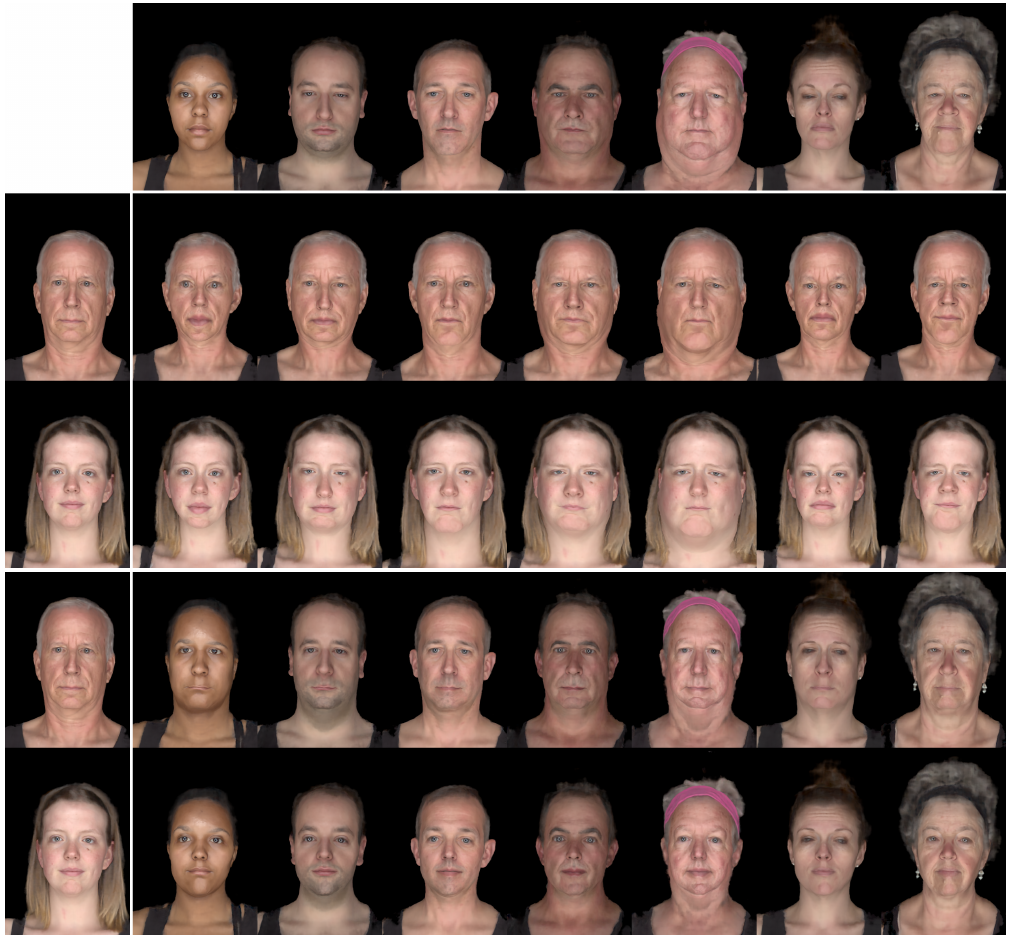
图7|顶部为被混合的训练人物;第2—3行固定左侧人物的变形编码,第4—5行固定其规范身份编码。来源:原论文图7。
这张图既能看出两路编码的控制效果,也能提醒我们控制不是完全独立:规范身份编码仍影响密度和发型体积。
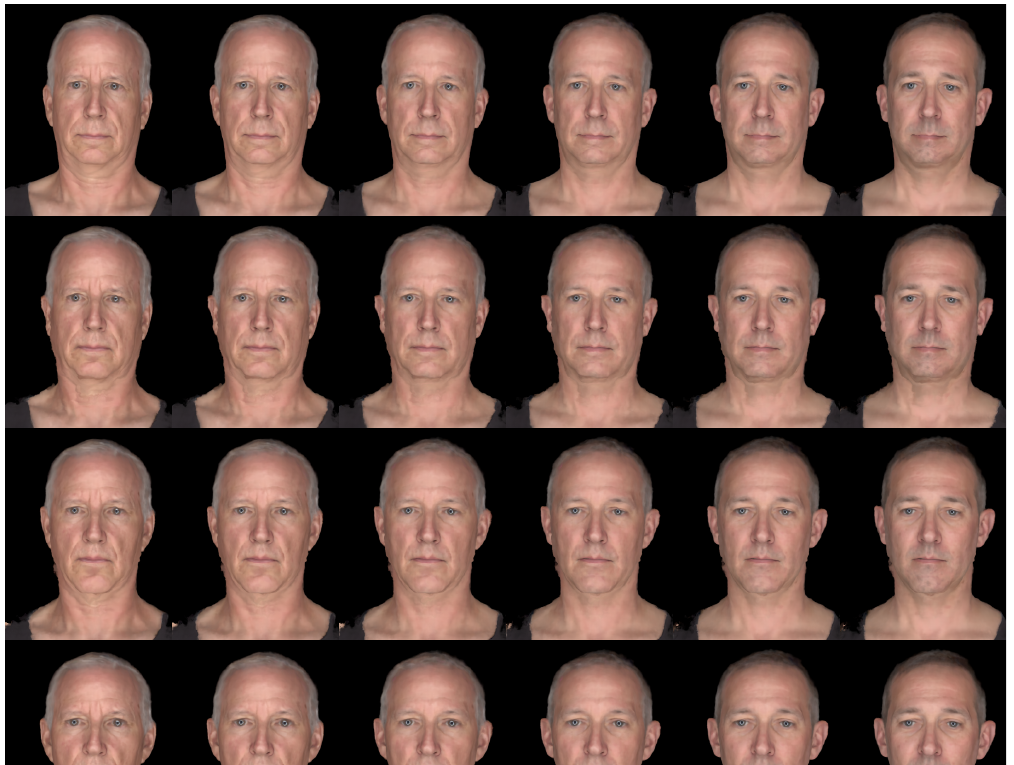
图8|横向插值规范身份编码,纵向插值变形编码,左上与右下为两个真实训练人物。来源:原论文图8。
插值相当于在两个编码之间逐步移动。要让中间人物合理,前面的语义对齐就很重要,否则脸颊、鼻子和头发可能以不一致的方式混在一起。
这些实验展示了一个可生成的身份空间,而不是通过照片测量出一个现实中存在的新人物。对于训练数据没有充分覆盖的变化,例如短发与长发之间的过渡,作者也观察到中间状态可能出现悬浮头发。
八、只有一张新人物照片时,哪些信息来自照片,哪些来自先验?
MoRF还可以用来初始化新人物的NeRF。这里分成两个阶段。
先冻结网络,拟合身份编码:用100次迭代求4维$id$,再用1000次迭代调整$id_w$与$id_c$。补充材料分别报告不到1分钟和约10分钟。此时模型只能在15个人学到的变化范围内寻找最合适的组合。
若新人物有独特的五官和发型,仅调整编码还不够。作者随后冻结编码、微调网络权重,进行2000次迭代,约需30分钟。这个阶段才让模型进一步适应新人物。
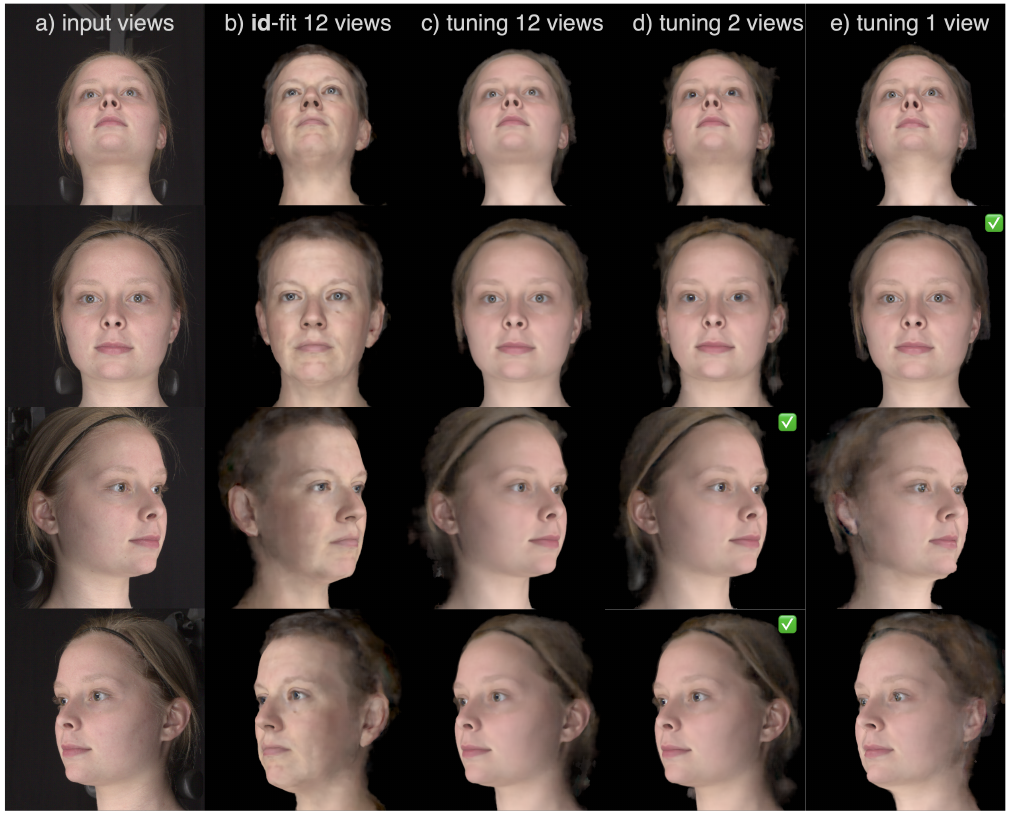
图9|从左到右为输入、12视角编码拟合,以及使用12、2、1个视角微调网络后的结果。绿色标记指示参与相应微调的观测。来源:原论文图9。
注意第2列:即使用了12个视角,单靠编码拟合仍难完整表达这个新人物。第3列加入网络微调后,身份特征更接近输入。
论文将2000次微调与从头训练单人物NeRF的20万次迭代比较,约为后者1%的迭代数、5%的优化时间;这不是从输入到最终资产的全部流程耗时,也不是一次网络前向预测。
| 新人物测试设置 | 有网格PSNR | 无网格PSNR | 评价范围 |
|---|---|---|---|
| 11张真实图像适配 | 33.34 | 33.36 | 5位测试人物,各留出一张正面图 |
| 1张真实图像适配 | 26.4 | 25.8 | 5位测试人物,其余11个视角 |
数据据主文整理,PSNR单位为dB。两行的留出视角组成不同,不应只凭差值作严格同协议比较。
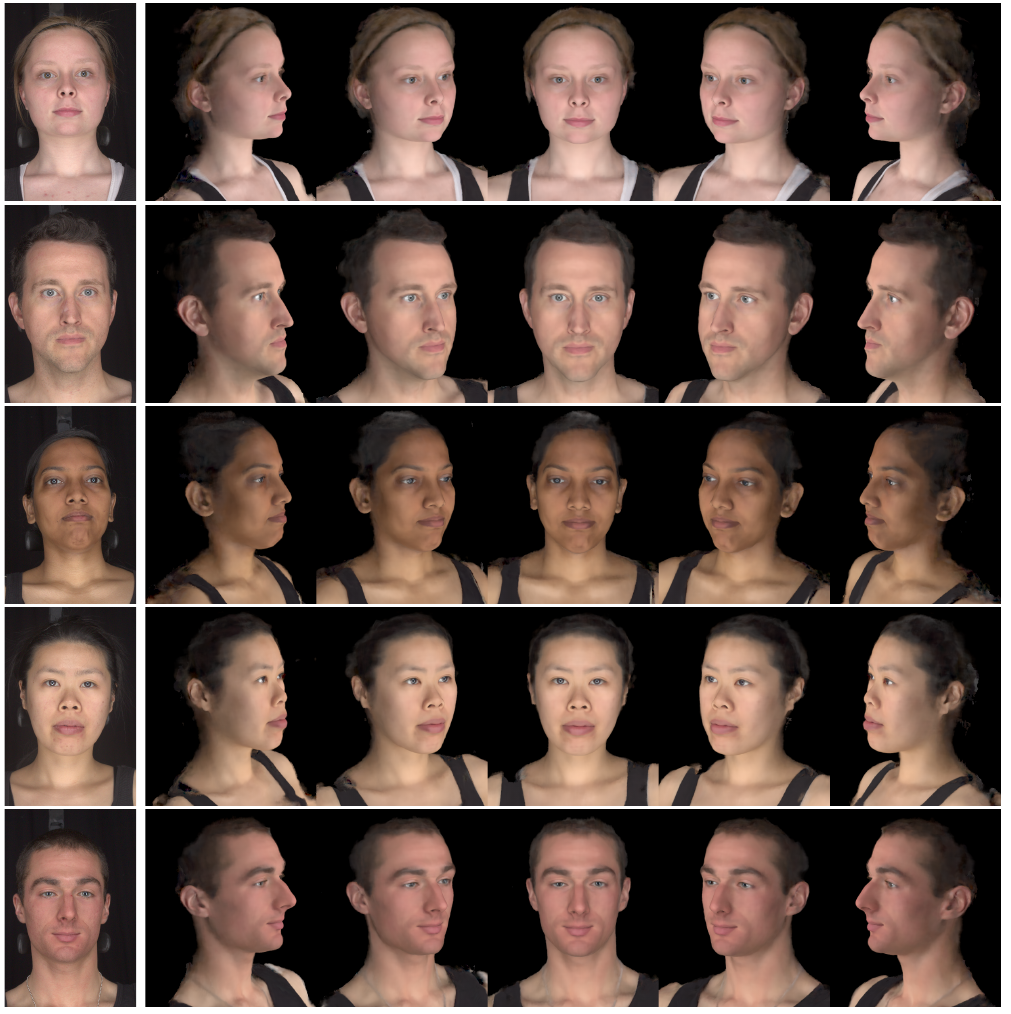
图10|左列为未参与适配的正面真实图,其余为11视角加网格适配后的新视角渲染。来源:原论文图10。
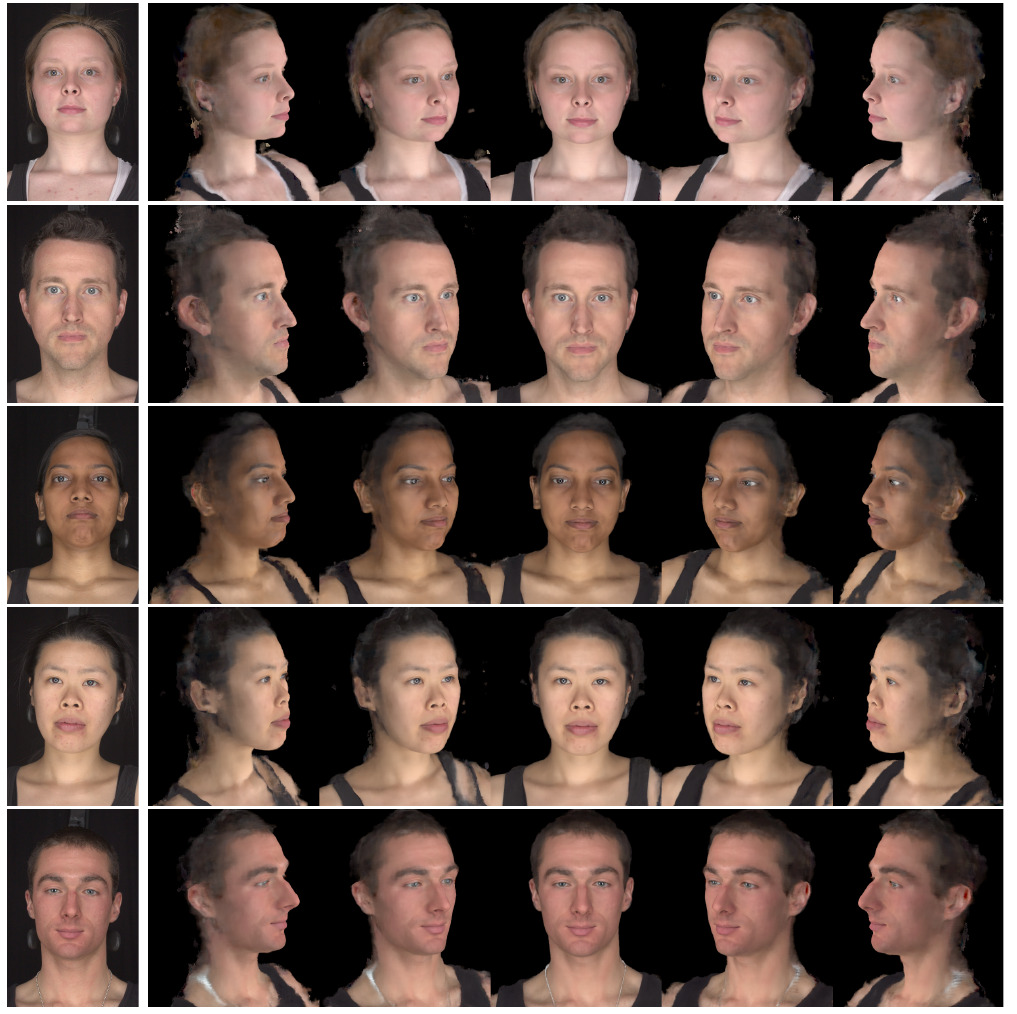
图11|左列单张真实图参与适配,右侧为结合网格适配后的新视角。来源:原论文图11。
看图10与图11时,尤其要比较侧脸轮廓和头发。单张正面照片无法直接观测侧面,系统对这些区域更多依赖预训练先验与已有几何。能生成一个可转动的头部,并不意味着所有未见区域都已被准确测量。
九、图像质量、变形质量和几何精度,需要分别评价
主文报告,真实训练图像PSNR为35.98,皮肤合成验证图为36.62。补充材料相应验证叙述给出36.13,二者数值存在差异,因此不把它们合并成同一个确定指标。
更值得关注的是补充材料的对照。在单人物实验中,普通NeRF的验证PSNR为37.98,MoRF为35.84。MoRF的价值在于用一个模型承载多个人并形成可变形空间,而不是每一位人物的逐像素拟合都超过专用模型。
类似地,去掉变形监督的版本也可能得到接近甚至略高的PSNR,却在人物插值时更不自然。评价一个可变形模型,需要看它在编码变化时是否仍保持合理结构。
表情能力也处在明确范围内:补充材料用同一个人的中性、惊讶、皱眉3种表情验证了可表达性,没有给出跨身份、连续表演的完整驱动系统。
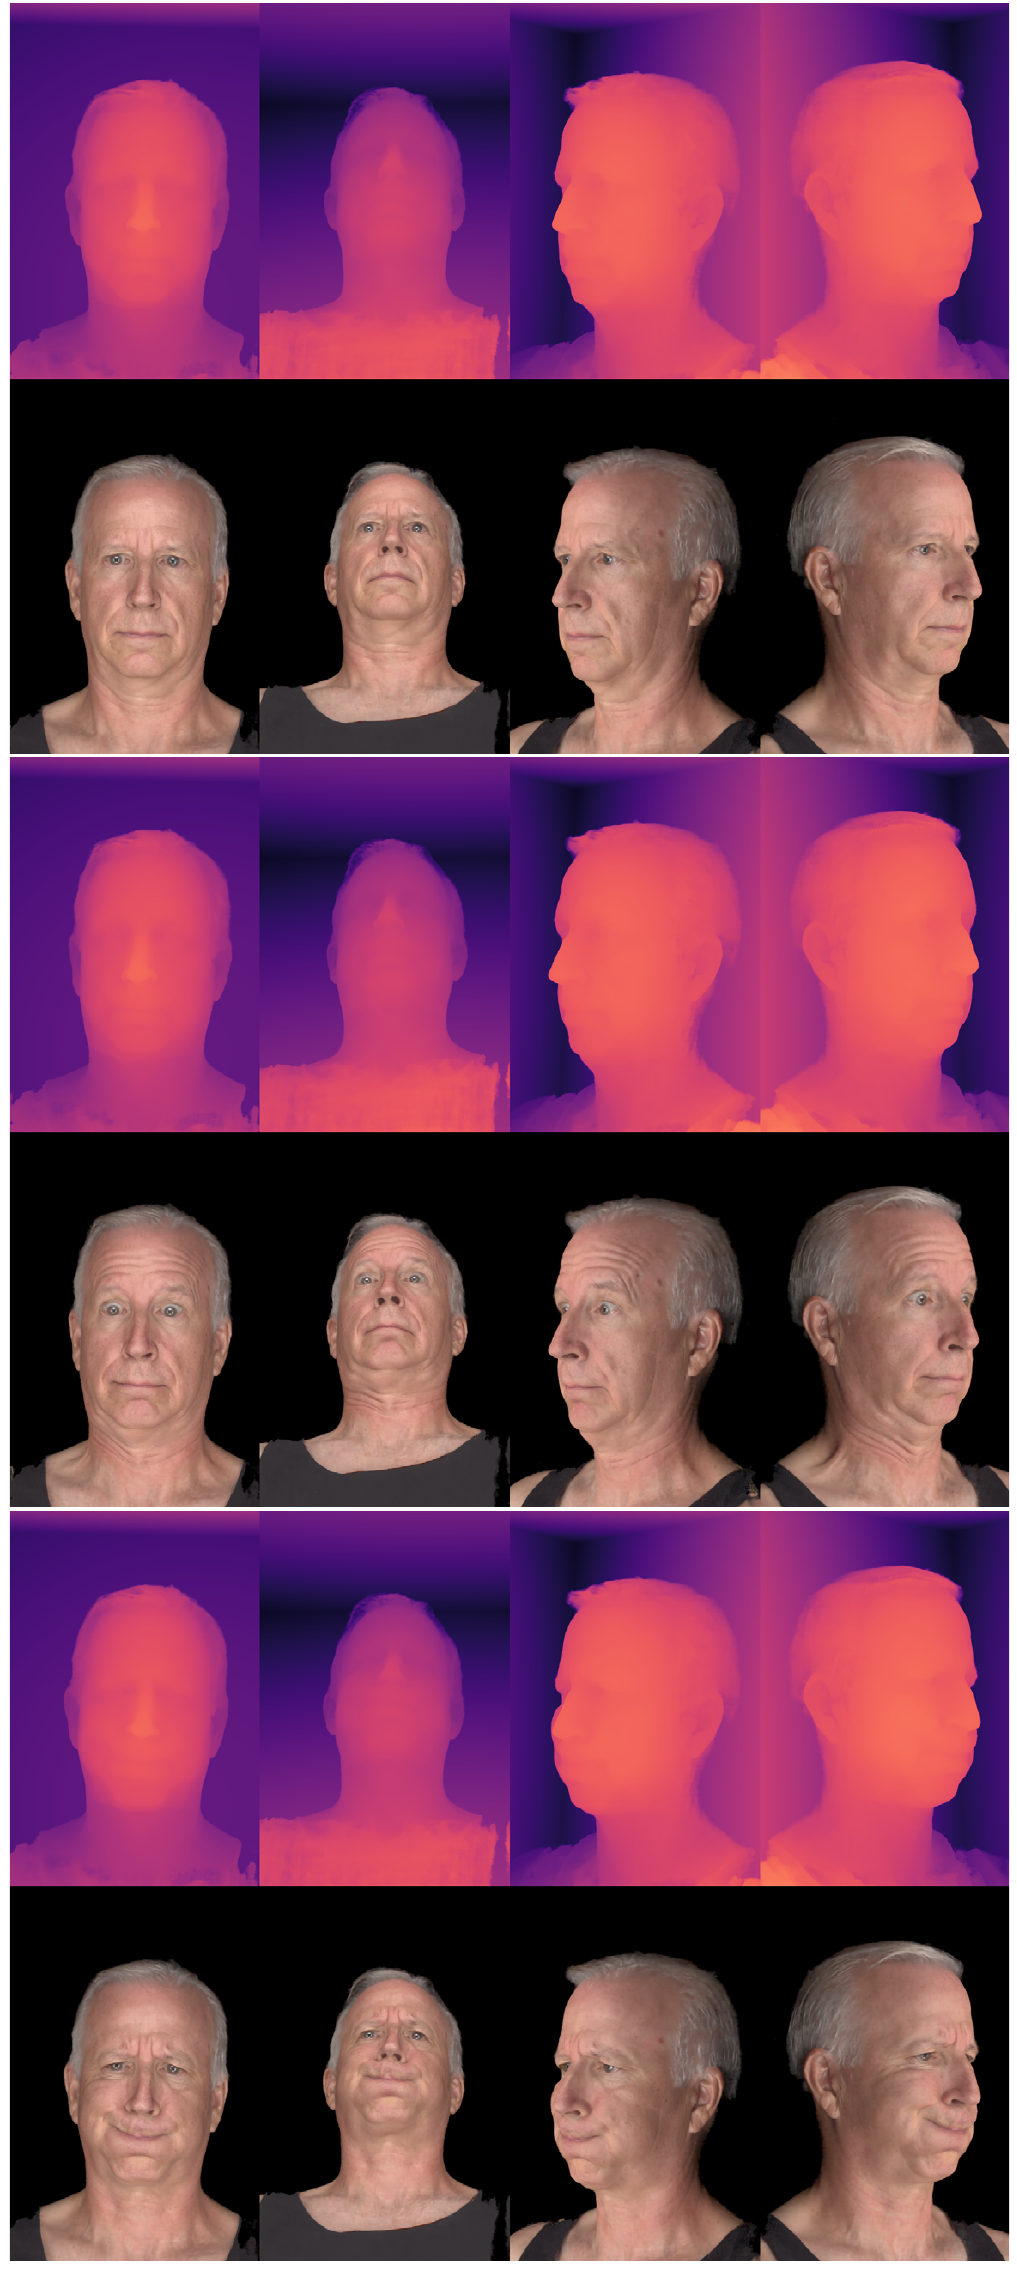
补充图8|一个人物、3种表情、4个视角的概念验证。来源:原论文补充材料图8。
十、对偏振人脸建模,这篇论文留下了什么?
MoRF说明,偏振数据的用途可以延伸到生成模型训练:让视角无关和视角相关信号分别受到观测监督,再让共享的三维表示承担新视角的一致性。
它也展示了完整头部建模的难处。皮肤有较可靠的跨人物对应,发型与饰物却可能改变空间占据;为颜色建立先验还不够,网络需要解释这些体积变化。与此同时,分离两种辐射并没有自动得到可自由换光的材质资产。
对于后续偏振与3DGS人脸研究,可以从这里提出一个具体问题:当模型同时使用几何对应和反射分离监督时,哪些信息真正改善了表面结构,哪些主要改善视图合成?这是基于本文的研究延伸,MoRF本身没有使用3DGS,也没有验证毛孔级几何恢复。
从图像中生成一个能转动的头像、从多视角数据学习可控身份、测量有物理尺度的皮肤细节,是相互关联但评价目标不同的工作。MoRF推进的是其中的可生成三维头部表示:让同一个网络中的“这个人是谁”和“从哪里看他”,获得更明确的控制。
