
 洗子
 匿名

把一张普通人像照片重建成三维人脸,轮廓、五官和肤色都已经很像,但镜头一旦拉近,皮肤仍可能显得过于光滑。真实皮肤上细密的微皱纹与毛孔,会改变局部受光,让脸颊、额头和鼻翼呈现不同的质感。
问题在于,普通照片往往没有清楚记录这些细节。微皱纹可能只剩下模糊的走向,毛孔也可能挤在几个像素里。直接把照片放大,并不能找回已经丢失的几何;给整张脸加一层随机凹凸,又容易让不同部位长出同一种纹理。
SIGGRAPH 2025的这篇论文提出了FLEX框架。它先观察照片中仍然可辨认的皮肤纹理,再用具有可控参数的模型,合成方向、密度与外观相近的微观结构,并将其补充到已有的三维人脸上。
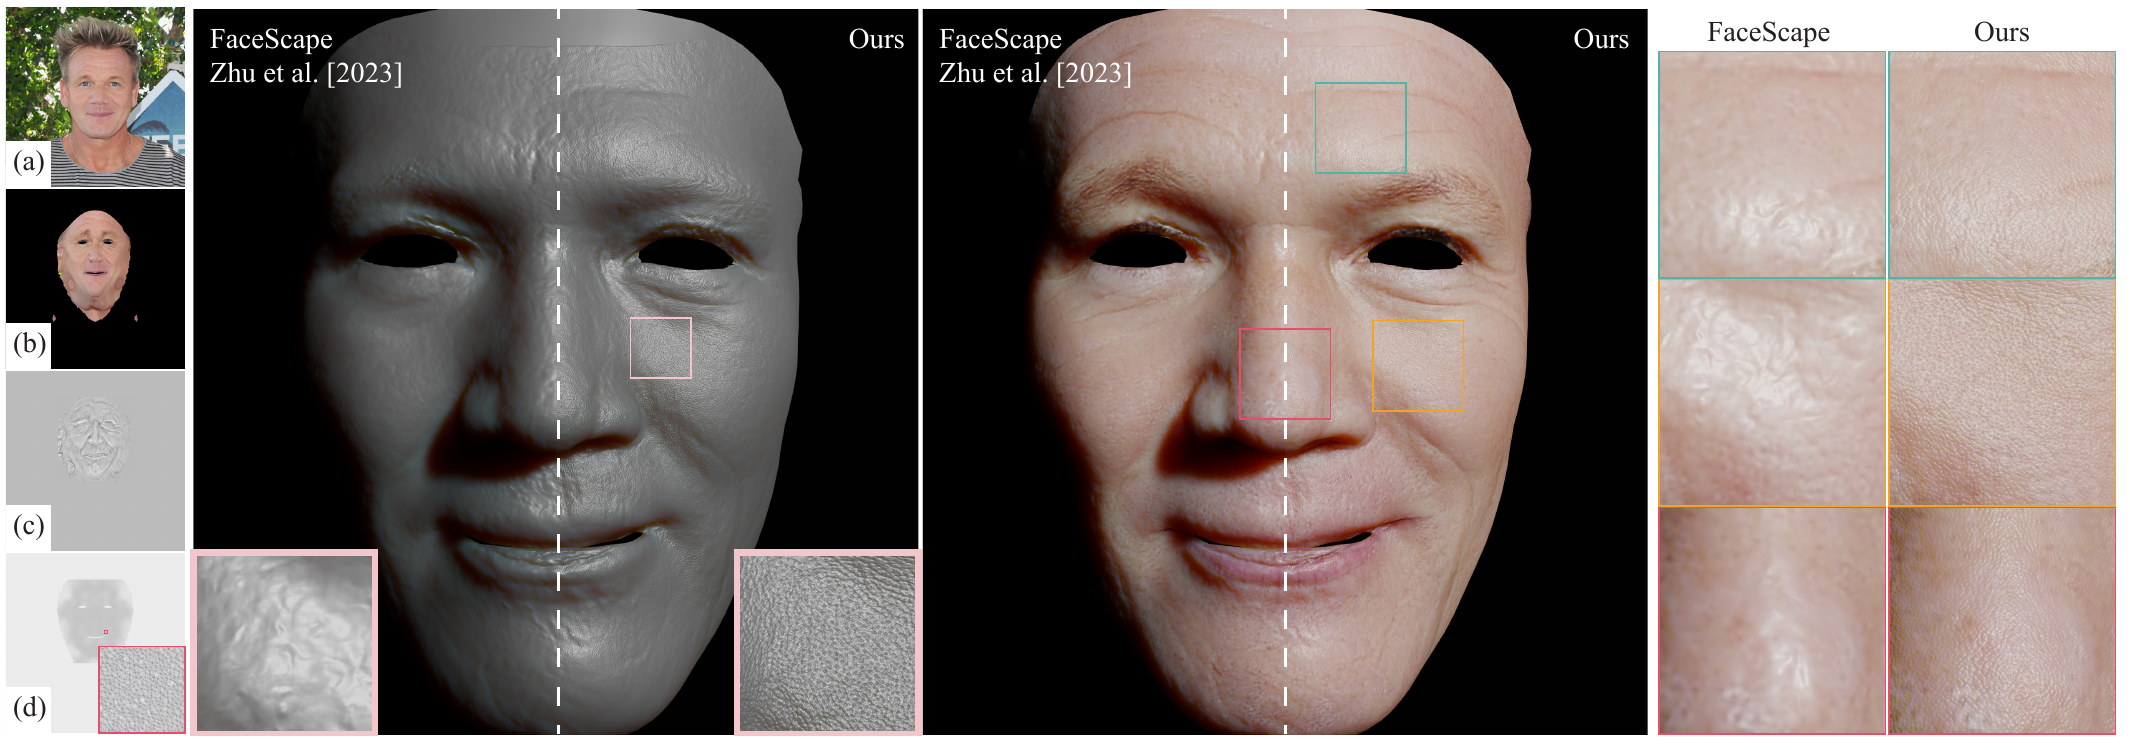
图1|左侧依次为输入照片、纹理、宏观位移和微观位移;中间比较几何与带纹理渲染,右侧放大不同皮肤区域。来源:原论文图1。
这里的“合成”很重要。照片没有提供足够信息时,方法依靠结构先验补充合理细节,并不意味着它逐一找回了本人真实毛孔的位置与深度。它要解决的是:如何让合成的皮肤受到输入照片的约束,同时比随机噪声更有组织、更接近照片中的质感。
论文信息
| 项目 | 内容 |
|---|---|
| 英文标题 | Facial Microscopic Structures Synthesis from a Single Unconstrained Image |
| 中文标题 | 从单张无约束图像合成人脸微观结构 |
| 发表 | SIGGRAPH 2025 Conference Papers,Article 29 |
| 作者 | Youyang Du、Lu Wang、Beibei Wang |
| 机构 | 山东大学、南京大学 |
| 项目主页 | https://icewired-yy.github.io/papers/face_micro_detail_synthesis/ |
| 论文与DOI | https://doi.org/10.1145/3721238.3730760 |
| 代码与数据 | 本次在官方项目页及作者公开仓库中未找到该方法的公开代码与训练数据入口 |
| 关键词 | 单图人脸、微观结构、微皱纹、毛孔、图神经网络、可微模拟、方向分布相似性 |
一、为什么人脸已经重建出来,皮肤还是少了一层质感?
人脸几何可以分成不同尺度。脸型与五官决定整体轮廓,较大的褶皱影响局部形状,细密微皱纹和毛孔则进一步改变皮肤表面的凹凸与受光。
已有单图人脸方法可以恢复前两类中的许多结构,但其输出不一定包含足够细的微观起伏。把这些结果直接用于近景渲染,脸可能看起来平整,缺少真实皮肤的细密变化。
专业扫描可以采集更丰富的细节,但通常依赖受控照明、多相机或高质量近距离图像。本文关注的是另一种输入:光照、相机设置和设备未知或不受控的一张人像照片。
这样的照片中,精确细节可能丢失,但仍有一些统计规律保留下来。例如,某块皮肤的细纹更偏向一个方向,另一块则更加交错;有些区域毛孔密集,另一些相对稀疏。
因此,作者没有要求模型逐像素复制模糊照片,而是把问题改写为:找到一组微观结构参数,使生成的皮肤在可辨认的方向特征与整体外观上接近输入。
这一改写带来两个具体问题。需要有一个既能产生合理皮肤、又便于调整参数的生成模型;也需要一种比较方法,能够跨越“模糊照片”与“清晰合成细节”之间的差异。
二、微皱纹和毛孔,为什么可以用图来表示?
把一小块皮肤看成一组凹陷与细沟:毛孔可以作为点,微皱纹可以作为连接点的线。这样,微观结构就对应一张图,毛孔是节点,皱纹是边。
这种表示来自Weiss等人2023年的图模型,本文在其基础上设计可微的神经模拟过程。它的价值在于,皮肤细节不再是一张任意的噪声图,而是具有连接关系、方向和深度的结构。
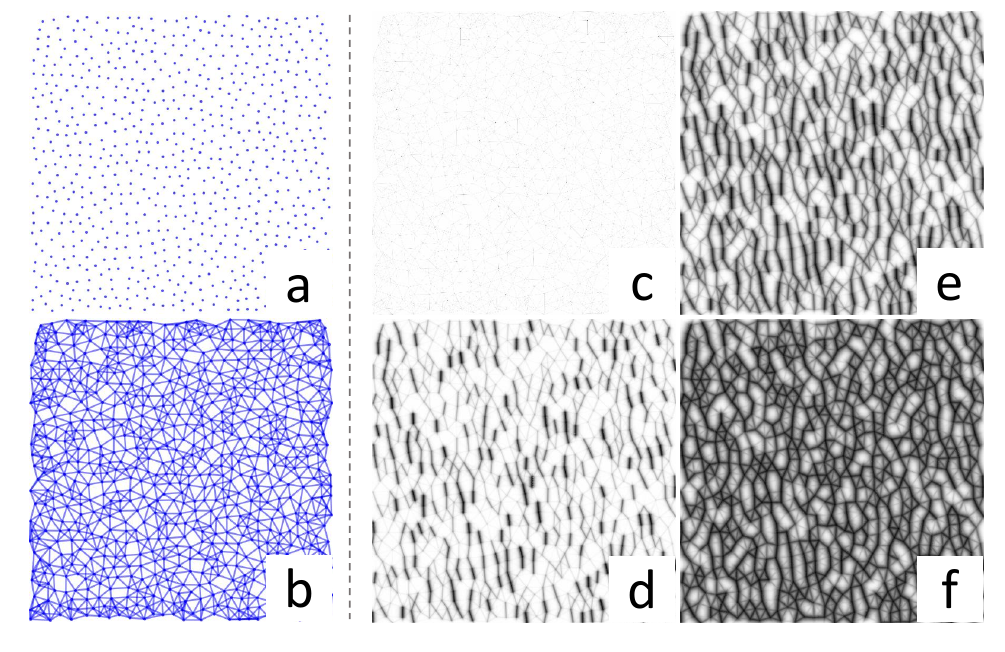
图4|a为采样的毛孔位置,b为连接后的基础图;c至f展示神经皱纹模拟迭代0、3、5、7次时的结果。来源:原论文图4。
图中每条皱纹的深度不是孤立决定的。两条细纹在同一个毛孔附近交汇,一条变深之后,邻近结构也可能发生变化。把这些相互影响显式建模,才能形成有组织的细纹网络。
作者使用一组语义参数控制它们。这里的“语义”指参数具有可解释的作用,而不是一个难以理解的高维向量。
| 参数 | 在本文中的作用 |
|---|---|
| $\phi$ | 毛孔的平均间距 |
| $\beta$ | 邻接皱纹深度向毛孔深度的混合强度 |
| $\theta$ | 皱纹的主方向 |
| $\mu$ | 皱纹方向的均匀程度 |
| $\delta$ | 皱纹长度对模拟的影响程度 |
| $\sigma$ | 皱纹的连续程度 |
| $\tau$ | 对相似皱纹的容忍程度 |
| $\rho$ | 迭代过程中皱纹深度的沉积参数 |
从原论文表1中选取本文参数向量实际包含的八项,中文解释按使用语境整理。原表还列出已有模型的交叉容忍参数$\gamma$,它不在本文式(4)所列的优化参数向量中。
例如,增大毛孔间距会改变基础图的密度;改变主方向会影响微皱纹更偏向哪种走向;改变连续程度则会影响相邻细纹如何组织。这样,照片中不够清楚的微观细节,可以通过较少的参数受到约束。
三、先看全流程:从人像照片到整脸微观位移图
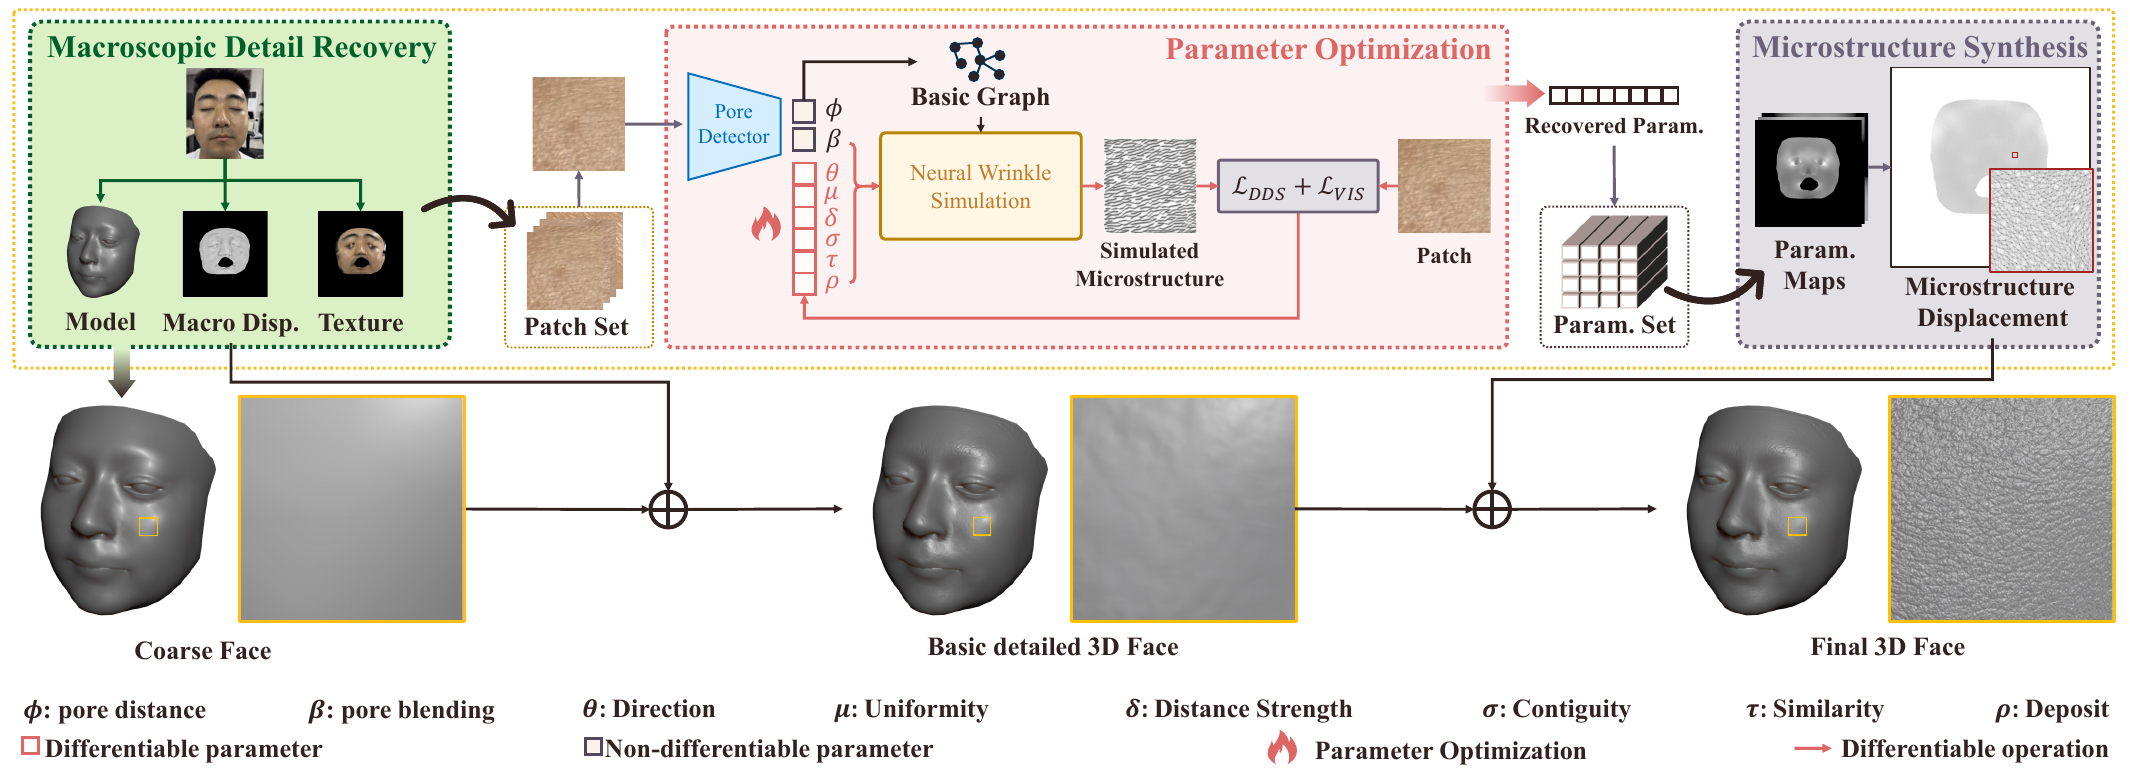
图2|左侧使用已有方法恢复基础人脸、纹理和宏观位移;中间在纹理图块上估计微观参数;右侧将局部参数扩展为全脸参数图,再合成微观位移。来源:原论文图2。
FLEX建立在现有人脸重建结果上,可以接入FaceScape、DECA或HRN等方法。基础方法负责恢复粗几何、较大尺度的细节和纹理,并把照片中的人脸展开到纹理坐标空间。
纹理空间可以理解为把三维脸表面展开成一张平面地图。 脸颊、额头和鼻翼各自对应其中的区域,后续在平面上分析的参数也能映射回三维表面。
接着,系统从纹理空间均匀随机采样皮肤图块。每个图块分别估计毛孔参数和皱纹参数,得到散布在全脸上的局部参数样本。之后,通过径向基函数插值生成平滑变化的全脸参数图,最后合成微观位移图。
位移图记录表面的细小起伏,而不是单纯给纹理增加深浅颜色。将它与原有宏观几何结合后,新的微观细节就能够影响渲染中的受光。
值得注意的是,局部参数优化使用本文的神经皱纹模拟器;最后整脸微观结构的生成,则使用Weiss等人2023年前向模型的简化版本。二者在流程中承担不同任务,不能把最终整脸生成也一概写成GNN直接输出。
四、局部皮肤图块,怎样变成可优化的参数?
设可控微观模型为$\mathcal W$,参数向量为:
$$ \mathbf{ x }=(\phi,\beta,\theta,\mu,\delta,\sigma,\tau,\rho). $$
作者在原论文式(4)中,将问题写为:
$$ \underset{\mathbf{ x }}{\arg\min}\; \mathcal L\left(\mathcal W(\mathbf{ x }),\mathcal W'\right). \tag{4} $$
$\mathcal W'$表示目标微观结构,$\mathcal W(\mathbf{ x })$是当前参数生成的结构。式子的意思是:不断调整参数,让生成结果与目标更接近。
实际输入只有照片图块,并没有目标的完整三维微观结构。因此,后续损失函数使用图块中可观察到的方向与外观来比较,而不是假装知道真实的每个毛孔深度。
毛孔参数:先用网络给出估计
对皮肤图块$I'$,作者构造三种输入:灰度图$\mathcal Y(I')$、高通滤波结果$\mathcal H(I')$,以及对高通结果进行阈值处理得到的二值图$\mathcal T(I')$。
原论文式(5)为:
$$ (\phi,\beta) =\mathcal P\left(\mathcal Y(I'),\mathcal H(I'),\mathcal T(I')\right). \tag{5} $$
$\mathcal P$是毛孔检测网络。灰度图保留亮度外观,高通图突出局部快速变化,二值图进一步提供离散的结构线索。网络输出平均间距和混合强度两个参数。
这些输出用于组织毛孔与皱纹结构。它并没有提供一张经过真实毛孔逐点标注验证的精确位置图。
皱纹参数:让生成模型接受梯度优化
剩余六个皱纹参数,则通过神经模拟器与损失函数迭代调整。
难点来自原有图模拟方式:参数先影响某条皱纹在某次迭代中“是否更新”的概率,再通过随机事件影响深度。这种离散随机更新,不便于把图像误差沿连续计算链直接传回参数。
本文使用GNN学习参数、邻接结构与皱纹深度之间的关系,建立可用于梯度下降的替代计算过程。它保留了“相邻皱纹互相影响”的图结构,同时让参数优化更高效。
五、GNN怎样模拟一张细纹网络?
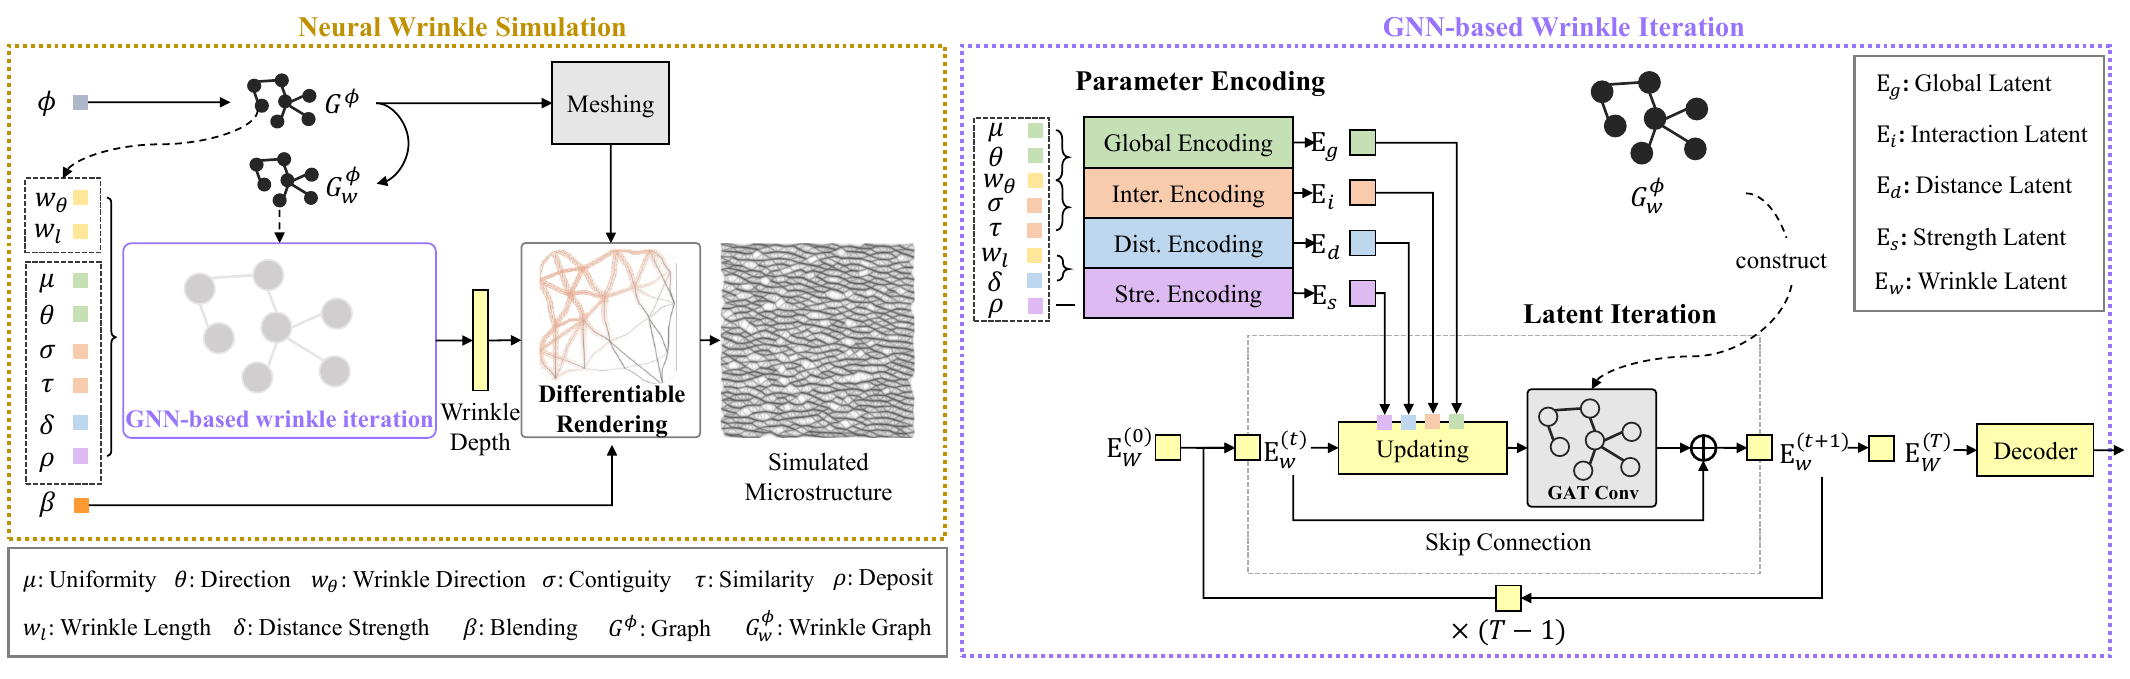
图3|左侧为从图结构与参数生成微观位移图的过程,右侧展开GNN中的参数编码、迭代更新和深度解码。来源:原论文图3。
把“皱纹是边”转成“皱纹是节点”
先根据平均间距$\phi$采样毛孔位置,再将每个点与六个最近邻连接,得到基础图$G^\phi$。此时,毛孔是节点,皱纹是边。
为了在皱纹之间传递信息,作者再构造一张皱纹图$G_w^\phi$。如果两条皱纹在基础图中共享同一个毛孔,它们在皱纹图里就相互连接。论文称其为对偶图;理解时只需抓住这个具体的连接规则。
于是,GNN中的一个节点就代表一条皱纹。消息传递可以回答:邻近皱纹的状态,应当怎样影响这条皱纹接下来的深度?
用四类条件控制迭代
作者将参数以及图中的皱纹方向、长度,编码为四类潜在特征:全局特征、交互特征、距离特征和强度特征。分别记为$E_g,E_i,E_d,E_s$。
这些特征把不同作用的参数分开组织,再经过变换,与每条皱纹的当前状态共同用于更新。皱纹状态本身也表示为潜在向量$E_w$,避免每一步只能处理一个深度数值。
原论文式(7)给出残差更新:
$$ E_w^{(t)}=E_w^{(t-1)}+ \mathcal G\left(E_g'+E_i'+E_d'+E_s';G_w^\phi\right). \tag{7} $$
$\mathcal G$是基于皱纹图的图注意力卷积,带撇号的四项是经过变换、调制后送入更新的条件特征。旧状态保留下来,网络再根据参数与邻居关系预测需要增加的状态变化。
图注意力的作用,是让邻居对当前皱纹的影响具有可学习的权重。并非所有相邻皱纹都必须产生相同程度的影响。重复更新后,信息可以沿邻接关系传播,形成比独立噪声更连贯的结构。
作者使用7次迭代。随后,四层MLP解码器将最终潜在状态转成皱纹深度列表:
$$ D_w=\Phi_w\left(E_w^{(T)}\right),\qquad T=7. \tag{9} $$
若基础图有$N_p$个毛孔、$N_w$条皱纹,$D_p$和$D_w$分别记录这两组元素的深度;GNN则为每条皱纹维护一个潜在状态。输出的是与图规模对应的深度列表,而不是一个固定数量的全脸顶点。
这也解释了图4中为什么微观结构会随迭代逐步形成:更新在图上的状态最终被解码成不同皱纹的深度,再绘制为位移图。
“可微”怎样帮助调整参数?
可以把六个待优化的皱纹参数记为$\mathbf{ a }=(\theta,\mu,\delta,\sigma,\tau,\rho)$。在当前毛孔图结构固定的条件下,计算链为:参数生成皱纹深度,深度生成位移图,位移图进入损失。
按链式法则,下面的补充表达说明误差如何返回参数:
$$ \frac{\partial\mathcal L}{\partial\mathbf{ a }} =\frac{\partial\mathcal L}{\partial I_x} \frac{\partial I_x}{\partial D_w} \frac{\partial D_w}{\partial\mathbf{ a }}. $$
为简洁起见,中间经由毛孔深度的依赖合并在位移生成的总导数中。这条链让优化知道:当前图块的方向或外观偏差,应当推动哪些参数增大或减小。若只是通过离散概率决定一条皱纹是否更新,这样的直接反传就不容易实现。
这里的可微性针对给定图结构中的皱纹模拟与绘制,并不意味着采样毛孔位置、改变图的连接关系也都由同一条梯度链优化。毛孔参数由检测器提供,皱纹参数再通过梯度调整,两部分在流程中各司其职。
皱纹深度怎样决定毛孔深度?
毛孔与多条皱纹相连,因此毛孔的深度也要与邻接结构协调。本文沿用原论文预备知识中式(3)的关系:
$$ q=\max\left(d_{\max},\; d_{\max}+\beta(d_{\mathrm{sum}}-d_{\max})\right). \tag{3} $$
$d_{\max}$是邻接皱纹的最大深度,$d_{\mathrm{sum}}$是它们的深度之和,$q$是毛孔深度。
例如,若邻接深度分别为0.2、0.3和0.1,则最大值为0.3,总和为0.6。设$\beta=0.5$,按式(3)得到$q=0.45$。这个数值例子只是解释公式,不代表真实皮肤的测量单位。
$\beta$因而控制着毛孔在邻接皱纹基础上加深的程度。它不是通常意义上的图像透明度或纹理混合系数。
得到毛孔深度列表$D_p$与皱纹深度列表$D_w$后,通过可微渲染得到局部微观位移图:
$$ I_x=\mathcal F\left(D_w,D_p;G^\phi\right). \tag{10} $$
这里的“渲染”是把微观几何绘制到UV空间,输出位移图。它与后面带纹理、带环境光的人脸最终渲染不是同一个阶段。
六、为什么清晰的生成细节,不能直接和模糊照片逐像素对齐?
假设输入里一条细纹被模糊成较宽的暗带,生成器却画出一条锐利的细沟。即使两者方向一致,像素差仍然很大。若强迫它们直接逐点相等,优化可能倾向于把细节抹平,或者追逐照片中的光照变化。
作者因此提出方向分布相似性,Direction Distribution Similarity,DDS:先统计一块皮肤的细纹偏向哪些方向,再比较这些统计规律。
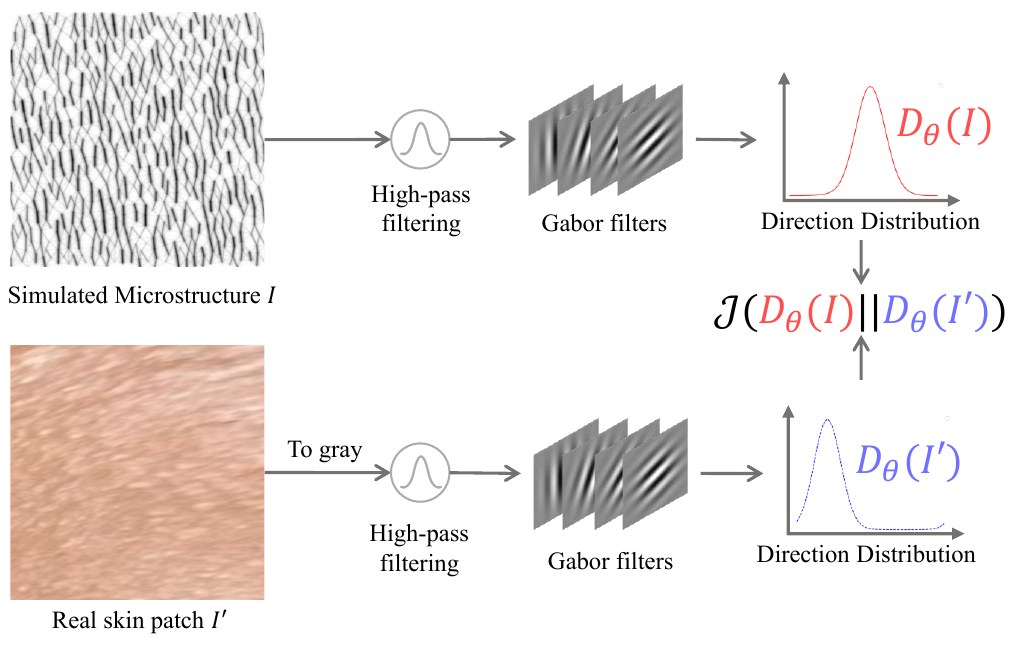
图5|对合成微观图与真实皮肤图块进行高通处理,再使用不同方向的Gabor滤波器计算方向分布,最后比较两个分布。来源:原论文图5。
第一步:用不同方向的滤波器观察细纹
Gabor滤波器可以理解为具有方向选择性的纹理探测器。调整滤波器方向,就能观察图块在相应方向上的纹理响应。
原论文式(11)定义:
$$ p(I;\theta)=\operatorname{Var}\left(f(\theta)\otimes I\right). \tag{11} $$
$f(\theta)$是方向为$\theta$的Gabor滤波器,$\otimes$表示图像卷积,$\operatorname{Var}$计算滤波结果的方差。卷积后的响应越有起伏,说明图像在该滤波方向上具有越强的结构响应。
比较前会先转换为灰度并进行高通滤波,减少缓慢变化的亮度成分影响。此处公式里的$\theta$是滤波器扫描方向;前面同名的模型参数则表示皱纹主方向,两者的使用位置不同。
第二步:把方向响应归一化
作者在$[0,\pi)$范围内统计方向,因为没有箭头的纹理朝向相隔$180^\circ$时是等价的。归一化后满足原论文式(12):
$$ \int_0^\pi p(I;\theta)\,\mathrm d\theta=1. \tag{12} $$
原文将归一化后的结果记为方向分布$D_\theta(I)$。为展开其中的计算,可以把未归一化响应临时记为$r$,则有以下补充说明:
$$ D_\theta(I) =\frac{r(I;\theta)}{\int_0^\pi r(I;\alpha)\,\mathrm d\alpha}. $$
实际离散计算时,用多个方向的响应之和代替积分。这个表达说明了方向响应如何转成可比较的分布。
归一化后,模型更关心不同方向占多少比例。如果纹理主要沿一组方向排列,分布就会在相应滤波方向上集中;如果多个方向交错,响应分布就会分散。
第三步:比较两种方向分布
原论文式(13)为:
$$ \mathcal L_{DDS}(I,I') =\mathcal J\left(D_\theta(I)\parallel D_\theta(I')\right). \tag{13} $$
$\mathcal J$是Jensen–Shannon散度。为了说明它在比较什么,可令两个离散方向分布为$P,Q$,它们的均值为$M=(P+Q)/2$,再展开这一标准定义:
$$ \mathcal J(P\parallel Q) =\frac12\sum_j P_j\log\frac{P_j}{M_j} +\frac12\sum_j Q_j\log\frac{Q_j}{M_j}. $$
这属于补充展开:两个分布相同时,每一项都趋向于零;偏向不同方向时,散度增大。优化因此会推动生成纹理的方向分布接近照片,而不要求每条清晰细纹与模糊像素逐一重合。
但这种比较也付出了代价:两个局部结构不同的图块,可能具有相近的方向统计。DDS约束的是方向分布,并没有唯一确定每条皱纹的位置。
七、有了方向,为什么还需要视觉相似性?
归一化能突出方向比例,也会减弱绝对响应强度的信息。一个方向一致但过深、过浅的皱纹图块,仍可能获得相近的方向分布。
作者因此同时加入视觉相似性$\mathcal L_{VIS}$,原论文式(6)写为:
$$ \begin{aligned} \mathcal L\left(\mathcal W(\mathbf{ x }),\mathcal W'\right) ={}&\lambda_d\mathcal L_{DDS}\left(\mathcal W(\mathbf{ x }),I'\right)\\ &+\lambda_v\mathcal L_{VIS}\left(\mathcal W(\mathbf{ x }),I'\right). \end{aligned} \tag{6} $$
DDS让细纹的方向组织接近输入,VIS则补充整体视觉统计约束。本文的VIS采用风格损失,比较若干VGG层特征的均值与方差,并对差异计算均方误差。
因此,它也不是简单的像素复制。它允许局部位置存在一定变化,同时约束纹理在感知特征上的整体表现。
作者设置$\lambda_d=10$、$\lambda_v=0.001$,优化75次。两个数值相差较大,不能直接解释成DDS“重要一万倍”,因为损失本身的数值尺度不同。
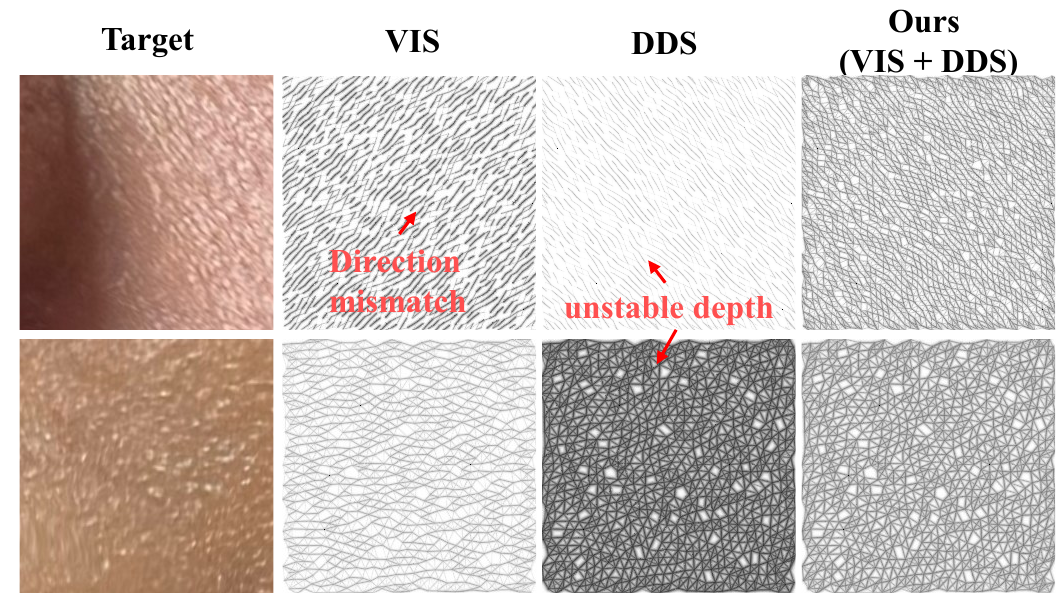
图10a|从左到右为目标皮肤图块、VIS、DDS、VIS与DDS联合优化。红字标出方向不一致和深度不稳定。来源:原论文图10左侧。
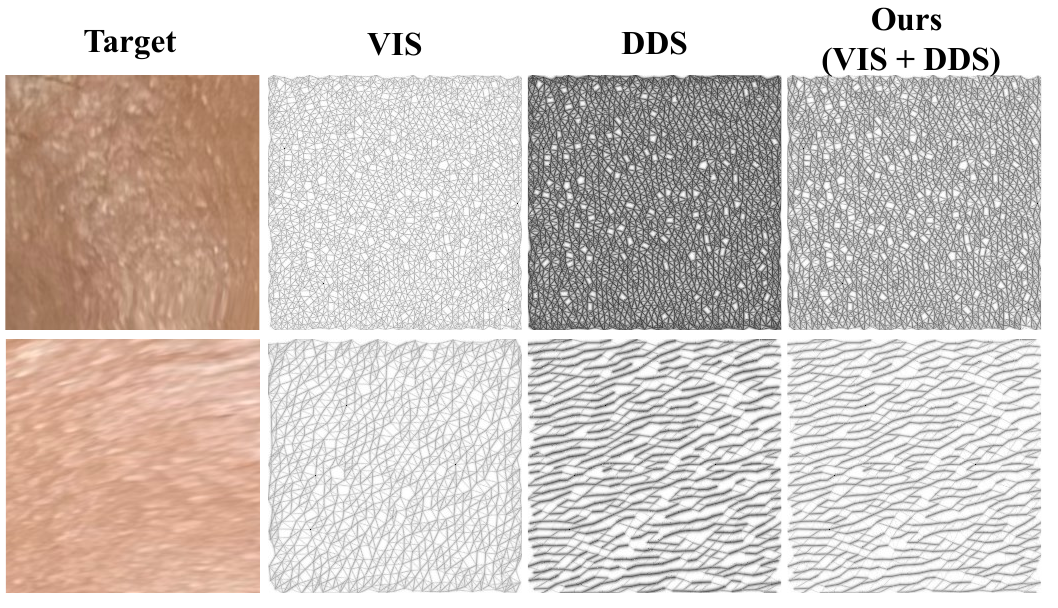
图10b|另一组图块中的方向与深度变化。来源:原论文图10右侧。
这张图把两项设计的作用分开呈现了出来。只使用VIS,可能生成视觉统计相近、方向却不对的细纹;只使用DDS,方向能对上,但深度强度容易不稳定;联合优化则尝试在两者之间取得更合适的结果。
八、网络是怎样学会模拟皱纹的?
FLEX并不是拿到一张照片后,才从零训练整个GNN。作者先用合成数据训练毛孔检测器与神经皱纹模拟器,再针对新的皮肤图块恢复参数。
| 模块 | 训练数据 | 监督目标 |
|---|---|---|
| 毛孔检测网络 | 5万个$256\times256$合成皮肤图块 | 预测毛孔参数与真值参数之间的MSE |
| 神经皱纹模拟网络 | 5万个$256\times256$微皱纹位移图,包含20种图结构 | 皱纹深度MSE、图像MSE、LPIPS三项等权损失 |
训练使用Adam,学习率为$10^{-4}$,两个网络分别训练10个epoch。在一张RTX 3090上,毛孔检测器约需5小时,神经皱纹模拟器约需18小时。
要区分三个不同层面的指标:模拟器训练中使用LPIPS,图块参数恢复时的VIS使用VGG特征均值与方差,实验表格又使用LPIPS评价结果。这三者不能都写成同一个“感知损失”。
合成训练数据提供了可控参数和对应位移图,让网络学习已有模拟中的结构规律。因此,本文使用了学习模型,但其目标是把带语义控制的图模拟变成可微过程,并不只是直接让一个生成网络输出整张人脸。
九、把局部参数铺到全脸,结果有什么变化?
优化完成后,参数散布在不同皮肤图块的位置上。径向基函数插值将这些离散样本扩展为空间变化的参数图,再使用简化的前向模型生成全脸微观位移。
这一步让不同区域保留不同属性。脸颊和额头可以具有不同的方向分布与密度,而不是共享一组固定皱纹参数。
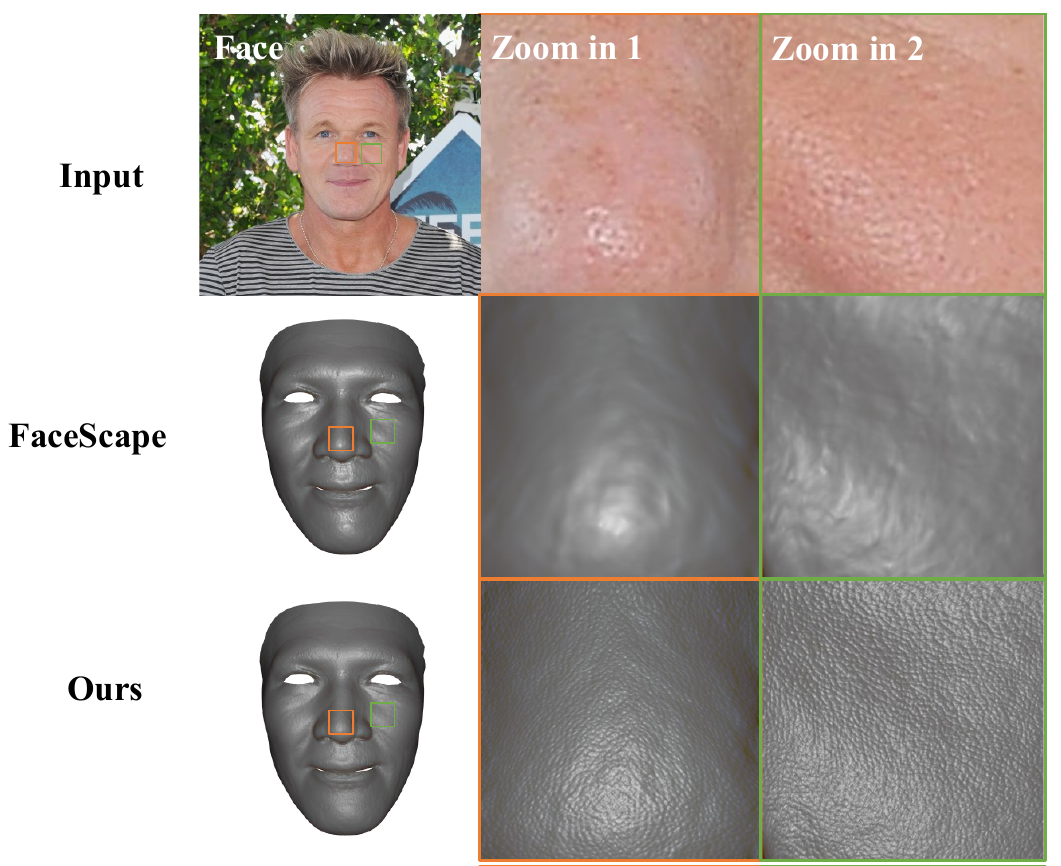
图6a|输入照片、FaceScape基础重建与FLEX补充细节后的结果。每行给出同一区域的局部放大。来源:原论文图6左上。
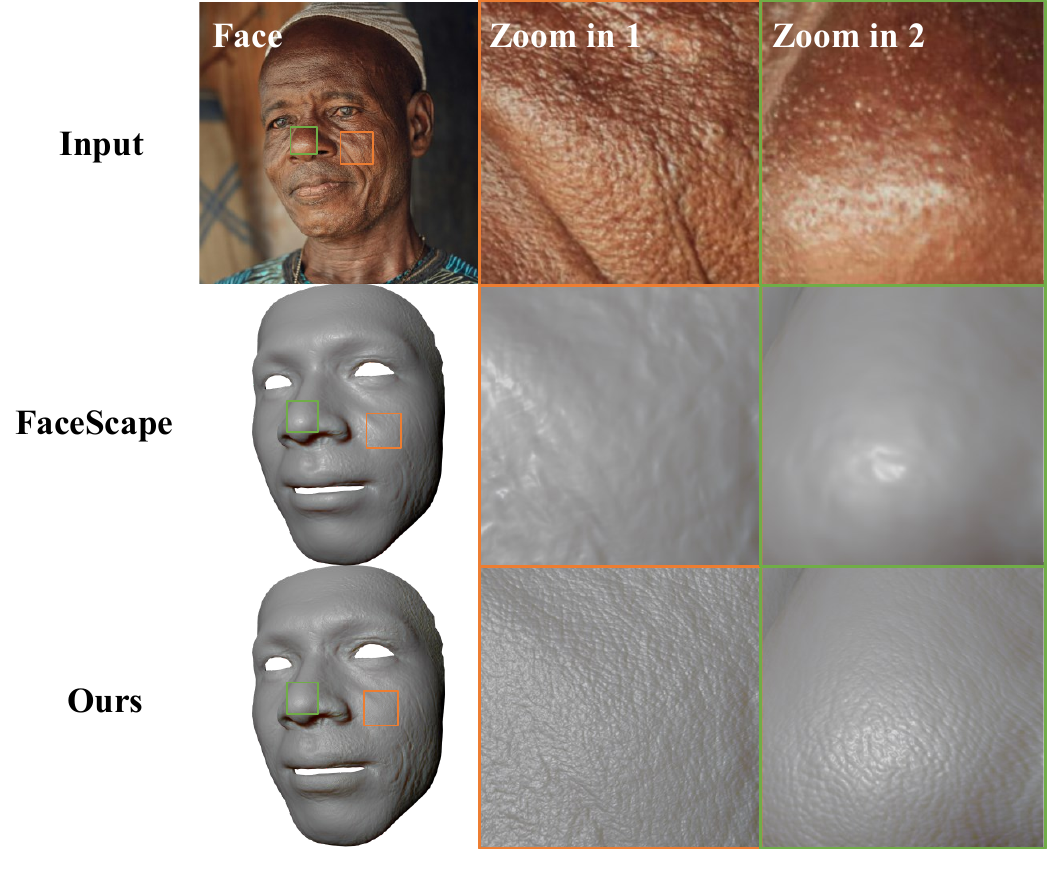
图6b|另一位人物的鼻部与脸颊细节。来源:原论文图6左下。
阅读图6时,可以先看输入里细纹的主方向与疏密,再观察合成结果是否出现相近的组织方式。论文展示的效果不只是“多了一些点”,微皱纹的走向与局部质感也更接近输入。
不过,单张照片中的阴影与高光会影响纹理可见性。图中的相似性支持外观补充的效果,不能代替对真实微观深度的逐点测量。
能否和不同基础人脸方法配合?
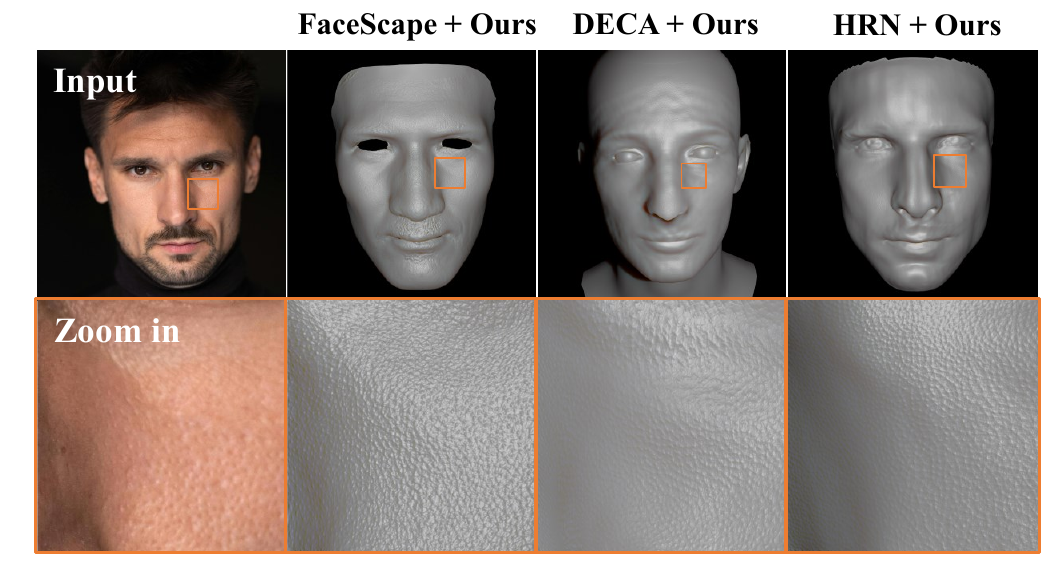
图7|相同人脸区域在三种基础重建方法上加入FLEX的结果。来源:原论文图7左侧。
这些基础方法提供的宏观形状不完全一样,但FLEX可以在相应纹理空间中合成微观位移。因此,微观细节补充与基础人脸恢复之间具有一定的模块化关系。
图7验证了几种具体方法上的集成能力,而不是对所有网格拓扑、任意遮挡或所有拍摄条件的保证。
细节加入后,重新渲染会怎样?
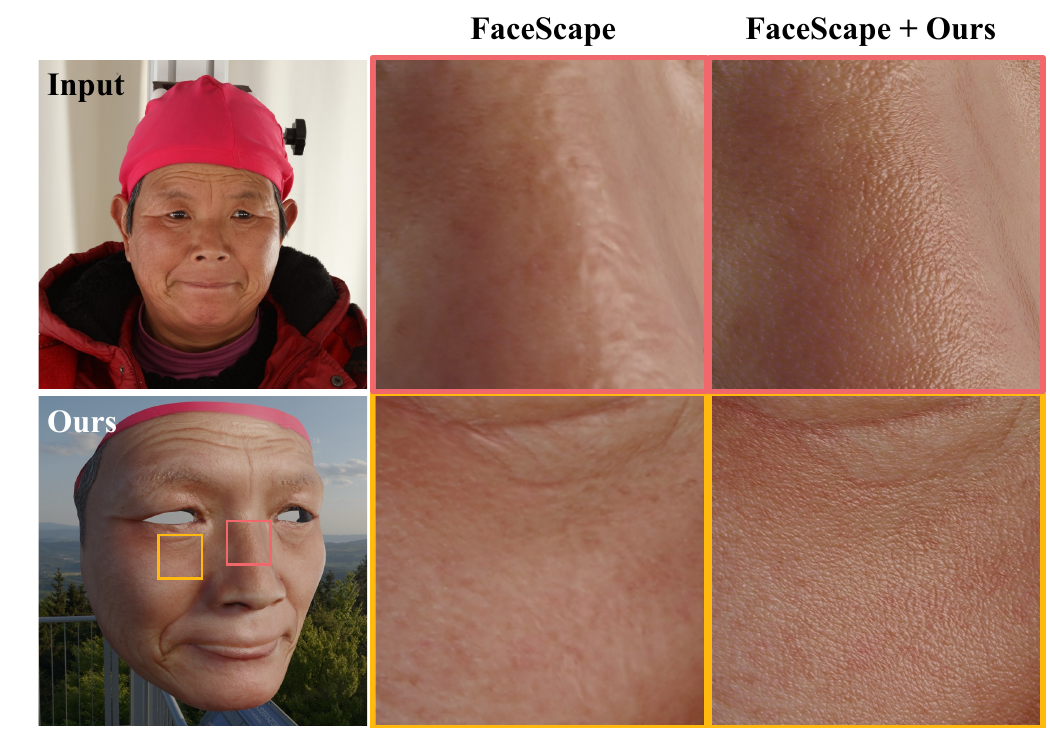
图8a|比较FaceScape与加入FLEX后的两处皮肤局部。来源:原论文图8左侧。
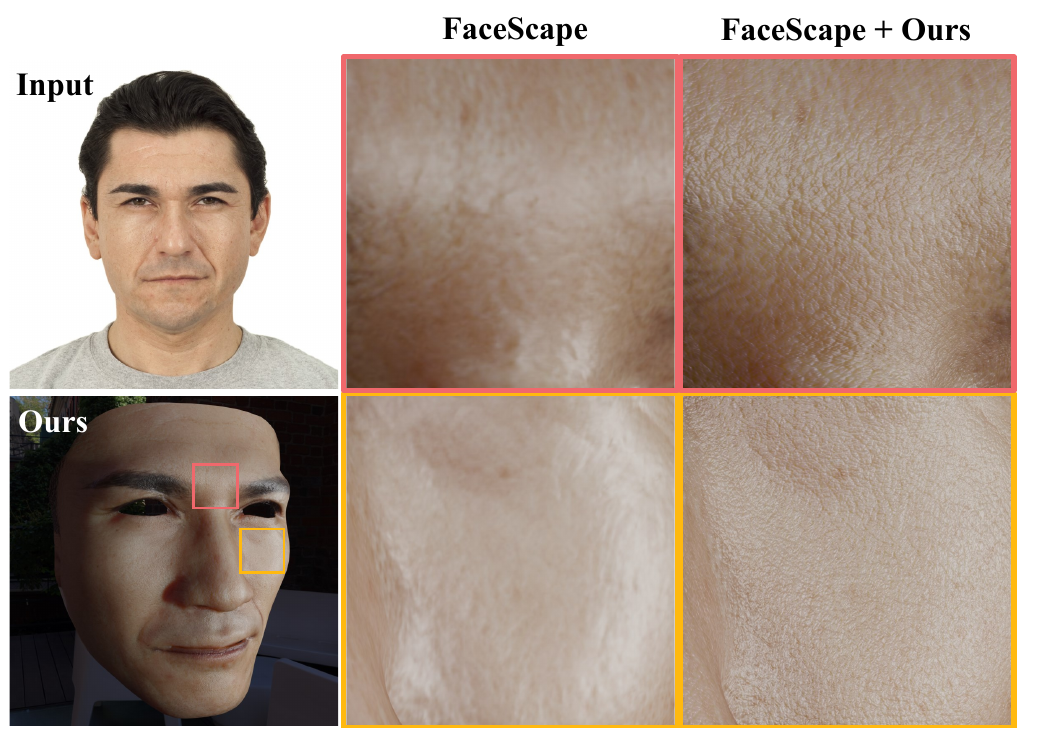
图8b|另一组环境光渲染中的微观细节。来源:原论文图8右侧。
与单纯给纹理加噪声相比,位移细节可以影响局部表面受光。图8中,加入细节后,皮肤表面的细密变化更加明显,较平滑的基础结果也因此获得了更多近景质感。
使用高质量纹理时,能合成怎样的结构?
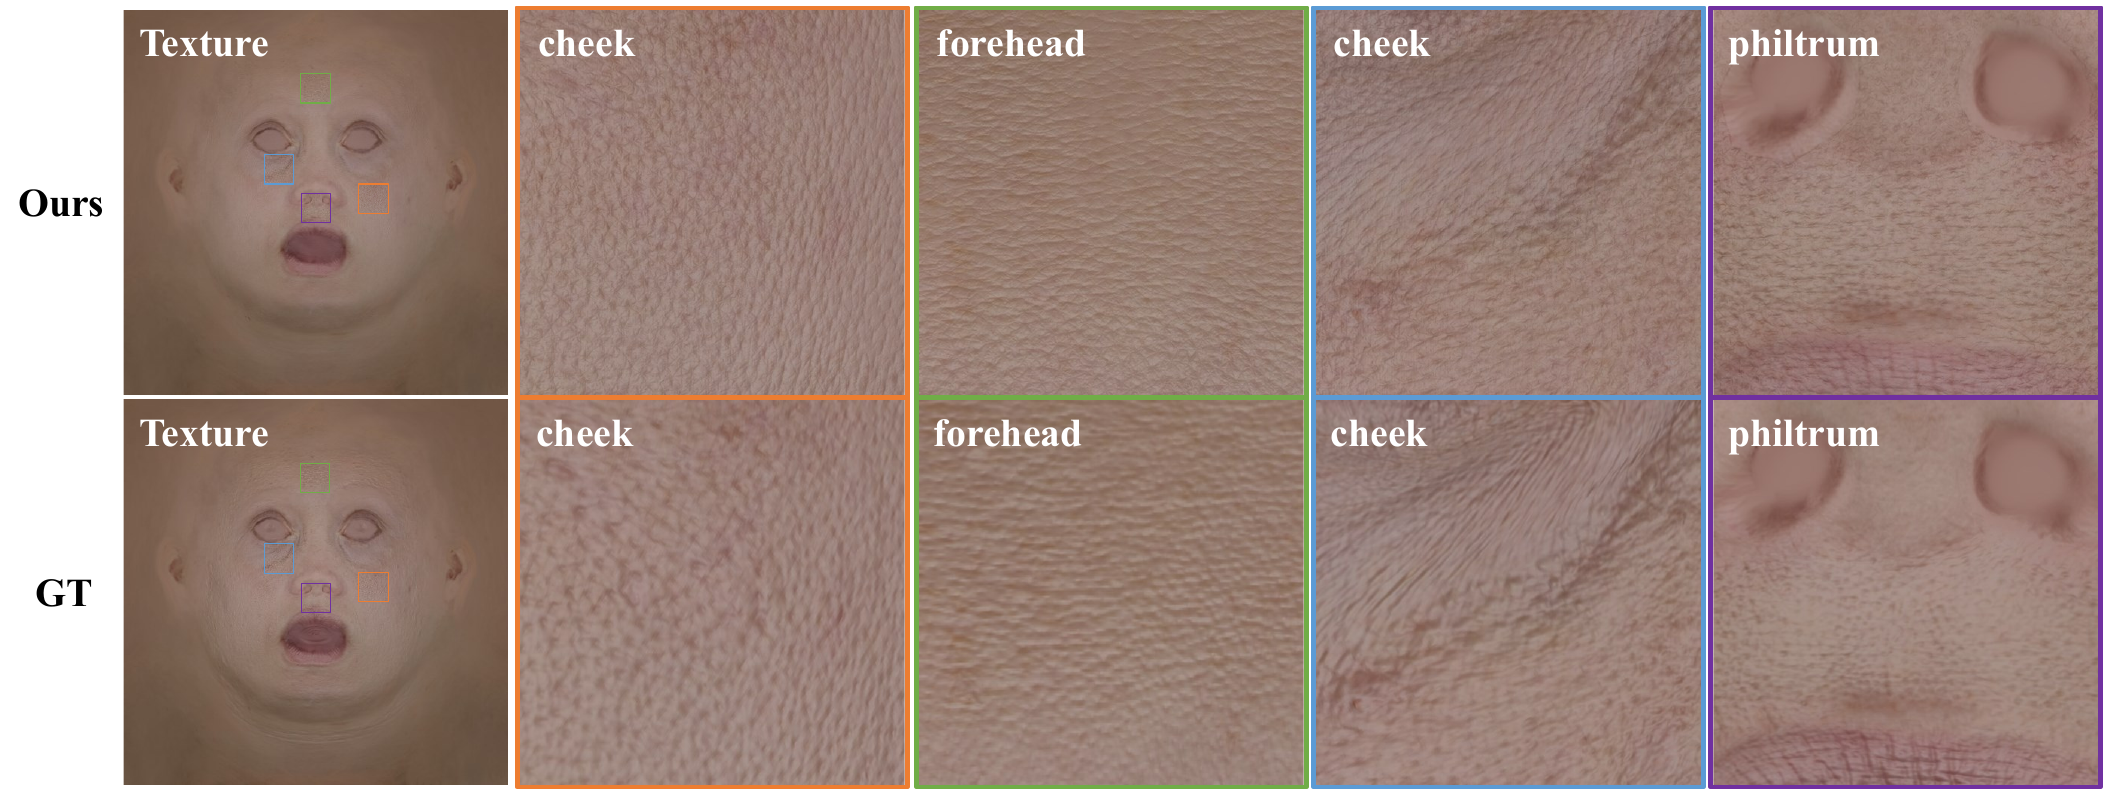
图9|上排为本文合成位移产生的结果,下排使用Digital Emily项目的参考位移;放大展示脸颊、额头和人中区域。来源:原论文图9。
这组实验将从普通人像提取的纹理替换为高质量参考纹理,再比较合成微结构与参考位移渲染。它更便于观察空间变化的皮肤质感。
其中的输入条件比普通照片更理想,因此不能把这一组结果直接当成“从任意模糊人像精确恢复扫描几何”的证据。它展示的是:当可用纹理更充分时,模型能够生成具有相应局部变化的结构。
十、数字结果支持了什么?
合成数据上的视觉误差与参数误差
作者从合成验证集中随机选取1000个皮肤图块,比较五种策略。Uniform使用估计的毛孔间距与固定皱纹参数;Noise使用已有噪声模型;另外两种分别只使用DDS或VIS。
| 指标↓ | Uniform | Noise | 仅DDS | 仅VIS | FLEX:DDS+VIS |
|---|---|---|---|---|---|
| LPIPS | 0.3984 | 0.6864 | 0.3073 | 0.4282 | 0.3019 |
| 参数MSE | — | — | 0.0919 | 0.2603 | 0.0933 |
原论文表3数据重排。两项指标均越小越好;“—”表示原文未提供对应参数比较。
LPIPS衡量合成微观位移图与参考位移图之间的感知差异;参数MSE则比较优化参数与合成真值参数。两者分别回答“生成结构看起来是否相近”和“参数是否接近已知目标”。
FLEX的LPIPS最低,说明在这组合成验证数据上,联合损失具有最好的感知相似性。仅DDS的参数MSE反而略低,为0.0919;FLEX为0.0933,排在第二。这是一个值得保留的结果:感知外观更接近,并不要求所有参数误差同时最低。
与Uniform相比,FLEX的LPIPS相对降低约24.2%,计算为$(0.3984-0.3019)/0.3984$。与仅DDS相比,下降约1.8%。联合VIS对该指标的增益较小,但图10中对深度稳定性的补充说明了它的作用。
这些是合成数据上的结果,不能直接转换成真实人脸毛孔的毫米误差。真实照片实验主要依靠外观展示与用户研究,论文没有报告逐点微观几何真值距离。
用户是否更偏好这种皮肤外观?
用户研究包含42位参与者,每位至少评价22组成对图块,从中选择更真实的一张。
| 获胜方法\对手 | FLEX | Uniform | Noise | 总获胜次数↑ | 原表PageRank↓ |
|---|---|---|---|---|---|
| FLEX | 0 | 216 | 246 | 462 | 0.2304 |
| Uniform | 162 | 0 | 162 | 324 | 0.2472 |
| Noise | 90 | 48 | 0 | 138 | 0.5224 |
原论文表2。单元格表示行方法战胜列方法的次数,PageRank的优劣方向按原表保留。
FLEX与Uniform的成对比较中,FLEX获胜216次,Uniform获胜162次,胜率约57.1%;与Noise比较时,FLEX胜率约73.2%。这些结果支持相较固定皱纹参数和噪声,针对图像调整参数能改善被试感受到的真实感。
但这种偏好也有程度差异。与Uniform相比,FLEX占优,却并非压倒性胜出。统计对象还是图块外观偏好,不能将它表述为恢复身份特定微观几何的准确率。
十一、约2秒的速度,具体快在什么地方?
论文性能部分给出的平均耗时是:单个皮肤图块的参数恢复约2.35秒。作为比较,Weiss等人2023年的参数优化超过140秒,按$140/2.35$计算约为60倍量级。
这部分提速与可微模拟有关。模型有了可用于反向传播的参数—结构关系后,可以用梯度下降调整皱纹参数,而不必沿用原有的粒子群参数搜索。
这个时间不包含从照片完成基础人脸恢复、处理全部图块、生成整脸参数图和最终渲染的完整耗时。两个网络的预训练成本也另行存在。因此,“约2秒恢复单个图块参数”是清楚且有依据的表述,“2秒完成整脸毛孔重建”则超出了论文报告。
十二、这套方法在哪些情况下仍然有限?
凹陷模型无法表达所有皮肤细节
本文将微皱纹和毛孔建模为凹陷。鼻尖等区域的皮脂丝或其他凸起结构,不属于这一表示范围。生成的细节再丰富,也受限于模型能够表达的几何类型。
未知光照仍会影响参数判断
普通照片里的皮肤纹理受到照明和观察角度影响。同一块皮肤在侧光下可能细纹明显,在正面柔光下则接近平滑。作者明确指出,不能保证不同照明下估计出的微观结构一致。
“无约束输入”因此描述的是拍摄环境不要求预先受控,不意味着模型已经分离了任意照明与真实微观几何。实验选取的人像仍需具有可见的皮肤纹理,且脸部没有覆盖物。
参数先验能补细节,也会限制细节
图结构与合成训练数据让模型生成有组织的微皱纹,但输出也受到该模拟体系的约束。在照片没有提供足够信息的区域,合成结果更依赖先验。
从研究角度看,需要区分三件事:近景渲染更真实、统计外观接近照片、真实微观几何被准确恢复。本文对前两项提供了实验支持,第三项仍需要独立几何测量来验证。
动态表情也是作者提出的后续方向。本文没有建立一套已经验证的动态微结构跟踪流程,不能据此假定微皱纹在拉伸、收缩时都能保持正确的时间变化。
十三、这篇论文值得借鉴的研究思路
FLEX把一个不容易直接求解的问题拆成了两个彼此配合的设计:用图结构约束微皱纹与毛孔的组织方式,再用方向统计比较模糊输入与清晰生成结果。前者让生成有结构,后者让优化不必追逐已经无法逐点对应的细节。
另一个值得借鉴的选择,是把网络用于替代参数优化中困难的一段计算。GNN学习邻接皱纹之间的交互,语义参数与显式图关系仍然保留,因此结果既能优化,也具有一定的控制能力。
对于人脸精细重建,本文提供了一个实用的细节补充模块。若进一步将它用于偏振或高斯人脸重建,以下属于延伸思考:可以研究如何用额外观测约束这些合成细节,以及如何验证它们在新光照、不同视角下是否仍对应合理几何。本文展示的合成真实感,为后续研究提供了起点;真实毛孔位置、深度与动态变化的精度,则需要各自的验证。
