
 洗子
 匿名

拍下一张人脸照片,能不能同时知道皮肤本来的颜色、哪里更容易反光、哪里的高光更尖锐,以及毛孔和细纹朝哪个方向起伏?
这些信息都影响一张脸的真实感,却混在同一张照片里。额头亮,可能因为皮肤反射更强,也可能因为光源刚好映在额头上;高光变宽,可能是表面更粗糙,也可能是光源本来就很大。要把这些因素拆开,传统采集系统通常会不断切换灯光,让同一个人配合拍摄多张照片。
这篇论文换了一种办法:把原本需要分时测量的照明信息,编码进同一次拍摄中的红、绿、蓝三个通道。 再用偏振先分开漫反射与镜面反射,从三个颜色读出反射响应的均值、起伏幅度和相位,分别用于恢复反射强度、粗糙度与细节方向。
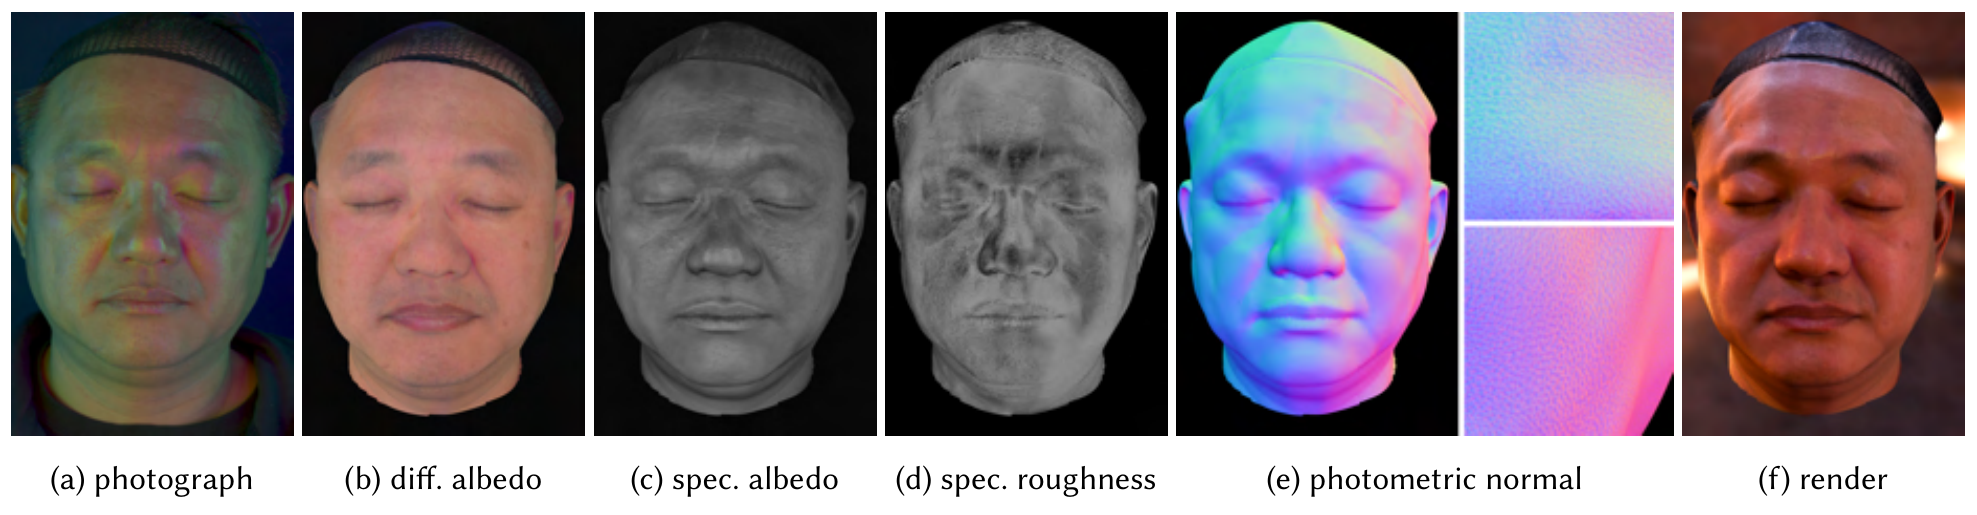
图1|从彩色照明下的人脸观测,得到漫反射反照率、镜面反照率、镜面粗糙度和光度法线,并在新的环境光下渲染。来源:原论文图1。
先把“单次”说清楚:实验装置使用15台相机,在一种固定的RGB正弦照明下从不同视角采集。它减少的是切换照明图案的需要,并不是用一张普通手机自拍完成全部重建。输出中的毛孔级明暗细节,也主要由法线与材质贴图表达,并不意味着基础三维网格已经逐个恢复了毛孔形状。
论文信息
| 项目 | 内容 |
|---|---|
| 英文标题 | Single-Shot Facial Capture using Polarized RGB Sinusoidal Illumination |
| 中文标题 | 使用偏振RGB正弦照明的单次人脸采集 |
| 发表 | SIGGRAPH Asia 2025 Conference Papers |
| 作者 | Arvin Lin、Abhijeet Ghosh |
| 机构 | Imperial College London、Lumirithmic |
| 项目主页 | https://wp.doc.ic.ac.uk/rgi/project/single-shot-facial-capture-using-polarized-rgb-sinusoidal-illumination/ |
| 代码 | 官方项目页未列出公开代码入口 |
| 关键词 | 人脸外观采集、偏振成像、RGB复用、正弦照明、反射分解、粗糙度、光度法线 |
一、想让数字人换一盏灯,为什么先要把高光拆开?
一张照片记录的是“这张脸在此刻照明和视角下看起来怎样”。可重打光的人脸模型则需要回答另一件事:光换了之后,它应该怎样反射?
这要求模型保留几类不同的信息。
| 输出 | 描述什么 | 在渲染中的作用 |
|---|---|---|
| 漫反射反照率 | 漫反射部分的本征颜色与反射比例 | 避免把原照片中的阴影直接画进肤色 |
| 镜面反照率 | 镜面反射分量的强度参数 | 描述不同位置反光强弱的变化 |
| 镜面粗糙度 | 微表面朝向分散的程度 | 控制高光集中还是扩散 |
| 光度法线 | 由光照响应推断的局部表面方向 | 表达毛孔、细纹带来的细小明暗变化 |
这里最容易混淆的是镜面反照率和粗糙度。前者主要影响反射的强弱,后者影响反射在方向上的分布。只观察一张普通高光照片,两者可能互相补偿:降低反射强度、调整粗糙度,都可能让某些像素变暗。
如果把所有参数一起交给逆渲染优化,最终图像可能拟合得不错,但内部参数未必分得清。某条纹理究竟被放进了颜色、粗糙度还是法线,往往受到初始化和先验影响。
作者的目标,是让照明本身提供更有区分力的测量。先通过偏振隔离镜面反射,再观察它如何响应一个带有已知频率和相位的彩色光场。这样,亮度不再只有“亮或暗”,还携带了反射分布的信息。
二、采集系统:偏振先分成分,RGB再分相位
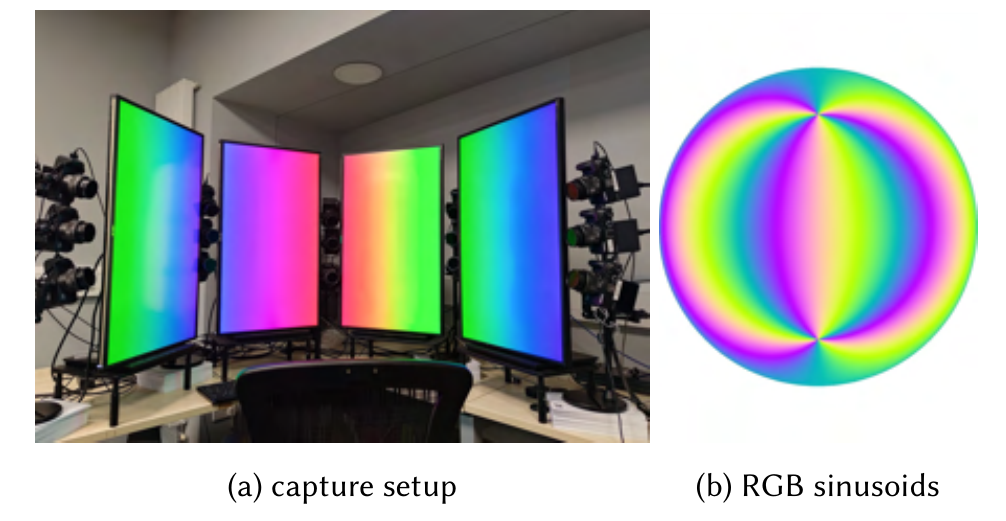
图2|左侧是屏幕与多相机装置,右侧通过镜面球展示RGB正弦光场的方向分布。来源:原论文图2。
装置采用LCD屏幕照明,利用其线偏振特性。15台单反相机分成5列,每列上、中、下各一台,每台镜头前安装偏振滤镜。
中间一排相机与照明交叉偏振,主要采集漫反射;上、下两排与照明平行偏振,采集漫反射与镜面反射的混合响应。
直观地说,皮肤表面反射较多保留入射光的偏振状态,而进入皮肤内部散射的光会发生去偏振。因此,交叉偏振可以显著抑制表面高光,让系统先获得相对独立的漫反射观测。这里采用的是论文的反射分离近似,不是完整的皮肤偏振散射模型。
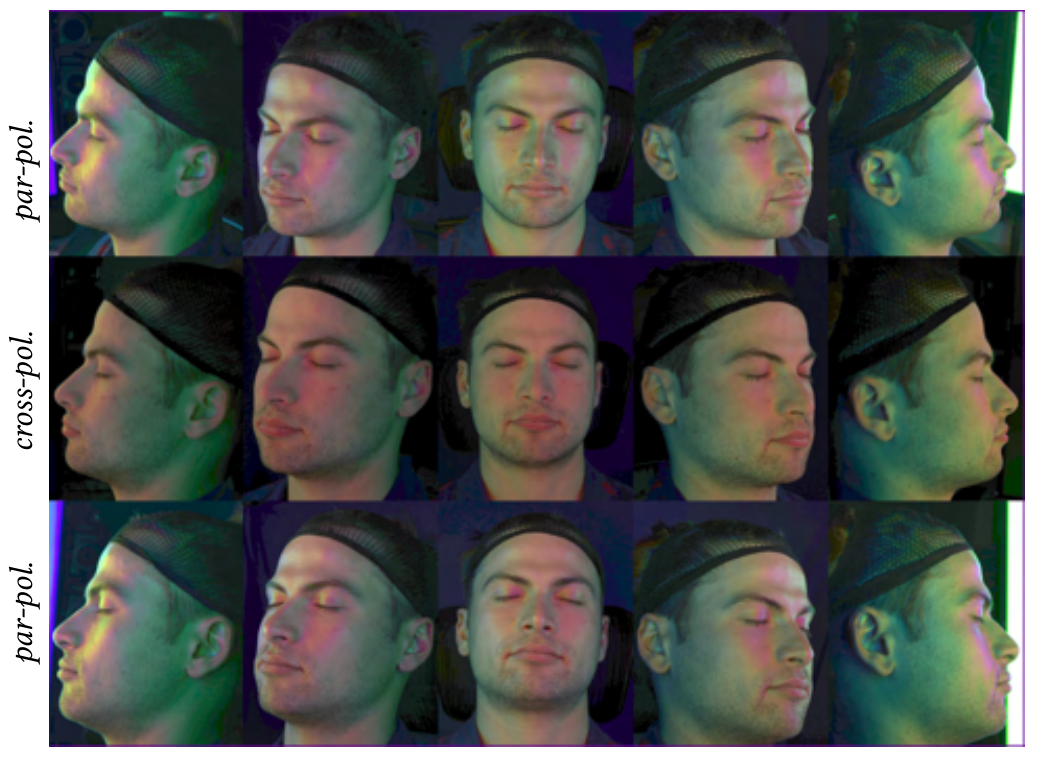
图3|上、下两排保留高光,中间一排抑制高光。多视角观测还需要投影到共同的表面坐标中,才能比较同一块皮肤。来源:原论文图3。
接下来,作者不让屏幕显示均匀白光,而是沿球面经度方向改变照明颜色。设入射方向为$\boldsymbol\omega=(\phi,\theta)$,其中$\phi$是照明方向的方位角,原论文式(1)为:
$$ I(\boldsymbol\omega)= \begin{cases} R:\ \cos(3\phi)+1,\\ G:\ \cos(3\phi+120^\circ)+1,\\ B:\ \cos(3\phi-120^\circ)+1. \end{cases} \tag{1} $$
三个通道具有相同的角频率,却相差120°。加上的常数1让照明保持非负,同时提供一个恒定的亮度基底。
可以把它想成三条沿同一方向起伏的光带,红、绿、蓝的峰值依次错开。一块皮肤反射不同方向的光时,会以不同权重混合这些光带,最终形成一个RGB响应。
普通照片把RGB主要当颜色;这里还把RGB当作三次相位测量。 这也是它能在不切换灯光的情况下获得额外信息的原因。
但两件事必须提前处理:相机通道之间的串扰,以及不同相机之间的表面对应关系。
三、先校准,再对齐:不能直接拿原始RGB套公式
1. 颜色通道并不是天然互不干扰
屏幕发出的“红光”,不一定只被相机红通道接收。光源具有一定的光谱宽度,相机通道也有重叠的光谱灵敏度。直接把原始RGB当成三个独立相位,就可能把通道串扰误读为材料变化。
原论文式(2)用一个$3\times3$矩阵表示这种耦合:
$$ c_{i,j}=\int_\Lambda P_j(\lambda)S_i(\lambda)\,d\lambda. \tag{2} $$
$P_j(\lambda)$表示第$j$个照明通道的光谱功率分布,$S_i(\lambda)$表示相机第$i$个通道的灵敏度。积分衡量的是“第$j$种照明会被第$i$个相机通道收到多少”。
随后按照原论文式(3)校正颜色向量:
$$ \mathbf{ c }'=(C^{-1})^T\mathbf{ c }. \tag{3} $$
这里保留原文的矩阵约定。实际系统为每台相机拍摄色卡,测量对应的颜色校正矩阵。后续相位分析建立在经过校准的观测上。
2. 不同视角必须指向同一块皮肤
15台相机并没有拍到完全相同的像素排列。左侧相机看到的鼻翼,与正面相机中的鼻翼,需要先建立对应。
作者首先用NeuS重建基础几何。虽然彩色图像携带光度信息,但实验发现,把输入转为灰度、减弱彩色照明差异,能得到伪影更少的基础几何。
之后展开UV,将三维表面映射到二维纹理坐标。各相机的照片投影到这张共同的“皮肤地图”中,同一个UV位置才代表同一处表面。
系统汇集5台交叉偏振相机的观测,得到共享的漫反射颜色,再从各平行偏振视角的测量中分离出镜面分量,形成10幅视角相关的镜面UV图。
这不是把不同视角的原始照片逐像素直接相减,而是在几何对应和校准之后,比较同一处表面的反射。
四、核心公式:三个颜色怎样给出均值、振幅和相位?
完成反射分离后,作者用下面的余弦响应描述一个像素在不同照明相移下的镜面反射。原论文式(4)为:
$$ E(\varphi)=\rho+A\cos(\varphi-\hat\varphi). \tag{4} $$
先区分两个容易混的符号:$\phi$是光源在空间中的方位角,$\varphi$是人为设置的照明相移。RGB分别提供$0^\circ$、$120^\circ$、$-120^\circ$的相移观测。
这条式子有三个未知量:$\rho$是平均响应,包含镜面反照率与菲涅耳效应;$A$是响应随相移变化的振幅;$\hat\varphi$是相位偏移,与占主导的反射方向有关。
为什么三个颜色就能求出它们?下面把式(4)展开。这里的代数推导用于解释原式,不是论文另外提出的编号公式。
令校准并分离后的三个镜面观测为$e_R,e_G,e_B$。将三个相位代入:
$$ \begin{aligned} e_R&=\rho+A\cos\hat\varphi,\\ e_G&=\rho-\frac{A}{2}\cos\hat\varphi +\frac{\sqrt3 A}{2}\sin\hat\varphi,\\ e_B&=\rho-\frac{A}{2}\cos\hat\varphi -\frac{\sqrt3 A}{2}\sin\hat\varphi. \end{aligned} $$
三式相加,所有起伏项刚好抵消:
$$ \rho=\frac{e_R+e_G+e_B}{3}. $$
再取两组差分,分别提取余弦和正弦分量:
$$ a=\frac{2e_R-e_G-e_B}{3}=A\cos\hat\varphi, \qquad b=\frac{e_G-e_B}{\sqrt3}=A\sin\hat\varphi. $$
于是:
$$ A=\sqrt{a^2+b^2}, \qquad \hat\varphi=\operatorname{atan2}(b,a). $$
这组关系揭示了方法的实际信息来源。三个颜色不是三份随意的亮度,而是三个已知相位位置的采样;通过平均与差分,能分别取出基底、起伏强度和起伏位置。
不过,要把跨颜色的观测放入同一个余弦模型,还依赖一个重要前提:皮肤是介电材料,其镜面反射在这里近似视为无色。漫反射具有明显的肤色差异,所以作者先利用偏振把两者分开,再在镜面分量中做相位分析。
五、漫反射:为什么彩色照明下也能估计本来的肤色?
交叉偏振去掉了大部分高光,却不会自动去掉照明颜色。如果脸的一侧受红光照得更多,拍到的漫反射颜色也可能偏红。
作者利用了频率为3的正弦照明在理想条件下的积分性质。原论文式(5)针对凸表面、满球面照明与漫反射模型,将一个通道的观测写为:
$$ \begin{aligned} c_i &=\int_\Omega\frac{\rho_{d,i}}{\pi} \left[\cos(3\phi+\varphi_i)+1\right] \cos\hat\theta\,d\omega\\ &=\rho_{d,i} +\int_\Omega\frac{\rho_{d,i}}{\pi} \cos(3\phi+\varphi_i)\cos\hat\theta\,d\omega\\ &=\rho_{d,i}. \end{aligned} \tag{5} $$
$\rho_{d,i}$是第$i$个通道的漫反射反照率,$\hat\theta$是入射方向与表面法线的夹角。第一项来自均匀照明基底;第二项来自正弦起伏。
按论文采用的理想照明分析,后者积分为零,留下漫反射反照率。这解释了频率为什么不能随便选:作者选择$f=3$,是为了满足漫反射估计需要,同时避免更高频率使镜面估计更复杂。
关键在于,屏幕装置并不覆盖完整球面。头顶和下巴底部缺少足够的入射光,原本应相互抵消的方向贡献也不完整。此时测到的颜色仍包含彩色着色。
因此,实际流程会在虚拟场景中复现屏幕照明,用具有均匀反照率的基础人脸几何渲染出着色因子,再用它校正交叉偏振观测。
这一步依赖几何和照明建模的准确性。真实皮肤还存在未被显式建模的次表面散射,因而校正后仍可能残留色偏。后面的实验确实显示了这一点。
六、粗糙度:为什么要看“振幅÷均值”?
镜面较光滑时,反射集中在较窄的方向范围,正弦光场的峰谷更容易被保留下来,响应起伏明显。表面更粗糙时,镜面反射把更宽方向范围的光混合在一起,光场的起伏被平滑,振幅下降。
但只看振幅$A$还不够:反射本来较弱,也会使振幅变小。
作者因此采用归一化比值:
$$ \gamma=\frac{A}{\rho}. $$
在采用的模型和校准条件下,镜面反射整体增强时,均值与振幅会共同变化;取比值能够减少绝对强度的影响,突出反射分布对正弦信号的平滑程度。
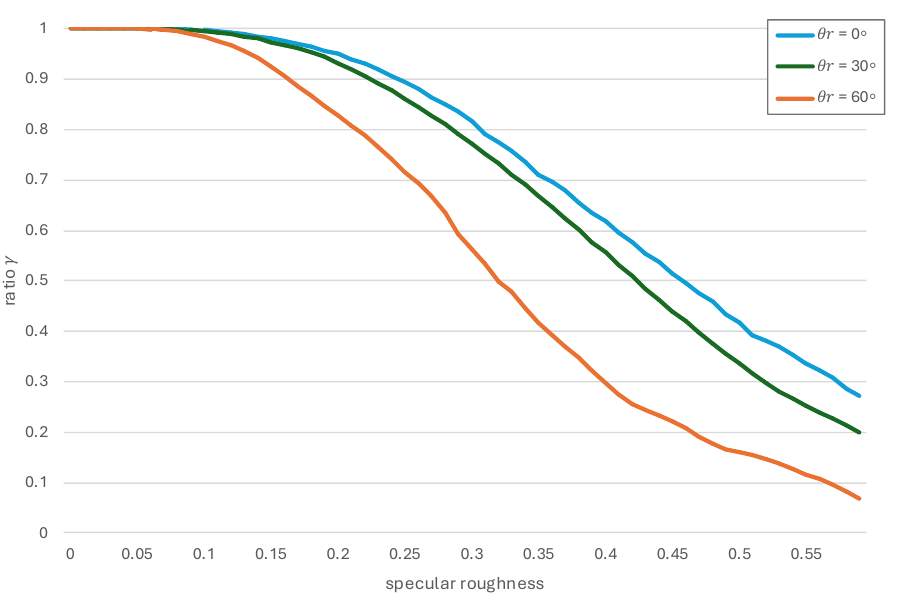
图4|不同反射极角下,$\gamma$随粗糙度变化的曲线。不同角度的曲线并不重合,因此仅凭比值不能唯一确定粗糙度。来源:原论文图4。
同一个粗糙度,在不同反射方向下也会产生不同的比值。所以作者没有把$\gamma$直接当成粗糙度,而是建立二维查找表:
$$ \sigma=\operatorname{LUT}(\gamma,\theta_r). $$
这是对查表过程的说明性写法。其中$\sigma$是镜面粗糙度,$\theta_r$是反射方向相对赤道面的角度;论文规定反射方向位于赤道面时$\theta_r=0$。
查找表通过Blender生成:在同样的彩色正弦照明下,使用GGX微表面BSDF渲染不同粗糙度的参考球,记录各个反射角度上的$\gamma$。真实测量时,先拟合$\rho,A,\hat\varphi$,再利用反射方向查出对应粗糙度。
与此同时,$\rho$还需要根据观察角度和估计法线补偿菲涅耳效应,才能得到视角无关的镜面反照率$\rho_s$。因此,这里的“分开估计”意味着不再把材质与法线全部放进同一个联合拟合问题,并不意味着所有输出之间完全没有依赖。
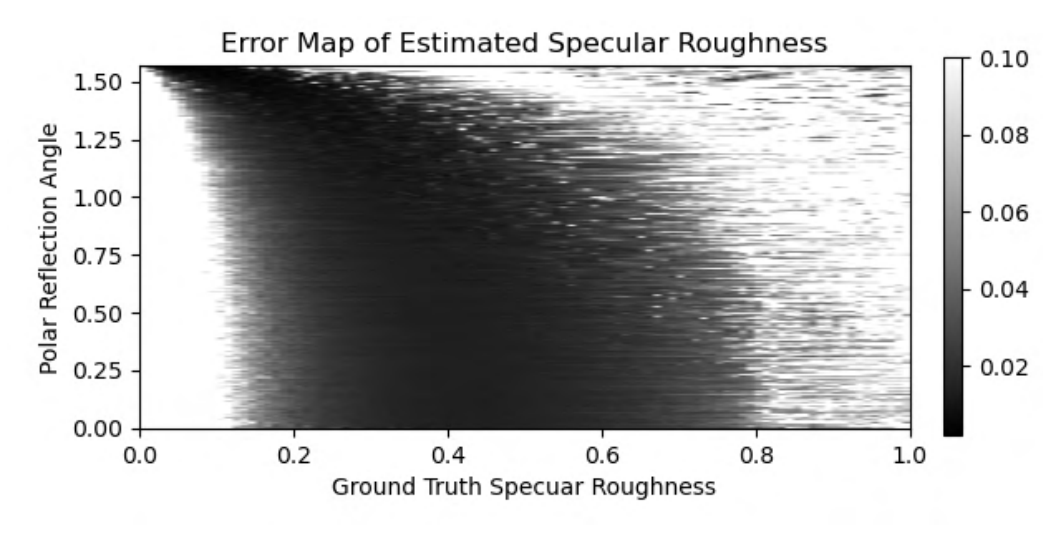
图5|横轴为真实粗糙度,纵轴为反射极角,颜色表示估计误差,超过0.1的部分被截断显示。来源:原论文图5。
噪声分析给出了这个测量的适用边界。在论文采用的噪声假设下,粗糙度约在0.1—0.7范围内通常较可靠,接近赤道的反射方向可支持更宽的范围。
这不是“所有皮肤、所有角度都保证达到同一精度”。当镜面响应太弱,或比值对粗糙度变化不再敏感,测量就更容易受噪声影响。实际系统记录16位RAW,有助于保留测量信息,但不能消除照明覆盖不足造成的欠约束。
七、法线:相位告诉我们方向,但一个视角还不够
反射相位$\hat\varphi$与主要反射方向有关。不过,一个相位值不能独立确定三维法线;光场还具有周期性,不能直接把相位数值当作表面朝向。
论文针对理想球面照明和实际屏幕照明,采用了两条不同的法线恢复路径。
1. 球面照明:让多个视角共同约束法线
在照明覆盖充分时,不同相机可以稳定测量同一处表面的反射相位。原论文式(6)为:
$$ \min_{\mathbf{ n }}\sum_c \left[\Phi(\mathbf{ n },\mathbf{ v }_c)-\hat\varphi_c\right]^2. \tag{6} $$
$\mathbf{ n }$是待估计的法线,$\mathbf{ v }_c$是第$c$台相机的观察方向,$\hat\varphi_c$是实测相位。函数$\Phi$根据候选法线和观察方向,预测该相机应看到的相位。
求解过程就是不断寻找一个表面朝向,使它在多个视角下预测出的相位,都尽量接近实际测量。基础几何与多视角信息提供了恢复细节所需的上下文。
这也说明,论文并非完全没有优化:基础几何由NeuS训练得到,理想照明下的光度法线也需要求解。它减少的是反射参数纠缠的联合估计,而不是取消整个重建流程中的数值求解。
2. 屏幕照明:保留基础方向,再嵌入高频细节
实际屏幕在垂直方向覆盖有限,部分表面接收不到足够光照。此时,相位还可能受到近场照明偏差影响,直接融合多视角相位反而容易产生噪声。
作者因此采用细节嵌入,也就是normal embossing:让基础几何负责较稳定的大尺度方向,再把观测中的高频变化加入反射方向图。
这个过程分别处理反射方向的方位角$\phi_r$和极角$\theta_r$。方位角细节来自相位图$\hat\varphi$;极角细节则利用有限照明下镜面强度的衰减。
原论文式(7)给出近似关系:
$$ \rho=\rho_s\cos\theta_r. \tag{7} $$
可以把屏幕理解为主要围绕人脸横向分布的光源。当反射方向向上或向下偏离这片照明带,能够接收的镜面能量下降。即使材料不变,测得的镜面响应也会减弱。
如果局部镜面反照率$\rho_s$近似不变,对上式求微分即可得到:
$$ d\rho=-\rho_s\sin\theta_r\,d\theta_r. $$
原论文式(8)将左侧记为$d\hat\rho_s$,表示测量响应中的局部高频变化:
$$ d\hat\rho_s=-\rho_s\sin\theta_r\,d\theta_r. \tag{8} $$
符号虽然换了,这里的操作含义是:在局部材质近似不变的前提下,用测得的亮度起伏推断反射极角的细小变化,而不是直接把它解释为真实材质参数的变化。
由此,系统先从基础几何和视角计算反射方向,再分别加入相位提供的方位角细节,以及强度提供的极角细节。得到更新后的反射方向$\mathbf{ r }'$,便可通过它与观察方向的半向量恢复法线。按两向量均指离表面的约定,其几何关系可写为:
$$ \mathbf{ n }'=\frac{\mathbf{ r }'+\mathbf{ v }} {\|\mathbf{ r }'+\mathbf{ v }\|}. $$
这条半向量关系是对论文文字步骤的补充解释。
细节嵌入提高了实际装置中的稳定性,但也引入局部材质近似均匀等假设。如果真实反照率在小范围内发生变化,它与几何起伏仍可能相互混淆。微分关系在$\sin\theta_r$很小时也会变得敏感,不能理解为任意位置都能稳定进行简单除法。
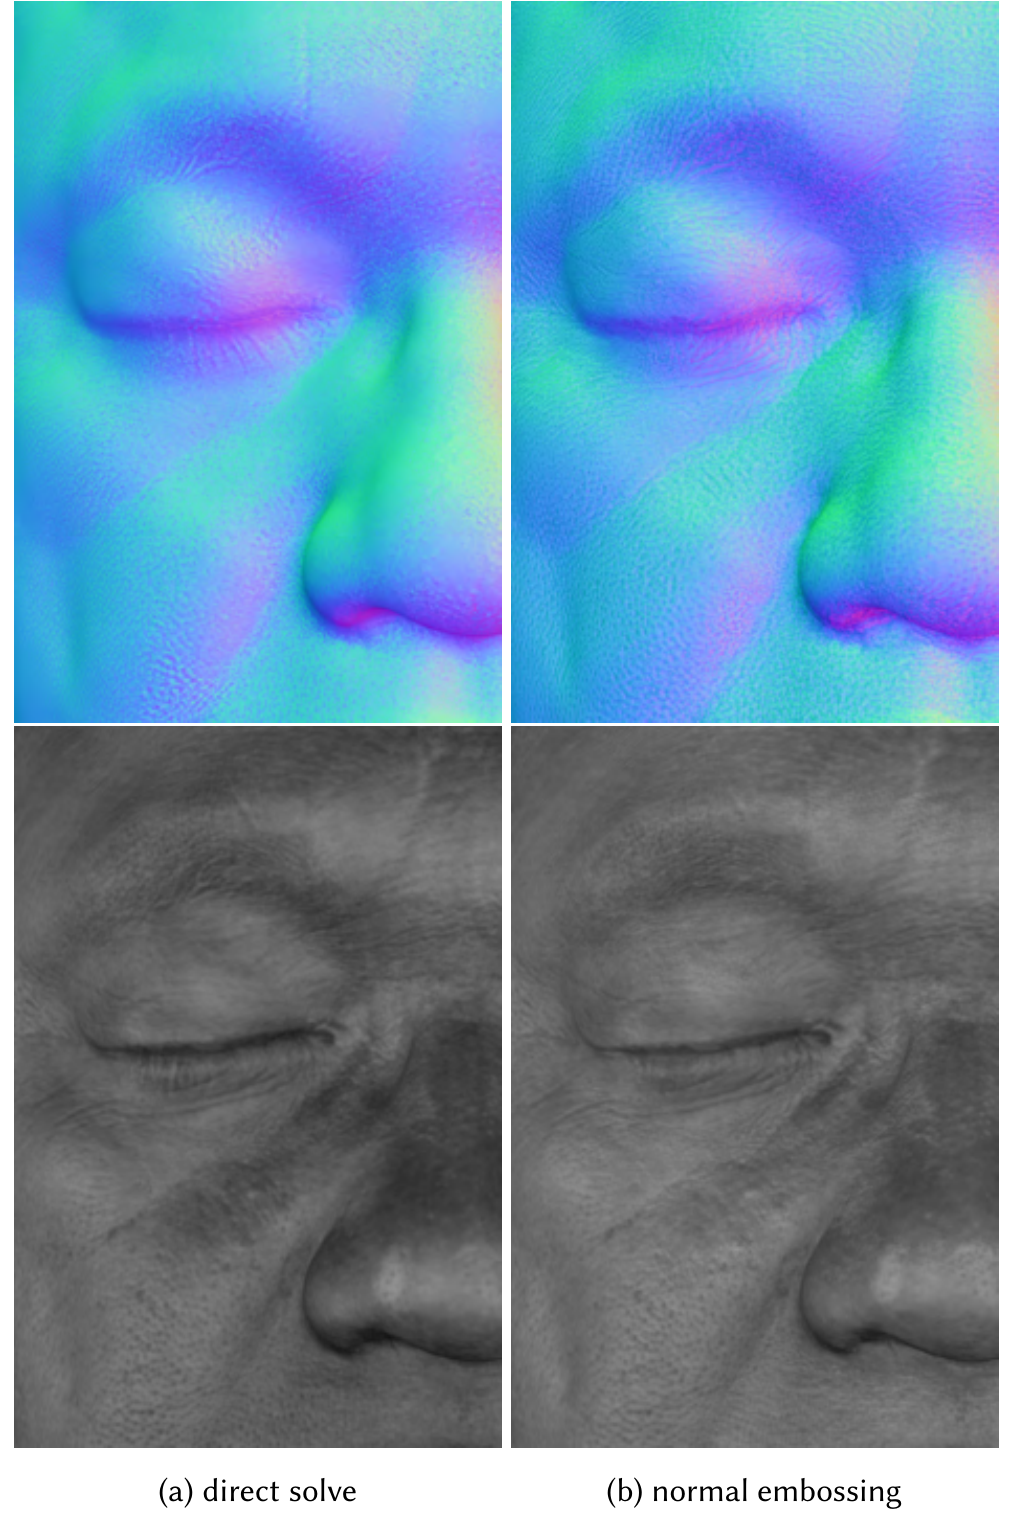
图14|左列为直接求解,右列为细节嵌入。上半部分比较法线,下半部分比较镜面反照率。有限照明下,细节嵌入的法线更干净,镜面图中残留的照明变化也更少。来源:原论文图14。
这张消融图把方法与硬件条件接了起来:实际系统并没有盲目沿用理想球面光场下的求解方式,而是用基础几何约束低频结构,再从观测中提取更可靠的局部变化。
八、定量实验:更好地分开高光,不等于每项指标都最好
作者首先使用Digital Emily模型合成数据。基础细节由已有位移图模拟,空间变化的粗糙度通过缩放镜面反照率图构造,皮肤粗糙度多数分布在0.3—0.5之间。
这提供了已知真值,可以直接比较贴图误差,但测试材质分布来自这套合成设置,并不覆盖所有真实皮肤情况。
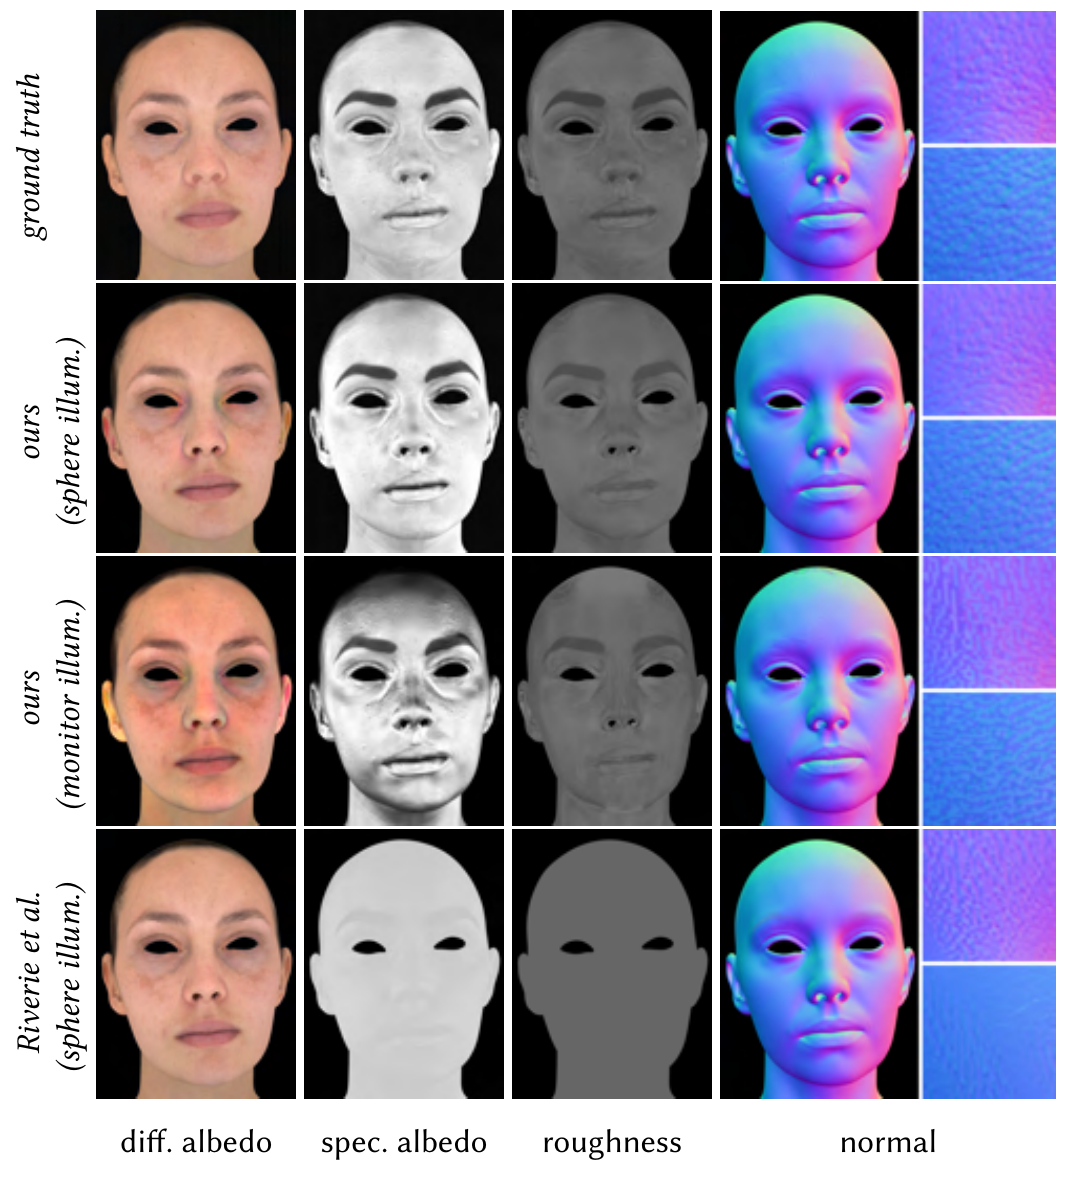
图6|从上到下为真值、本文球面照明结果、本文屏幕照明结果,以及Riviere等人的球面照明结果。列方向依次比较漫反射、镜面反照率、粗糙度和法线。来源:原论文图6。
主要基线是Riviere等人的2020年单次人脸采集方法。作者遵循基线的白光采集协议,自行复现其流程并调整超参数。两种方法使用相同网格,以聚焦外观贴图估计。
表中的MSE越低越好。下面保留原表的数值与倍率:
| 方法与照明条件 | 漫反射反照率MSE(×10⁻³) | 镜面反照率MSE(×10⁻²) | 粗糙度MSE(×10⁻³) | 法线MSE(×10⁻³) |
|---|---|---|---|---|
| 本文,球面照明 | 1.607 | 2.048 | 1.212 | 0.668 |
| Riviere等,球面照明 | 1.422 | 2.831 | — | 1.324 |
| 本文,屏幕照明 | 6.212 | 5.767 | 1.744 | 2.956 |
数值来源:原论文表1。法线项也是MSE,不能改读为角度误差;不同列采用不同倍率。
在球面照明下,本文的镜面反照率和法线误差更低,但漫反射反照率略逊于基线。基线没有独立的空间变化粗糙度结果,所以粗糙度一栏没有可直接比较的误差值。
转到屏幕照明后,本文各项误差都有上升。粗糙度MSE从1.212上升到1.744,变化相对较小;漫反射与镜面反照率、法线则受到更明显影响。这与方法设计相符:粗糙度依赖归一化比值,绝对强度类参数更容易受到照明缺失影响。
不过,“比值较稳健”不能推导成“完全不受光照影响”。查表还需要反射角度,弱信号与噪声也会传入比值。实际屏幕结果仍低于理想球面设置。
论文还展示了与其他方法的视觉对比。
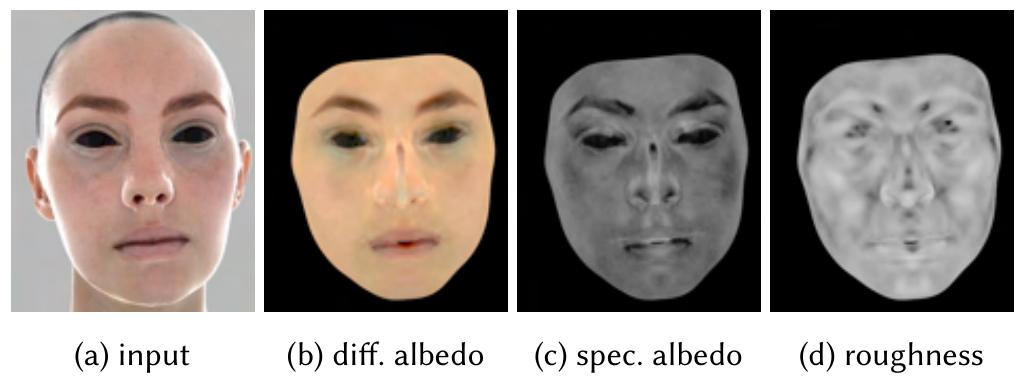
图7|NextFace在相应合成视角上的结果,展示统计人脸模型在身份与细节表达上的差异。来源:原论文图7。
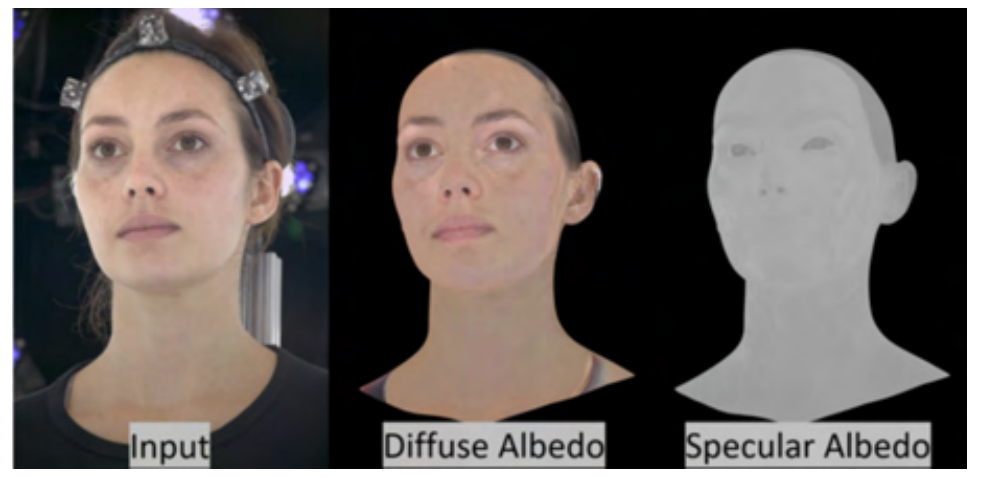
图8|神经着色场的示例,镜面反照率细节较弱,且没有显式的空间变化粗糙度输出。来源:原论文图8。
这些比较需要结合条件看。NextFace结果使用15张合成图像;神经着色场图像则转载自对应论文,并非本文在相同数据上重跑得到。它们有助于说明不同采集目标与表示能力,不能合并成一张严格统一协议下的性能排名。
九、真实人脸:毛孔细节最终出现在哪里?
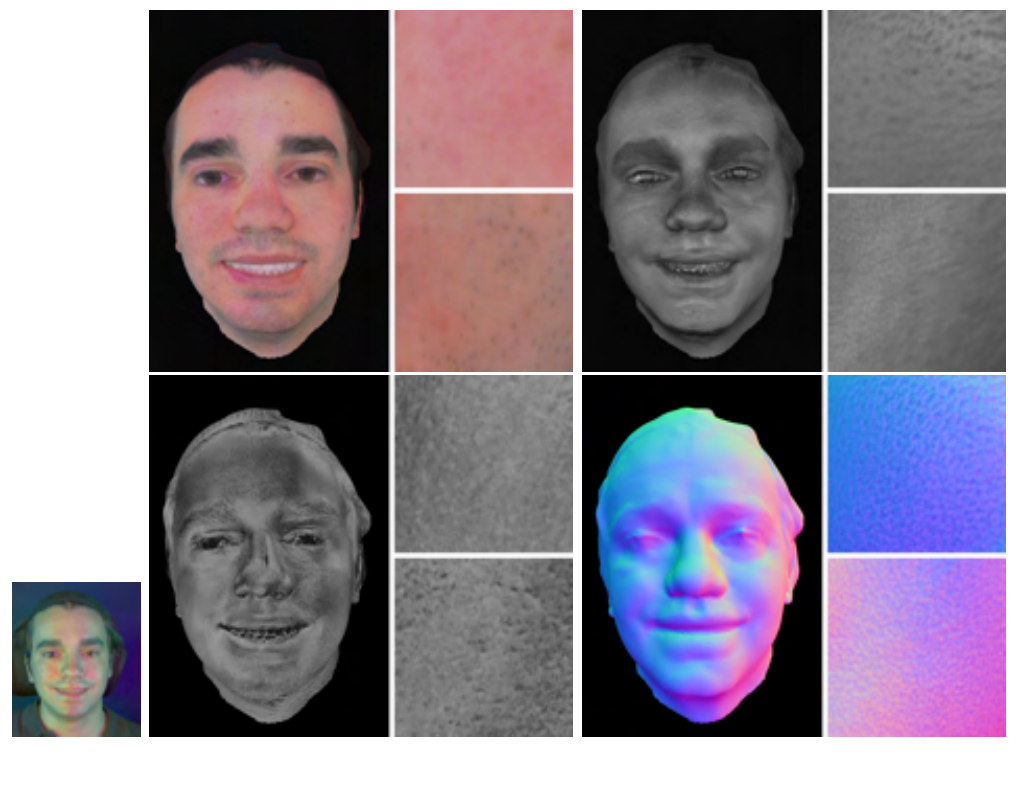
图9|真实采集得到的漫反射、镜面反照率、粗糙度与法线。放大区域展示了皮肤局部纹理与细小方向变化。来源:原论文图9。
图中的彩色法线图并不是给皮肤涂上颜色,而是把三维方向编码为RGB。相邻像素颜色的细微变化,对应表面方向的变化;在重新打光时,这些方向变化会形成毛孔和细纹的明暗。
基础网格不一定包含这些微小凹凸。渲染器可以在网格表面读取法线贴图,用更精细的方向计算反射,让皮肤在近距离观看时不再像一块光滑塑料。
因此,这篇工作更直接支持的是“采集可用于细节渲染的外观和光度方向”,而不是具有明确长度单位、经过独立几何真值验证的毛孔深度测量。
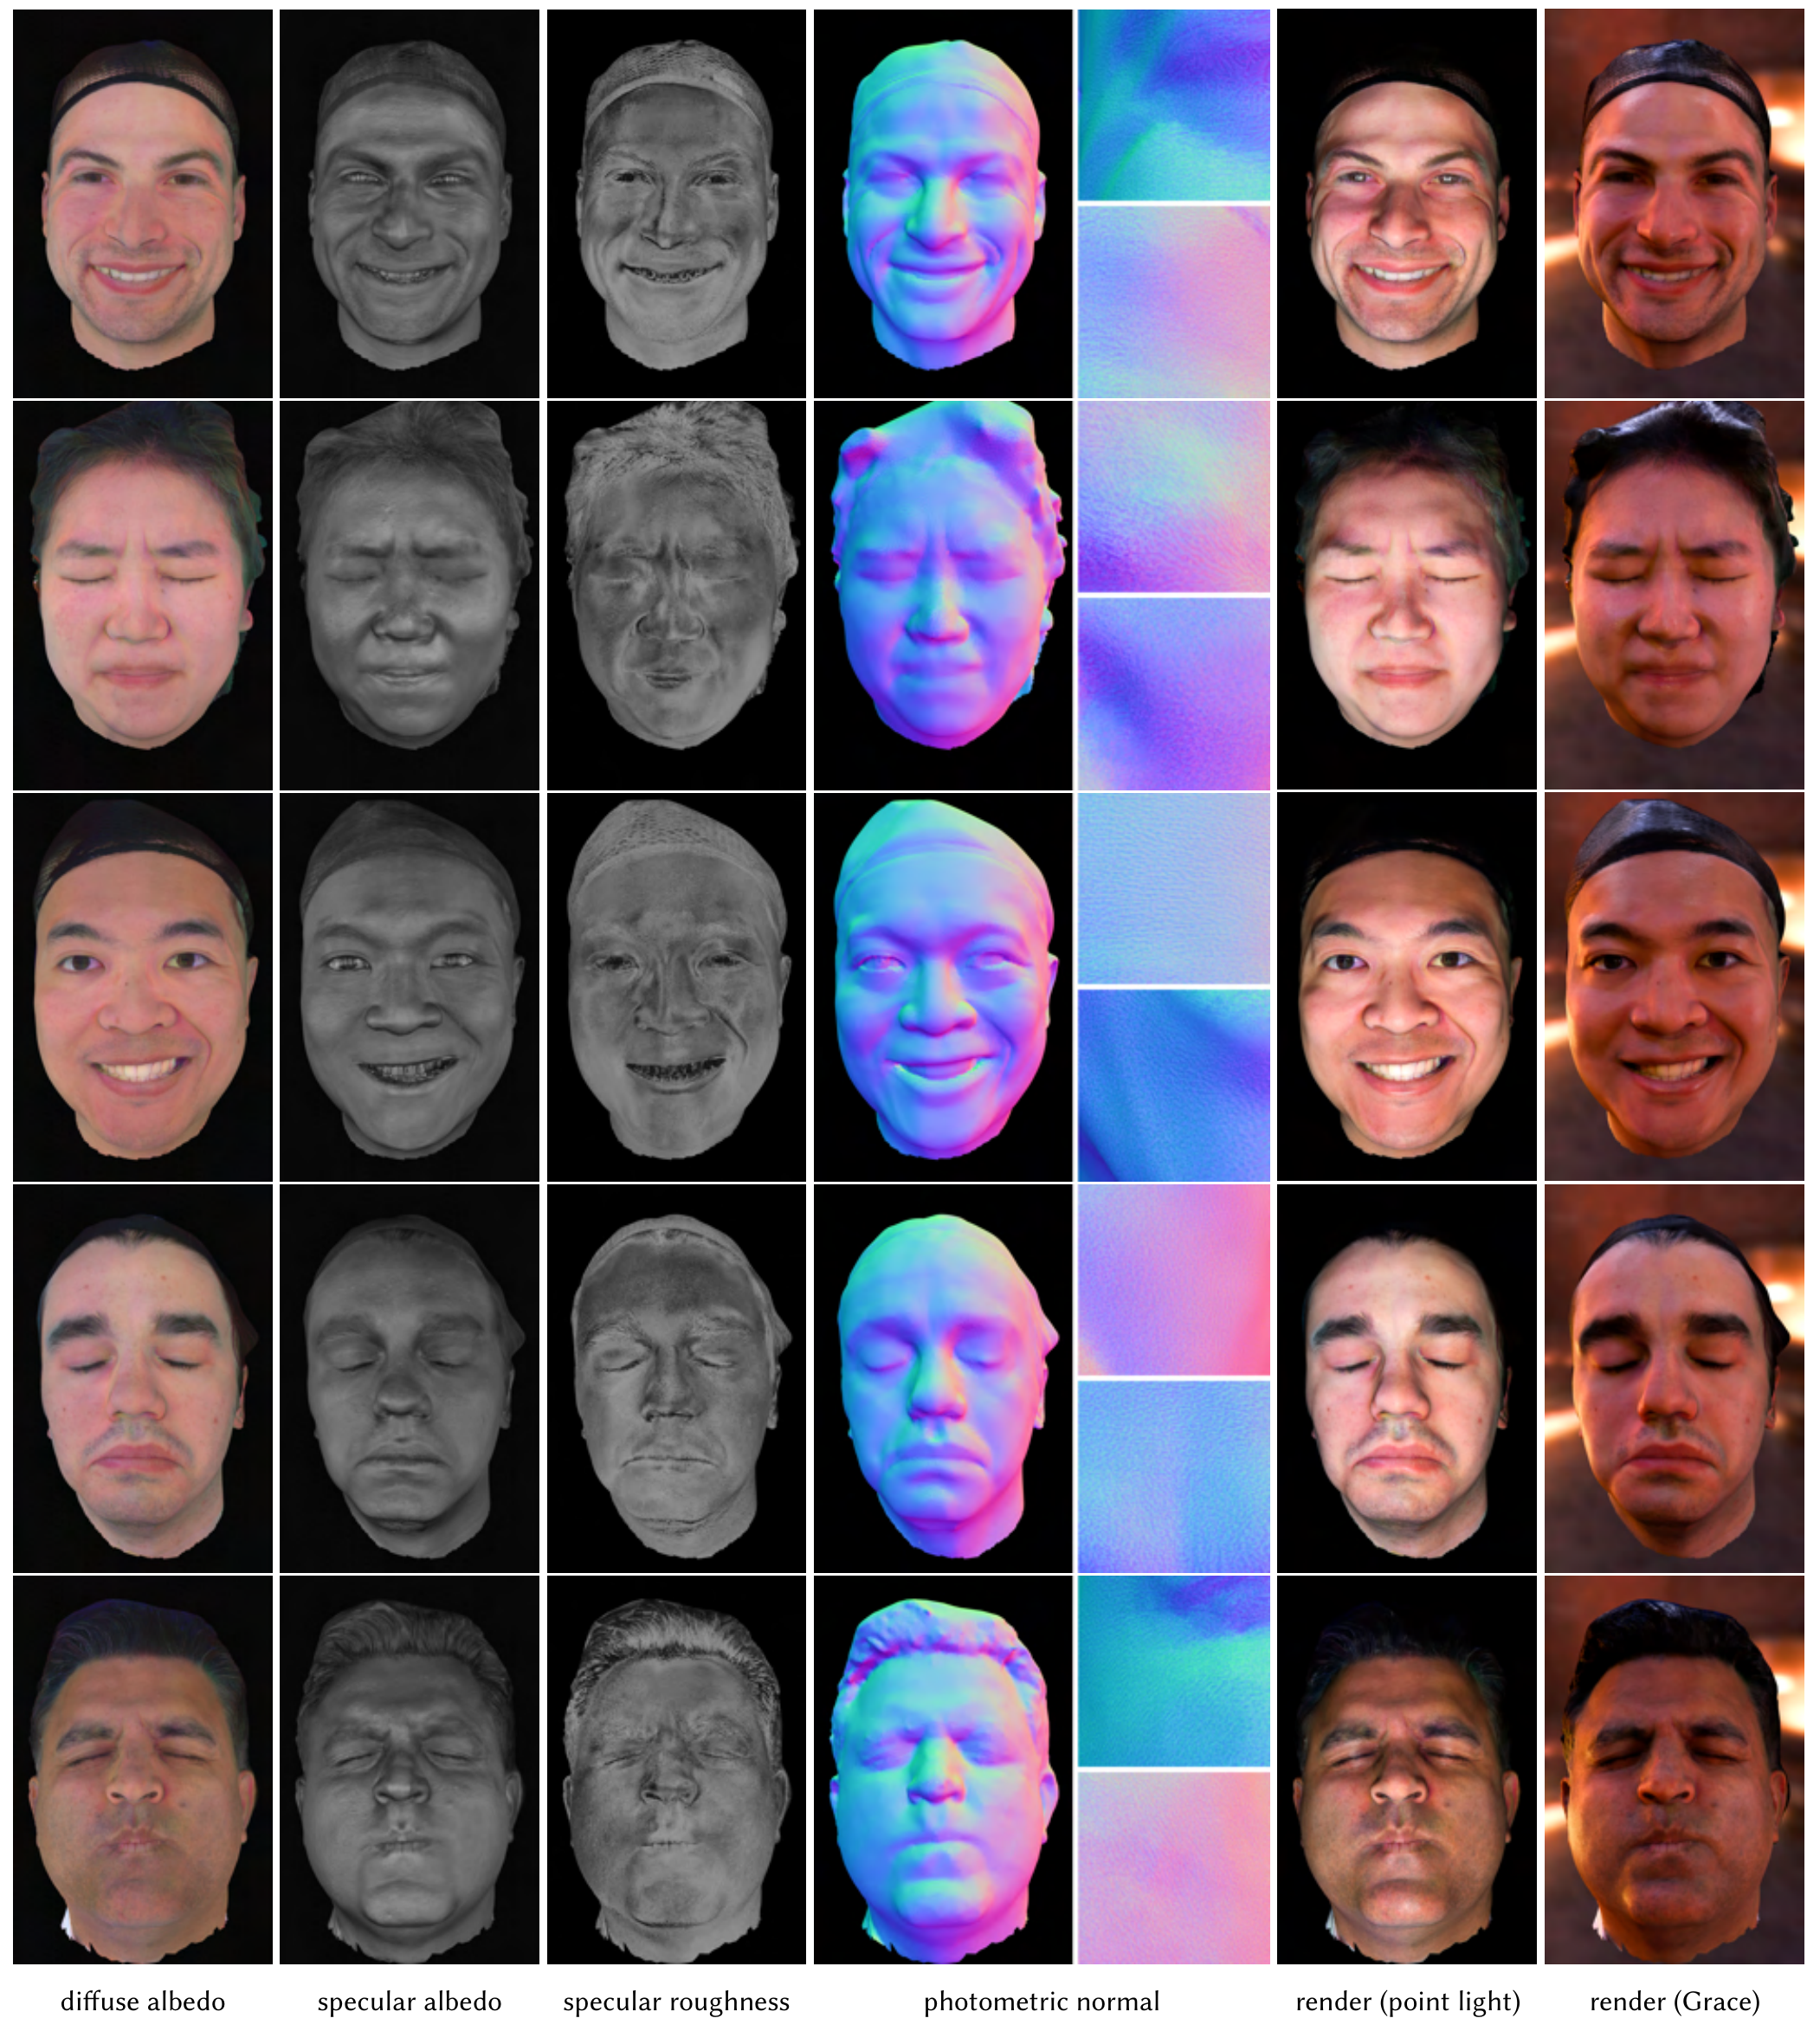
图10|不同人物和静态表情的结果,从左到右展示材质、法线、点光源与环境光渲染。来源:原论文图10。
这组结果说明,方法不只针对一张标准正脸示例。不同年龄、肤色与表情的面部,都能产生具有局部差异的外观贴图。但图中不同表情是静态采集结果,不是已经展示稳定时序追踪的视频序列。
由于镜面反照率与粗糙度可以分别估计,作者还展示了眼睛和牙齿区域。
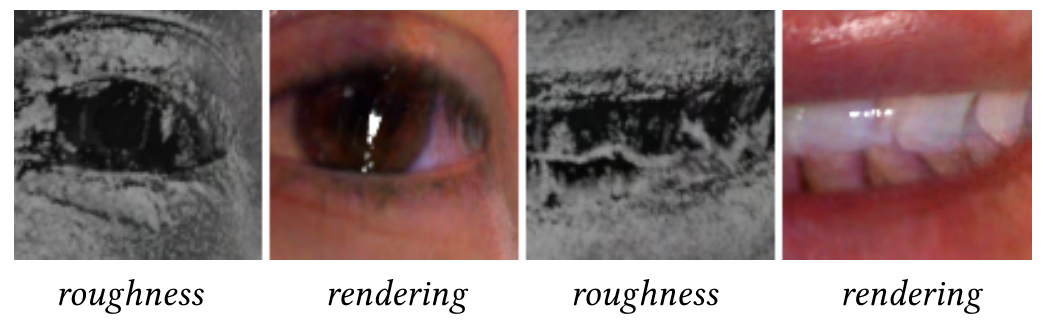
图11|眼部与口腔区域的粗糙度图及相应渲染,展示不同材料区域的反射差异。来源:原论文图11。
这意味着同一套采集数据有机会支持皮肤以外区域的外观估计。但示例并不等于建立了完整的眼球光学模型或牙齿散射模型,不能据此认为所有复杂材料问题都已解决。
十、重新打光:能否回到真实照片的样子?
仅看几张分解贴图,很难判断参数是否合理。作者进一步把采集结果放到新的白光条件下渲染,与装置拍到的真实照片比较。
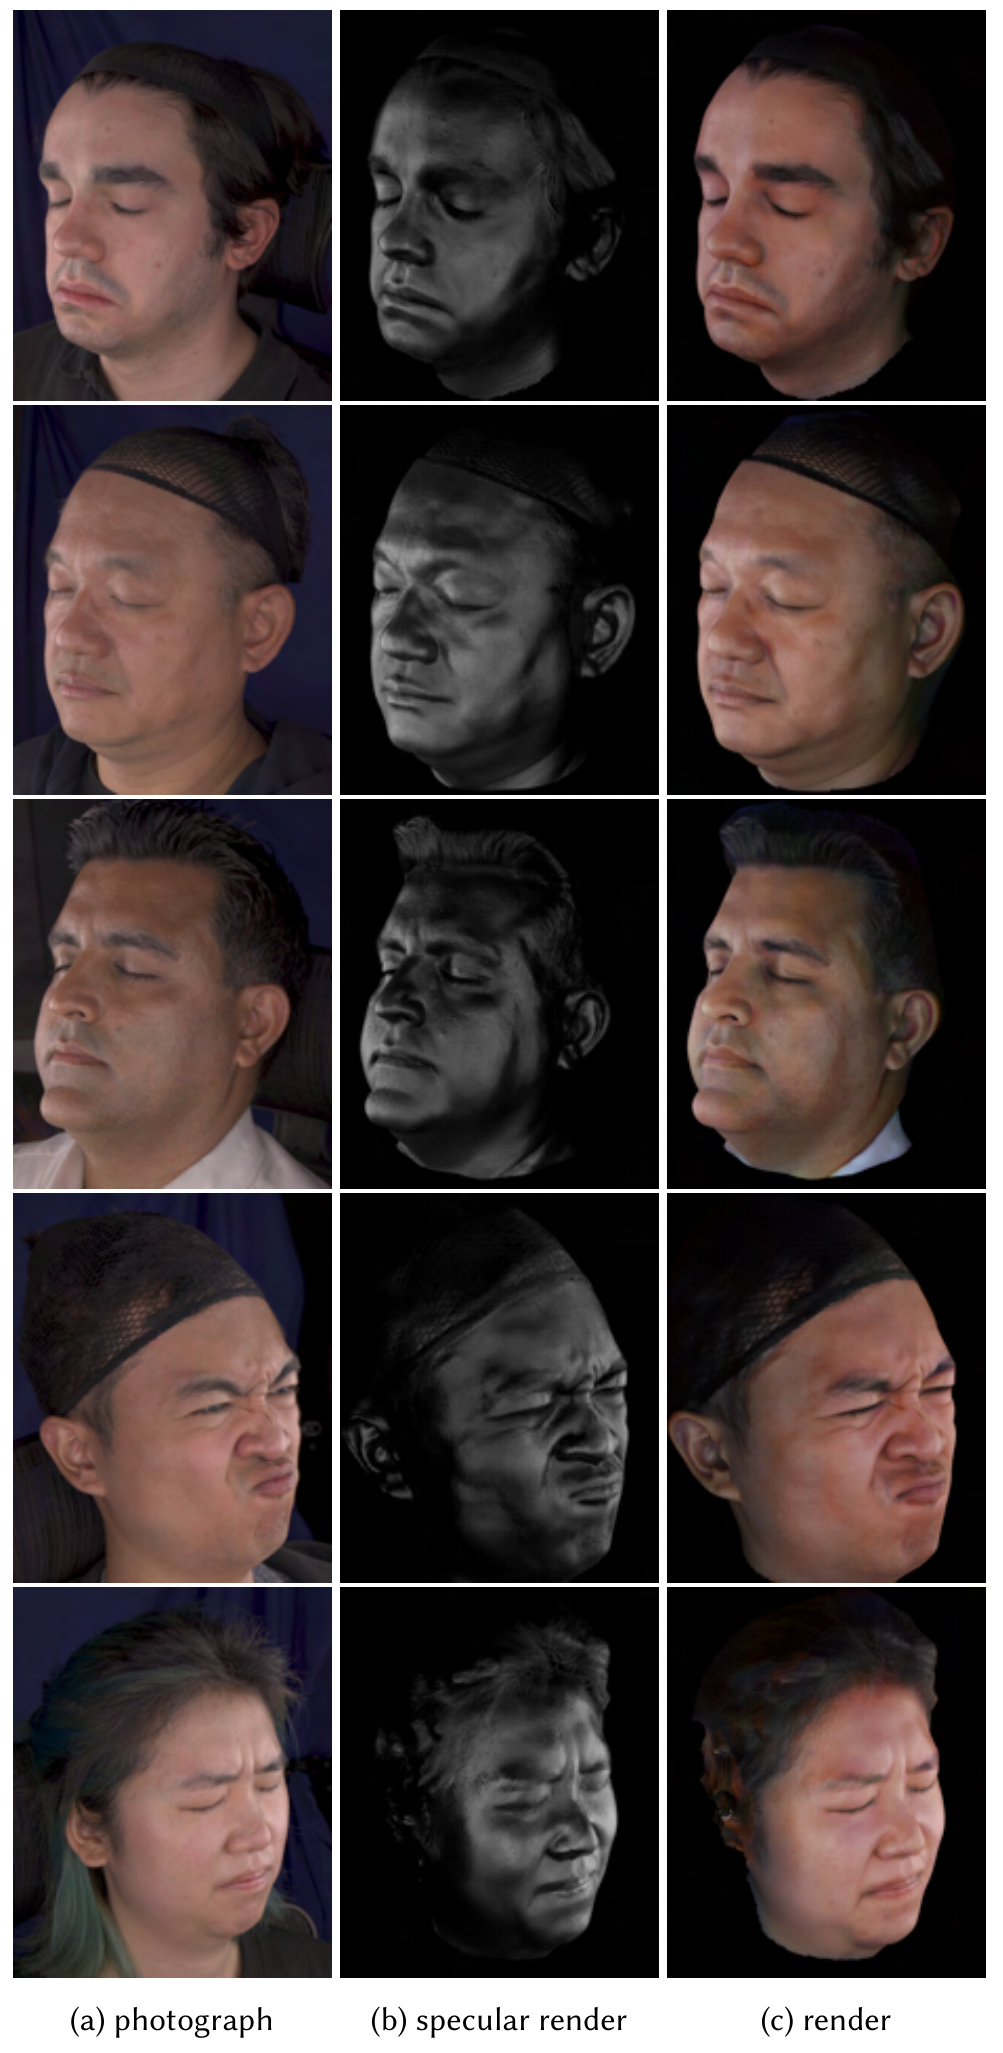
图12|左列为真实照片,中列为镜面分量渲染,右列为完整渲染。来源:原论文图12。
镜面渲染中能看到与照片较接近的细小反射结构,说明法线、镜面反照率与粗糙度共同保留了相当一部分局部光照响应。
完整渲染仍有轻微肤色色调偏移。作者将其与有限范围、近场照明以及皮肤散射效应联系起来;其球面照明合成实验没有表现出同样的问题。
这个结果把成功与局限放在了一起:高光细节具有较好的重现能力,漫反射颜色则仍然受到实际装置条件影响。它支持在展示条件下的重打光质量,也提醒我们,真实世界中的全局颜色一致性还需要进一步改善。
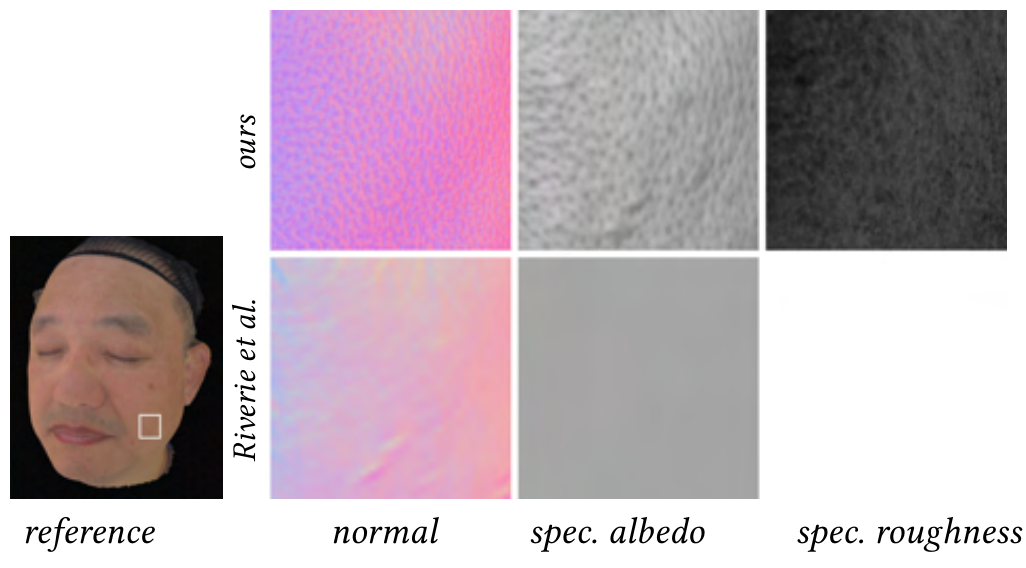
图13|本文与Riviere等方法的真实数据结果,比较法线、镜面反照率与粗糙度。来源:原论文图13。
本文结果中局部纹理更清晰。不过,作者也明确指出:自己在屏幕装置上复现的基线,比基线原论文展示的几何更柔和,即使调整正则化也仍有差距,推测与近场照明建模不匹配有关。
因此,这张图既包含方法差异,也受到装置与复现条件影响。它是当前实验条件下的证据,不能脱离这些条件解读为对原方法所有场景的全面超越。
十一、它解决了什么,接下来还缺什么?
这篇论文最有启发性的地方,是把反射分解的一部分工作提前交给照明设计。
偏振先提供反射成分的区分;RGB相位复用再提供均值、振幅与相位;归一化振幅帮助区分反射强度和粗糙度;相位与多视角或基础几何一起约束细节方向。整个流程中的每一步,都在利用下一步需要的观测结构。
也正因为它是一套测量方法,硬件与物理假设决定了结果边界。
有限屏幕照明会造成欠照明和色偏,完整球面光场下的理想性质无法原封不动地搬到桌面装置上。查找表依赖选定的GGX反射模型与校准条件,细节嵌入依赖基础几何及局部材质近似。论文也没有显式建模次表面散射。
动态采集方面,它避免了多幅照明图案的时间切换,因而具有逐帧处理的潜力;但当前屏幕亮度限制了实际采集,论文没有展示动态表演序列,也没有给出端到端实时重建的证据。
对于高精度人脸重建,这项工作的价值在于说明:细节不仅需要更多像素或更复杂的表示,也需要能够区分材质与方向的观测。当反射强度、粗糙度与法线能够被更清楚地测量,数字人换一盏灯之后,才更有可能保留同一张脸应有的皮肤质感。
