
 洗子
 匿名

一个数字人会笑、会眨眼,还不够。把它从柔和的室内灯下移到窗边,头发应该出现细小亮边,皮肤的高光应该随着方向移动,眼睛里也应该映出新的环境。
这几件事同时做好并不容易。皮肤会散射光,头发是一束束细纤维,角膜又接近镜面。即使模型在训练视角下很逼真,换一盏灯,原来学到的颜色也可能不再适用。
这篇CVPR2024论文希望建立一种既可驱动、又能实时重打光的完整头部化身。作者使用3D高斯表达动态几何,再让网络预测每个高斯的光传输响应,最后把新的光照与这些响应组合,计算出渲染颜色。
它不让网络只记住“这张脸在某盏灯下是什么颜色”,而是学习“这张脸处于某个表情时,来自不同方向的光会怎样影响它”。
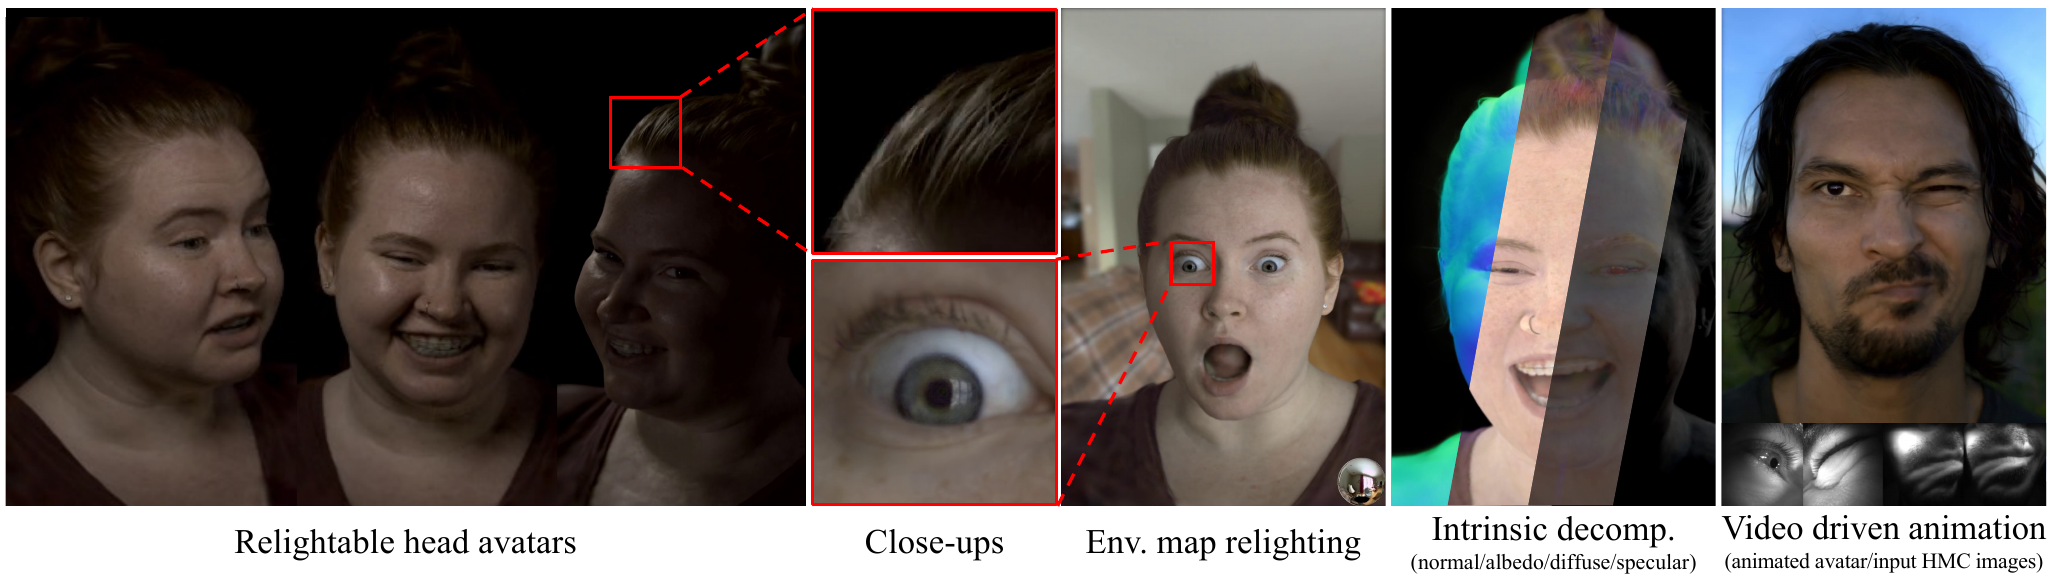
图1|动态头部、头发与眼部细节、环境光重打光、外观分解及头戴相机驱动。来源:原论文图1。
这里的Codec指表情状态的编码与解码:把当前面部状态压缩到潜变量,再解码成可渲染的化身。它不是一种视频文件编码格式,也不是拿一张照片就能直接生成任意人物的通用模型。
论文信息
| 项目 | 内容 |
|---|---|
| 英文标题 | Relightable Gaussian Codec Avatars |
| 中文标题 | 可重打光的高斯编解码化身 |
| 发表 | CVPR 2024,Oral |
| 作者 | Shunsuke Saito、Gabriel Schwartz、Tomas Simon、Junxuan Li、Giljoo Nam |
| 机构 | Codec Avatars Lab,Meta |
| 项目主页 | https://shunsukesaito.github.io/rgca/ |
| 官方实现与数据入口 | https://github.com/facebookresearch/goliath |
| 资源状态 | 仓库包含官方实现;完整数据访问需按仓库说明申请,仓库目前为归档只读状态 |
| 关键词 | 高斯化身、表情驱动、可学习光传输、球谐、球面高斯、眼球建模、实时重打光 |
一、为什么有了3D高斯,还不能直接换光?
一个3D高斯具有位置、方向、尺度、不透明度和颜色。许多高斯共同投影到图像上,就可以表达皮肤、头发和其他复杂结构。
但颜色本身并不自动说明它是怎样产生的。同一块额头在暗处较暗、被灯照到后较亮;如果模型只学习已有图像的外观,就不一定能把材质、阴影和光源影响拆开。
传统3DGS中的视角相关颜色,可以描述“相机换方向后外观怎样变化”,却不等于“光源换方向后反射怎样变化”。视角与照明是两种不同的控制量。
而头部还包含多种材料。单一、简化的表面BRDF很难同时准确处理皮肤的散射、头发的纤维反射与眼球的折射和镜面高光。
作者因此同时处理两个问题:用高斯提高动态几何的表达能力,再用可学习光传输模型描述不同照明下的外观。几何表达与光照表达缺一不可。
二、数据怎么来:实时的是使用阶段,采集与训练仍然昂贵
论文使用专业多视角灯光系统。主文采集段落报告110台同步相机、460盏白色LED,图像分辨率4096×2668,采集频率90 Hz;每位参与者执行表情、说话和视线运动等任务,记录约144,000帧。
照明按时间复用:每隔3帧插入一次全亮照明,用于稳定跟踪;其他帧使用分组或随机5灯组合,提供不同光照条件下的监督。
全亮帧先估计一致拓扑的粗网格、头部姿态、平均展开纹理与双眼视线,再把这些信息插值到相邻的局部照明帧。
这不是要求普通用户每次使用化身时都重新进入灯光棚,而是先为某个人建立个性化模型。训练完成后,才可以用表情潜变量、视线、目标视角和新的照明驱动它。
因此,“实时重打光”描述的是训练后生成与渲染的能力,不代表实时采集、即时训练,也不代表手机随拍即可达到同样质量。
三、动态几何:把表情解码成会移动的高斯
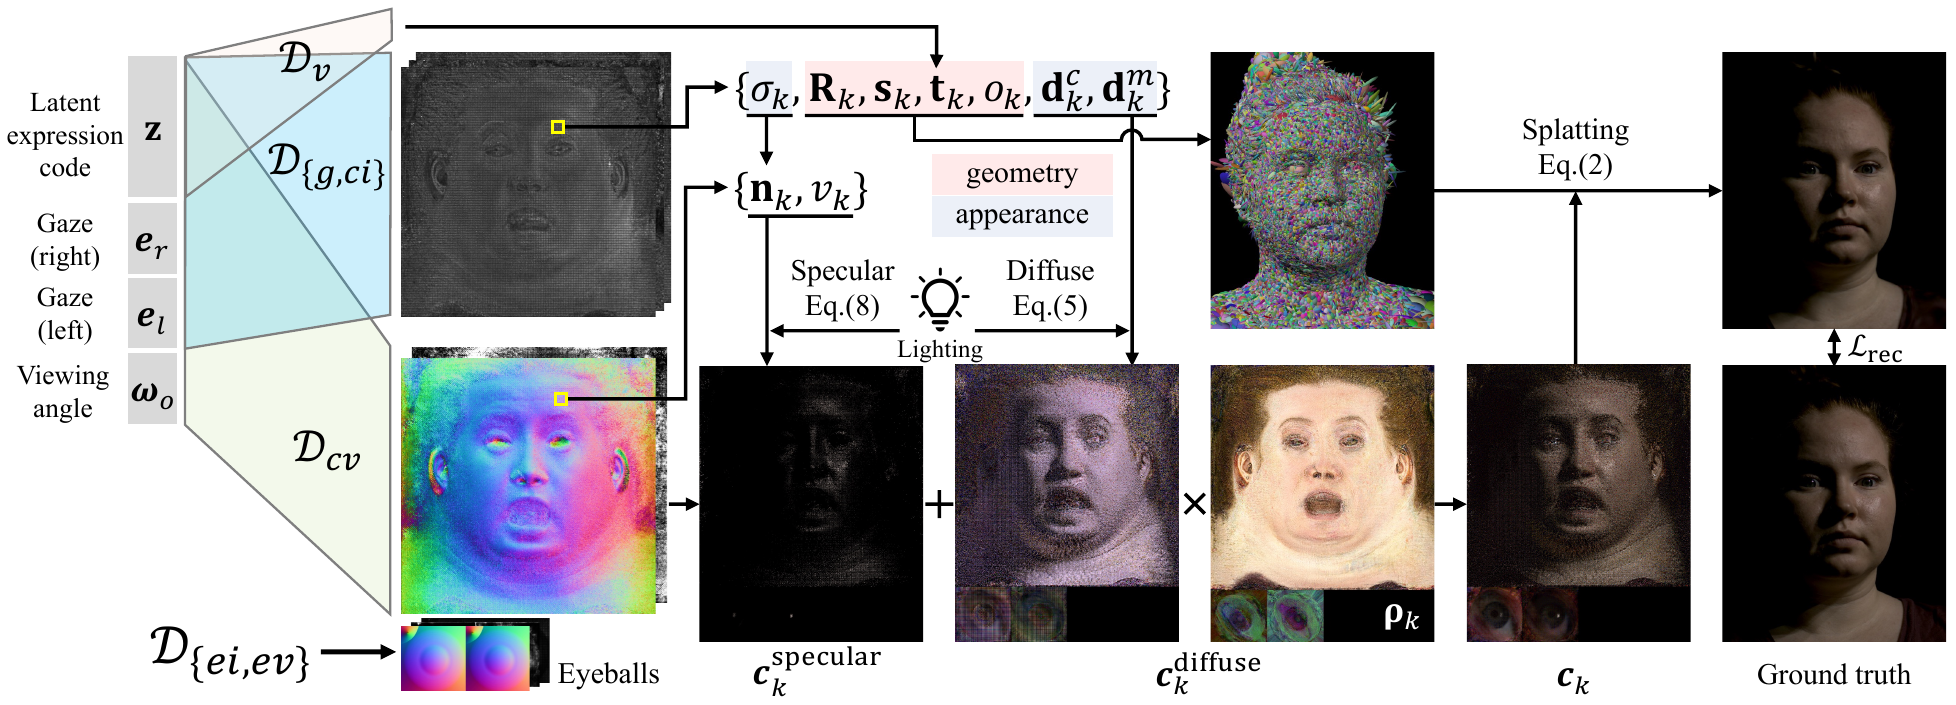
图2|输入表情潜变量、视线与视角,网络解码几何和光传输参数;光照在后续积分中参与颜色计算,再通过溅射渲染并与真实图像比较。来源:原论文图2。
系统使用条件变分自编码器学习个性化的表情空间。训练时,编码器从粗网格和平均UV纹理提取分布参数,再采样256维表情潜变量$\mathbf{ z }$。
原论文式(3)概括为:
$$ \begin{gathered} \boldsymbol\mu_e,\boldsymbol\sigma_e =\mathcal E(\mathbf{ V },\mathbf{ T };\Theta_e),\\ \{\delta\mathbf{ t }_k,\mathbf{ R }_k,\mathbf{ s }_k,o_k\}_{k=1}^{M} =\mathcal D_g(\mathbf{ z },\mathbf{ e }_{\{l,r\}};\Theta_g). \end{gathered} \tag{3} $$
$\mathbf{ V }$与$\mathbf{ T }$分别是跟踪网格和纹理,$\mathbf{ e }_{\{l,r\}}$是双眼视线。几何解码器预测每个高斯的位置残差、旋转、三轴尺度与不透明度。
作者将高斯组织在统一UV图上,每个纹素对应一个高斯,便于用二维卷积网络解码。表情潜变量还会解码出粗网格,原论文式(4)为:
$$ \mathbf{ V }'=\mathcal D_v(\mathbf{ z };\Theta_v). \tag{4} $$
高斯最终位置由粗网格引导:
$$ \mathbf{ t }_k=\hat{\mathbf{ t }}_k+\delta\mathbf{ t }_k. $$
其中$\hat{\mathbf{ t }}_k$是根据该高斯的UV坐标,在解码网格上进行重心插值得到的位置。这一关系来自原文文字说明。
可以理解为:粗网格负责大范围表情运动,高斯残差负责局部调整。这样既保留了跟随表情运动的结构,又给头发、皮肤细节留下比粗网格更灵活的表达空间。
它们不是物理意义上的独立皮肤颗粒或一根根完整头发,而是共同拟合外观与空间结构的渲染基元。
四、高斯怎样变成像素:形状投影与前后混合
高斯的三维形状由协方差矩阵表示:
$$ \boldsymbol\Sigma_k =\mathbf{ R }_k\operatorname{diag}(\mathbf{ s }_k) \operatorname{diag}(\mathbf{ s }_k)^\top\mathbf{ R }_k^\top. $$
旋转决定椭球朝向,尺度决定各个方向的延伸。投影到相机后,它变成图像中的二维椭圆。原论文式(1)为:
$$ \boldsymbol\Sigma'_k =\mathbf{ J }\mathbf{ V }\boldsymbol\Sigma_k \mathbf{ V }^\top\mathbf{ J }^\top. \tag{1} $$
这里的$\mathbf{ V }$表示观察变换矩阵,与上一节网格顶点集合的同名字母需要按上下文区分;$\mathbf{ J }$是投影变换的局部雅可比矩阵。
这条式子体现协方差在线性变换下的传播:先把三维高斯转到相机坐标,再以局部投影近似得到二维覆盖范围。
对于同一个像素,多个投影高斯按前后顺序混合。原论文式(2)为:
$$ \mathbf{ C }_p =\sum_{k\in\mathcal N}\mathbf{ c }_k\alpha_k \prod_{j=1}^{k-1}(1-\alpha_j). \tag{2} $$
$\alpha_k$是该高斯在像素处的有效覆盖与不透明度,乘积表示前面的高斯之后还剩多少透射贡献。距离像素很远的高斯,即使自身不透明度高,也不会同样影响该像素。
这个表达式负责把几何与颜色变成最终图像。接下来真正决定能否换光的,是每个高斯的颜色$\mathbf{ c }_k$如何计算。
五、核心思路:先学光传输,再把新光照接进来
论文把每个高斯的颜色分为:
$$ \mathbf{ c }_k =\mathbf{ c }_k^{\mathrm{diffuse}} +\mathbf{ c }_k^{\mathrm{specular}}(\boldsymbol\omega_o). $$
前者是视角无关的漫反射式响应,后者描述视角相关的镜面响应。这里的“漫反射”不只是一条局部Lambertian公式,而是允许吸收遮挡、皮下散射和多次反弹等综合影响的可学习传输。
理解光传输,可以想象固定表情和视角后,从球面各个方向依次打入一束单位强度的光,记录这束光会给当前高斯带来多少输出。所有方向的响应组合起来,就构成一个方向函数。
真实照明则给出各个方向实际有多少光。把“每个方向的响应”与“每个方向的光”相乘,再对方向累加,就得到当前颜色。
这使照明不必被压进表情潜变量中。模型可以先解码表情对应的传输参数,再让新的点光源或环境光参与最终计算。
六、漫反射与阴影:球谐为什么能把积分变成点积?
原论文式(5)为:
$$ \begin{aligned} \mathbf{ c }_k^{\mathrm{diffuse}} &=\boldsymbol\rho_k\odot \int_{\mathbb S^2}\mathbf{ L }(\boldsymbol\omega_i) \odot\mathbf{ d }_k(\boldsymbol\omega_i)\,d\boldsymbol\omega_i\\ &=\boldsymbol\rho_k\odot \sum_{i=1}^{(n+1)^2}\mathbf{ L }_i\odot\mathbf{ d }_k^i. \end{aligned} \tag{5} $$
$\mathbf{ L }$是入射照明,$\mathbf{ d }_k$是该高斯的传输函数,$\boldsymbol\rho_k$是可学习的RGB反照率,$\odot$表示逐颜色通道相乘。头部主体的反照率随高斯固定,有助于保持表情变化中的颜色一致性。
为什么积分可以变成求和?下面是对原式的展开解释。
把一个颜色通道的照明与传输分别展开为球谐基$Y_i$:
$$ L(\omega)=\sum_i L_iY_i(\omega), \qquad d(\omega)=\sum_j d_jY_j(\omega). $$
由于球谐基正交归一:
$$ \int_{\mathbb S^2}Y_i(\omega)Y_j(\omega)\,d\omega=\delta_{ij}, $$
相乘积分中的交叉项消失,留下$\sum_iL_id_i$。这样,每次换光不需要重新模拟大量光路,只需要用新的光照系数与已经解码的传输系数做点积。
但低阶球谐虽然适合平滑响应,对更清晰的阴影仍不够。作者采用了一个容量折中:0—3阶使用RGB系数,4—8阶增加单色传输系数,用高阶表达更细的方向变化。
按球谐系数数量计算,0—3阶共有16项,4—8阶有65项;采用RGB低阶加单色高阶,共需$16\times3+65=113$个标量,而全RGB到8阶需要243个。这个数量比较是对原文阶数配置的推算。
它把更多容量留给方向变化,同时减少高阶颜色通道的开销。这里是高阶传输系数共享颜色结构,不是把输入彩色环境光变成灰度。
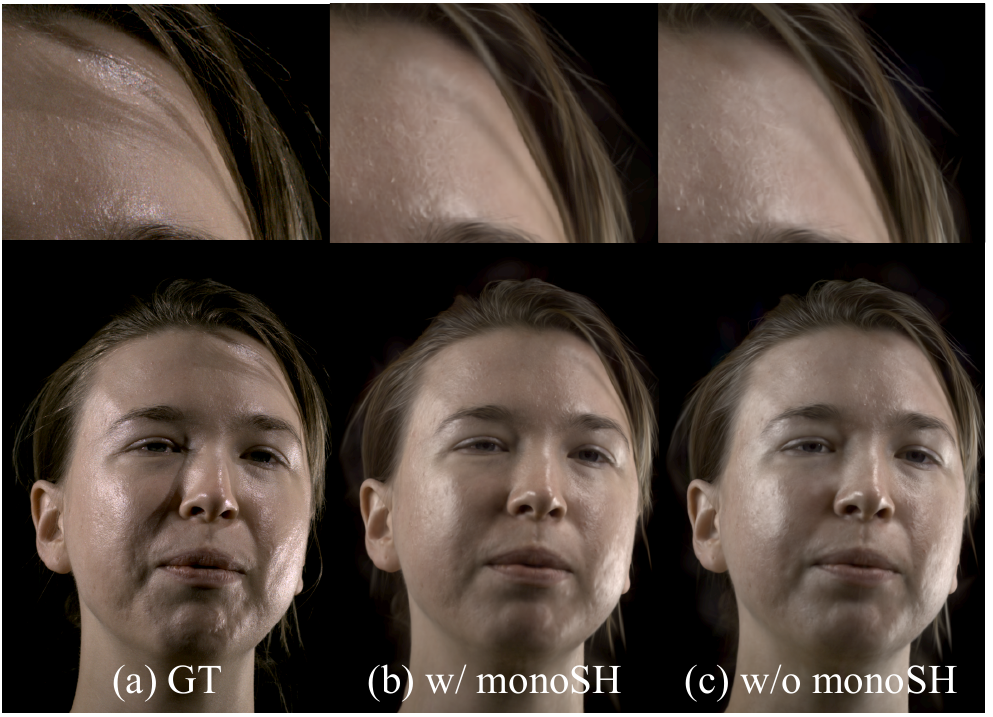
图6|真值、加入高阶单色球谐、不加高阶单色球谐的比较。额头和面部阴影用于观察方向响应的清晰度。来源:原论文补充图6。
阴影仍受到有限阶基函数的表达能力限制。因此,“加入高阶”是改善,不是对任意细小硬阴影的无损恢复。
七、镜面高光:为什么要换成球面高斯?
低阶球谐很难高效表示眼睛里尖锐的小亮点。如果不断提高阶数,系数与计算量又会增加。
作者对镜面分量改用球面高斯。它与负责空间几何的3D高斯是两件事:3D高斯分布在空间里,球面高斯分布在方向球面上。
原论文式(6)定义:
$$ G_s(\mathbf{ p };\mathbf{ q },\sigma) =C\exp\left[-\frac12 \left(\frac{\arccos(\mathbf{ p }\cdot\mathbf{ q })}{\sigma}\right)^2\right]. \tag{6} $$
$\mathbf{ q }$是波瓣中心方向,$\mathbf{ p }$是查询方向,$\sigma$控制角度衰减宽度,$C$是原文采用的归一化因子。夹角越接近零,响应越强;$\sigma$越小,波瓣越尖锐。
这与常见的基于$\mathbf{ p }\cdot\mathbf{ q }-1$的球面高斯参数化不同,作者直接在角度上定义衰减。它可以用较窄波瓣表达眼部等区域的高频反射。
波瓣中心由反射方向决定,原论文式(7)为:
$$ \mathbf{ q }_k =2(\boldsymbol\omega_k^o\cdot\mathbf{ n }_k)\mathbf{ n }_k -\boldsymbol\omega_k^o. \tag{7} $$
$\boldsymbol\omega_k^o$是观察方向,$\mathbf{ n }_k$是该高斯用于反射计算的法线。这个关系说明,移动相机后,主要反射方向也会移动,模型应该从环境的相应位置读取光。
最终镜面颜色为原论文式(8):
$$ \mathbf{ c }_k^{\mathrm{specular}}(\boldsymbol\omega_o) =v_k(\boldsymbol\omega_o) \int_{\mathbb S^2}\mathbf{ L }(\boldsymbol\omega_i) G_s(\boldsymbol\omega_i;\mathbf{ q }_k,\sigma_k) \,d\boldsymbol\omega_i. \tag{8} $$
积分相当于围绕反射方向,对环境光做与波瓣宽度对应的过滤。外面的$v_k$是学习得到的视角相关系数,综合近似可见性、菲涅耳与几何衰减等影响,而不是一张可以直接等同于物理遮挡真值的图。
附录还限制镜面BRDF为单色,减少镜面分量吸收漫反射颜色的倾向。这不意味着高光只能是灰色:彩色照明仍通过$\mathbf{ L }$进入积分,能产生彩色反射。
八、这个镜面公式从哪里来?
附录从渲染方程解释了式(8)。将可见性记为$V$、BRDF记为$\rho$,出射颜色为:
$$ \mathbf{ c }(\omega_o) =\int_{\mathbb S^2}\mathbf{ L }(\omega_i) V(\omega_i)\rho(\omega_o,\omega_i) \max(0,\omega_i\cdot\mathbf{ n })\,d\omega_i. $$
这是原论文附录式(17)的内容。对镜面BRDF,作者将微表面方向分布与其他较平滑因子分开,再用球面高斯近似方向波瓣。
当波瓣足够窄时,大部分贡献集中在中心方向附近。若其他因子在这片小范围内变化较慢,就可以近似把它们合并到积分之外,用一个与视角有关的$v_k$表示;积分内保留环境光和球面高斯,便得到式(8)。
这是近似的关键条件。它并没有显式、分别恢复所有物理参数,也不保证复杂遮挡在一个窄波瓣内始终平滑。网络学习的是能够拟合观测的综合响应。
实际计算中,点光源可直接在其方向上求值;环境光则预先按不同波瓣宽度过滤,运行时每个高斯只需一次相应的mipmap纹理查询,显著减少积分开销。
同时,照明在线性积分中参与颜色计算。在固定表情、视角和传输参数时,可以得到:
$$ \mathbf{ c }(L_1+L_2)=\mathbf{ c }(L_1)+\mathbf{ c }(L_2). $$
这是从模型结构得到的解释性关系:两盏灯的贡献可以相加。它有助于从训练中的离散灯光推广到连续环境光,但仍依赖所学传输与训练覆盖的质量。
九、头发为什么需要“随视角变化的法线”?
皮肤近似是局部表面,头发却是细纤维。绕着一根纤维改变观察方向时,有效反射行为可能变化,不能总用一张固定表面法线来解释。
作者让网络根据表情、视线和观察方向,预测法线残差,再与粗网格插值得到的法线相加、归一化:
$$ \mathbf{ n }_k =\frac{\hat{\mathbf{ n }}_k+\delta\mathbf{ n }_k} {\|\hat{\mathbf{ n }}_k+\delta\mathbf{ n }_k\|}. $$
这条关系在原文解码器说明中给出。对于表面区域,学习法线可以接近固定方向;对于纤维式区域,它可以随视角调整有效反射方向。
因此,这里的法线同时是外观模型的一部分,不能无条件当成真实曲面法线,直接拿去积分成毛孔或发丝几何。
实验也需要如实看:去掉视角相关法线后,部分指标并没有变差。作者认为,视角相关的$v_k$可能补偿了固定法线的一些误差,保留该设计更多基于纤维反射解释与连续环境泛化的考虑,而不是所有测试项上的确定收益。
十、眼睛:为什么不能让高斯完全自由拟合?
角膜高光可能只占几个像素,还会使相机饱和。如果让每个眼部高斯自由移动并调整法线,优化很容易落入不理想的结果:某几个点能拟合训练高光,却不能在新视角下稳定移动。
作者引入显式眼球模型,用眼球球体与角膜球体的平滑组合描述形状,并由视线方向控制旋转。
眼部高斯的位置固定在眼球表面,法线固定为相应表面法线。这样,高光方向受到眼球几何约束,而不是任意漂移。
虹膜透过角膜可见,还涉及折射。为了在相同表示框架内近似这种视角变化,眼部允许视角相关反照率,用它解释从不同方向看到的虹膜颜色响应。因此,主体静态反照率的设计在眼部有专门调整。
这不是逐光线追踪完整眼球光学结构,但能让视线控制与眼部反射更稳定。
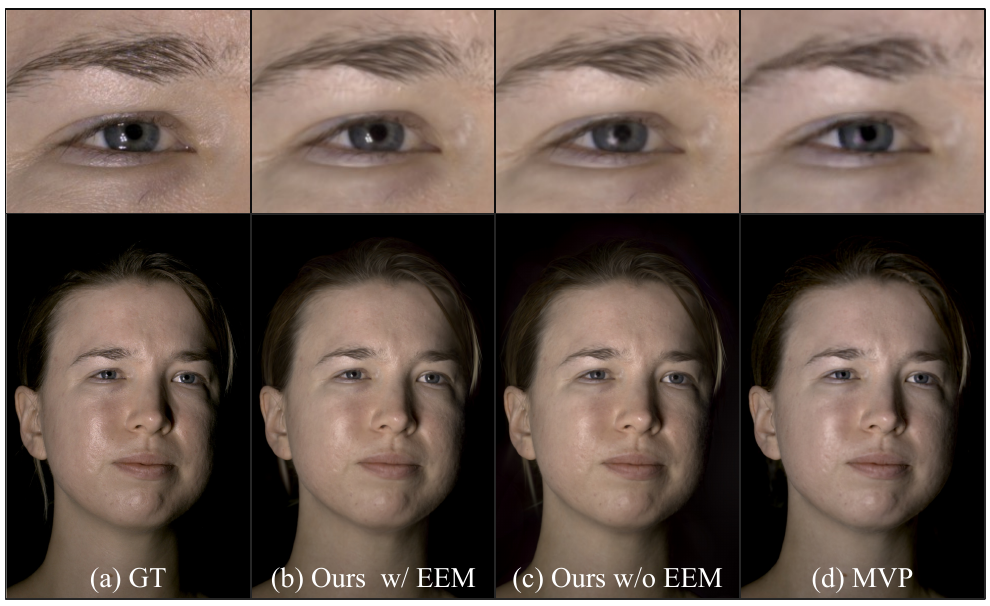
图4|真值、带显式眼球的高斯模型、不带显式眼球的高斯模型、MVP体素基元。全部使用相同的本文外观模型。来源:原论文图4。
高斯几何提升了睫毛、皮肤等细节表现,显式眼球进一步改善了眼部高光。它说明,灵活的表示与适当的几何约束可以互相补充。
十一、训练:既要拟合图像,也要防止高斯走捷径
原论文式(11)为:
$$ \mathcal L=\mathcal L_{\mathrm{rec}} +\mathcal L_{\mathrm{reg}} +\lambda_{\mathrm{kl}}\mathcal L_{\mathrm{kl}}. \tag{11} $$
重建项由图像L1、D-SSIM和粗网格几何误差组成,原论文式(12)为:
$$ \mathcal L_{\mathrm{rec}} =\lambda_{\mathrm{l1}}\mathcal L_{\mathrm{l1}} +\lambda_{\mathrm{ssim}}\mathcal L_{\mathrm{ssim}} +\lambda_{\mathrm{geo}}\mathcal L_{\mathrm{geo}}. \tag{12} $$
图像项要求渲染接近观测,几何项给粗形状提供引导,KL项整理表情潜空间。正则项则限制高斯尺度,惩罚球谐产生的负漫反射颜色,并约束眼部高斯不要通过缩小、透明或降低可见性来逃避误差。
这些约束与前面的表示有关:球谐展开可能产生负值,自由高斯可能变得过大或过小,眼部稀疏高光又容易诱导不稳定解。损失设计是在限制这些具体问题。
作者在4张NVIDIA A100上,以batch size 16训练200,000次迭代;附录报告高斯模型在3天内收敛。它是逐人物的离线训练,不是打开摄像头后即时学会一个新身份。
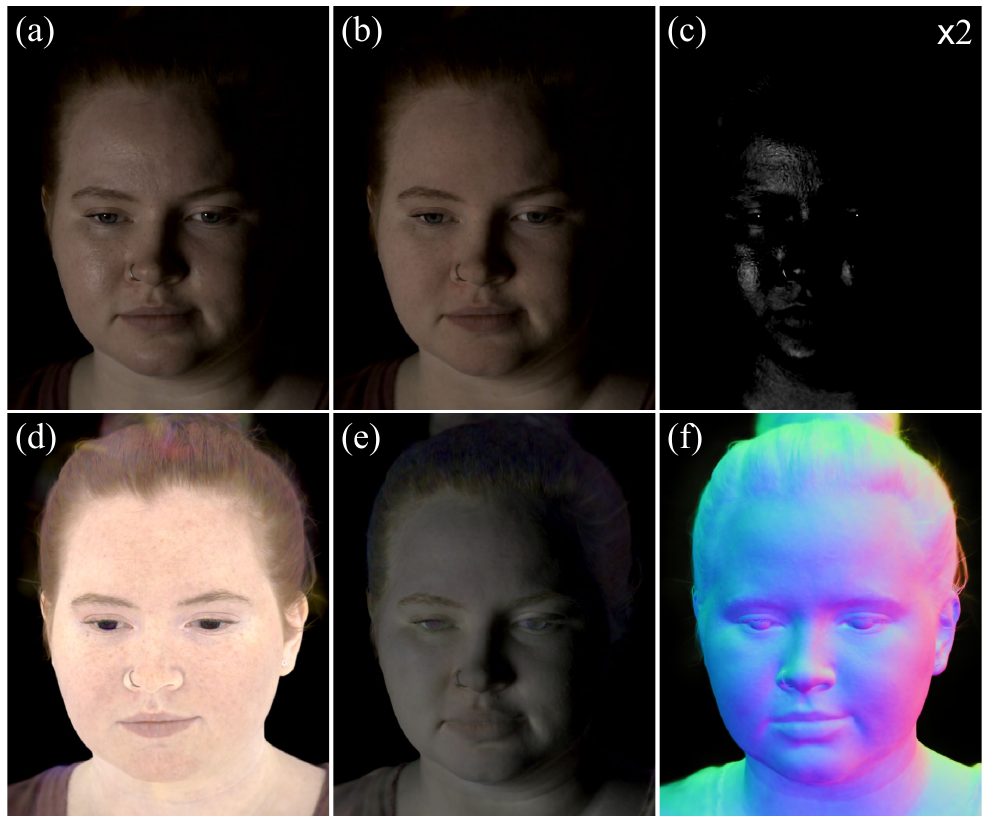
图3|完整渲染由漫反射与镜面分量相加得到;漫反射又由反照率与传输着色组合。镜面图为便于观察放大2倍。来源:原论文图3。
这些分解有助于理解模型,但都来自图像监督与结构约束,不是经过独立仪器逐项测量的材料真值。
十二、实验怎样比较:把几何与外观分开替换
作者使用3名受试者进行定量评价,另3名用于定性展示。测试包含约9,000帧未参与训练的对话表情,以及约100帧未见过的厌恶表情;还从训练中完全留出10种偏正面的灯光图案。
PSNR、SSIM和LPIPS在论文定义的面部掩码区域内计算,以减少背景影响。这些是图像指标,不是毛孔深度、发丝中心线或表面法线的真值误差。
研究的一个优点是分开替换几何与外观:几何比较固定外观模型,外观比较固定几何。这样比只比较整个系统,更容易判断提升来自哪里。
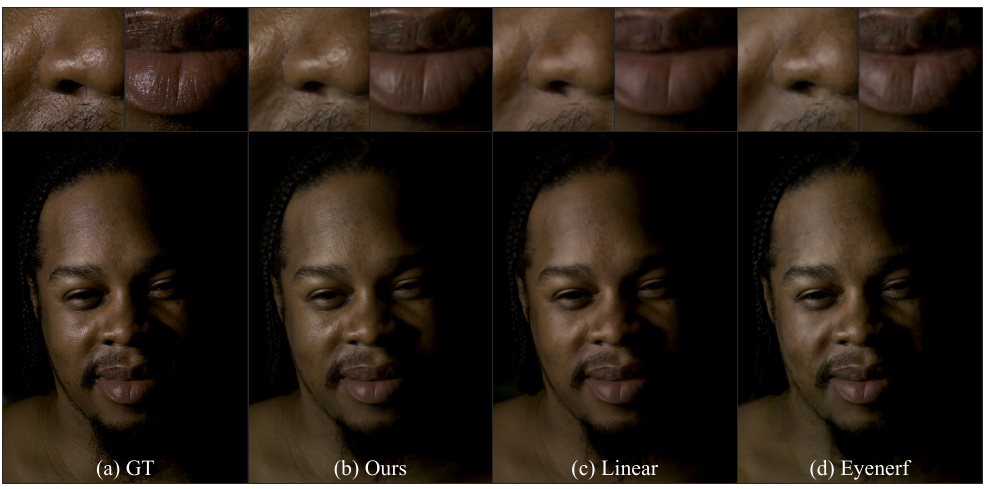
图5|真值、本文、Linear线性网络、EyeNeRF式球谐外观。使用相同高斯几何,且不含显式眼球。来源:原论文图5。
下面摘录原论文表1、表2中的三组主要配置。完整原表在素材包中保留。
| 几何+外观配置 | 留出表情PSNR ↑ | SSIM ↑ | LPIPS ↓ | 留出灯光PSNR ↑ | SSIM ↑ | LPIPS ↓ |
|---|---|---|---|---|---|---|
| 高斯+显式眼球+本文外观 | 36.501 | 0.943 | 0.110 | 34.042 | 0.858 | 0.148 |
| 高斯+本文外观,不含显式眼球 | 36.529 | 0.943 | 0.111 | 33.845 | 0.831 | 0.148 |
| MVP+本文外观 | 35.789 | 0.943 | 0.134 | 33.778 | 0.877 | 0.168 |
这些结果不是每一项都由完整模型领先。没有显式眼球的配置,留出表情PSNR略高;MVP搭配本文外观的留出灯光SSIM更高。完整模型的优势需要结合高光、细节表现及其他指标一起判断。
而“留出灯光图案”也不同于把某些物理灯具从训练中完全移除。采集图案会同时激活多盏灯,泛化协议必须按原文的图案定义理解。
十三、附录消融:哪些模块有稳定收益,哪些仍有不确定性?
原论文补充表3给出:
| 设置 | PSNR ↑ | SSIM ↑ | LPIPS ↓ |
|---|---|---|---|
| 完整模型 | 34.042 | 0.858 | 0.148 |
| 去掉高阶单色球谐 | 33.762 | 0.853 | 0.152 |
| 去掉视角相关法线 | 33.927 | 0.864 | 0.148 |
| 改用常见球面高斯参数化 | 33.778 | 0.855 | 0.147 |
高阶单色球谐在这组指标上具有一致收益,与图6较清晰的阴影相对应。
视角相关法线则不是如此:去掉之后SSIM反而更高,LPIPS相同。球面高斯参数化的比较也类似,本文PSNR更高,另一种参数化的LPIPS略低。
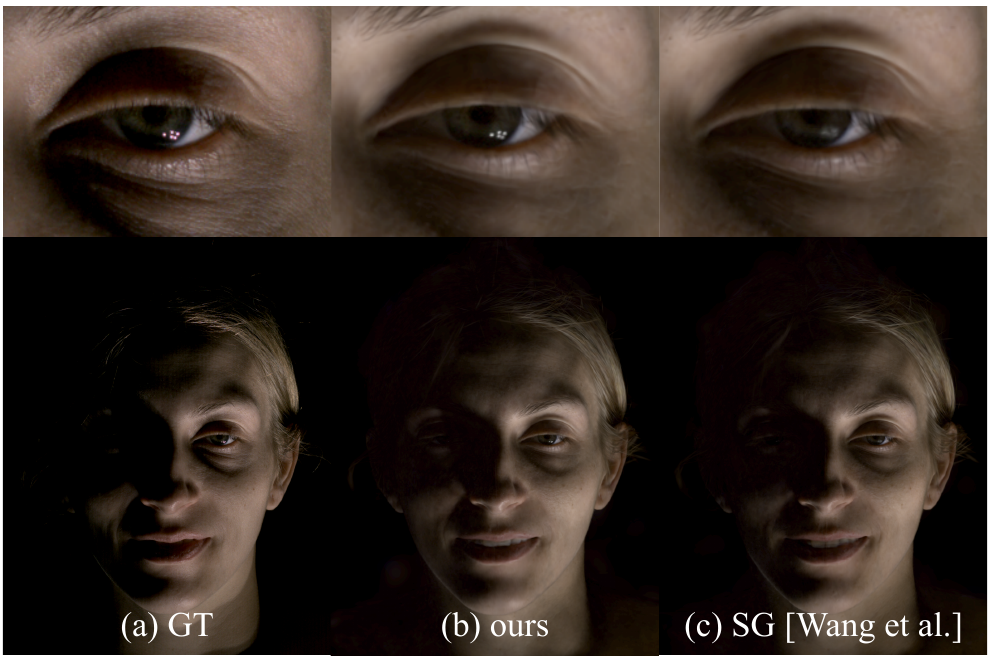
图7|真值、本文角度式球面高斯、常见参数化。作者强调本文对尖锐眼部高光的恢复更准确,但这不等于所有全局指标都更好。来源:原论文补充图7。
这些结果提醒我们,全局图像指标可能不足以突出一个只占很少像素的眼部亮点。局部视觉证据值得保留,也需要与全局指标的差异一起呈现。
作者还尝试只用通用头模板、刚性头姿与视线,关闭粗几何监督。
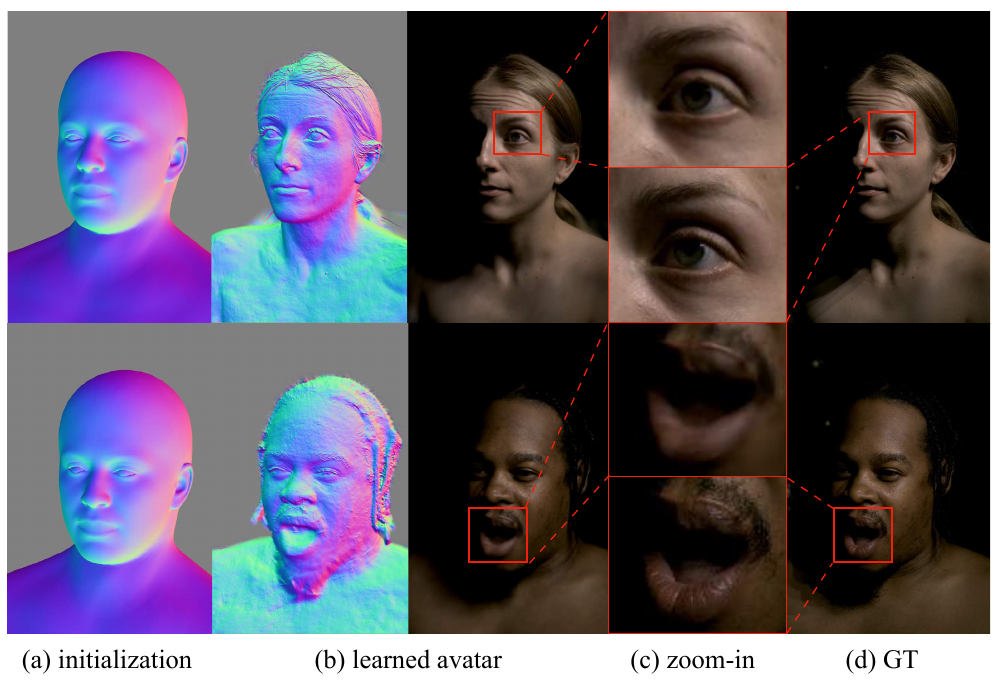
图8|通用模板初始化、学习后的化身、局部细节及真值。简化跟踪仍能得到较好的结果,但极端表情与眼部高光可能退化。来源:原论文补充图8。
这说明高斯表示有一定自适应空间,并不说明任何初始化、跟踪质量或数据覆盖都可以省略。
十四、能减少多少相机和照明?实验条件要一起看
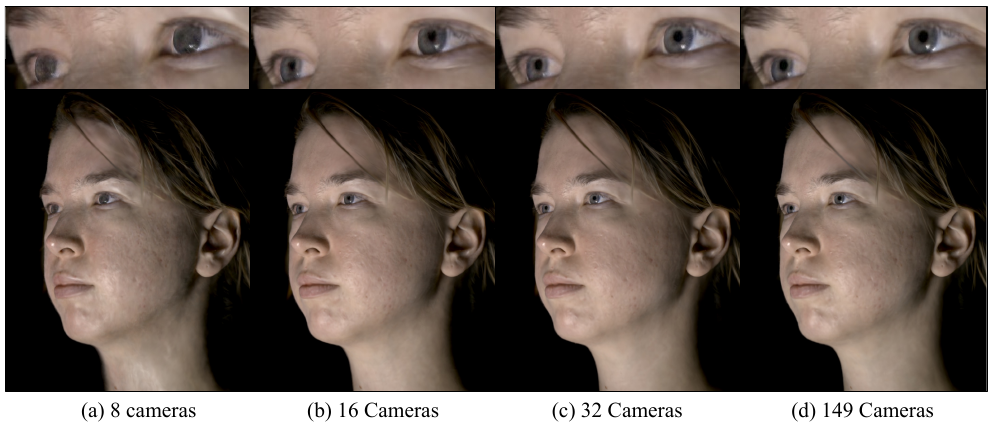
图9|使用8、16、32台相机与附录完整相机配置的比较,在训练表情上测试新视角。来源:原论文补充图9。
作者观察到,32台相机已能产生较好结果,8台时退化明显,16台仍会出现眼部等伪影。更多相机的收益在该配置中逐渐减小。
但训练序列中的头部刚性运动也会提供额外视角,因此不能把这个结果读成“只拍一帧、32个方向就足够”。
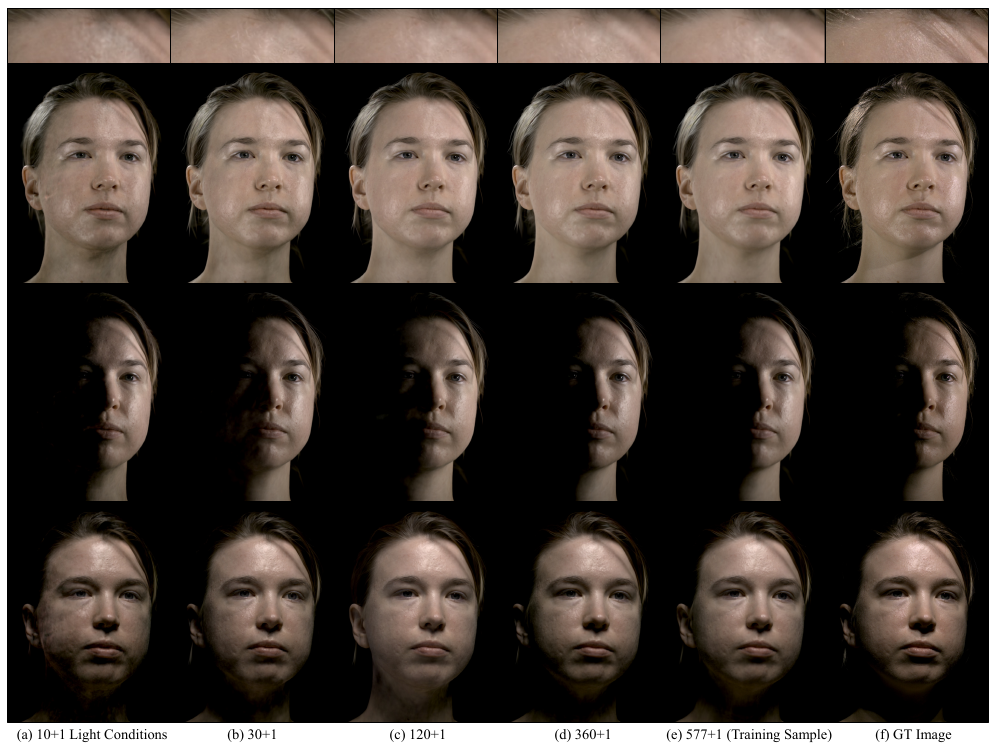
图10|从少量局部照明加全亮照明,到完整图案集合的比较。完整集合的示例包含该测试样本,阅读时需要注意这一条件。来源:原论文补充图10。
减少照明图案时,对应帧也会被删除,训练帧数随之改变;实验并不是只改变灯光数量、保持其他数据完全一致。由于采用多灯组合,也不能据此证明模型从未见过的物理灯具仍具有相同精度。
这些实验支持降低专业采集规模的潜力,却不能直接外推成普通单目视频条件下同样有效。
十五、实时性能与限制:一个化身很快,不等于多人场景没有成本
论文评估使用$1024\times1024$高斯配置,约104.9万个;VR展示使用$512\times512$配置,约26.2万个,以换取更高帧率。
附录在NVIDIA A100上报告,两种配置的溅射耗时分别为12.84 ms和6.40 ms。性能表另报告完整显式眼球配置的推断耗时为31 ms。它们是不同计时项目,不能只用溅射耗时宣称完整系统达到相应帧率。
VR展示也使用有线连接的消费级头显,不应改写成所有运算都在独立头显内完成。
目前方法依赖已知照明、多视角数据及跟踪预处理,训练的是个性化表情空间。扩展到未知照明的普通视频仍然困难;大量化身同时显示时,每个高斯的重打光计算还会累积,成本随化身数量增加。
更重要的是,本文的“全频反射”意味着镜面表示不再被固定低阶球谐的频带直接限制,能够用窄波瓣表达尖锐反射;它不是所有复杂材质、硬阴影和微几何都已无误差恢复的保证。
这篇论文展示的是几何表示与光传输表示共同设计的价值。高斯让细小空间结构能够高效渲染,球谐与球面高斯让不同频率的照明响应各得其所,显式眼球则为最敏感的局部反射补上几何约束。若进一步面向毛孔级人脸重建,还需要在这些逼真渲染之外,分别检验微几何尺度、方向与真实表面的对应精度。
