
 洗子
 匿名

| 论文信息 | 内容 |
|---|---|
| 英文标题 | 3D Gaussian Splatting for Real-Time Radiance Field Rendering |
| 发表 | SIGGRAPH 2023 / ACM Transactions on Graphics,42卷4期 |
| 作者 | Bernhard Kerbl、Georgios Kopanas、Thomas Leimkühler、George Drettakis;前两位共同一作 |
| 机构 | Inria、Université Côte d’Azur;Max-Planck-Institut für Informatik |
| 论文 | arXiv · DOI:10.1145/3592433 |
| 项目与数据 | 项目主页:论文、场景与结果下载 |
| 代码 | 官方 Gaussian Splatting 仓库 |
| 关键词 | 新视角合成、辐射场、各向异性高斯、可微光栅化、自适应加密 |
拍下一组照片,怎样让人自由地走进画面?
围着一辆自行车拍摄几十张照片,再在电脑里绕着它转动视角:车轮之间的空隙、后方的长椅和树叶,都应该随着观察位置自然变化。这需要恢复一种能从新位置生成图像的三维场景表示。仅仅在照片之间插值,很难正确处理遮挡和视差。
NeRF让这种新视角合成变得逼真,但生成一张图通常需要沿大量视线反复采样、累积颜色。即使场景已经学好,每次移动相机,仍要执行大量计算。训练速度、画质和显示速度,因此经常难以兼顾。
2023年的3D Gaussian Splatting,也就是3DGS,选择直接在三维空间中摆放一组可以学习的高斯。每个高斯有位置、大小、方向、透明度和随观察方向变化的颜色。相机移动时,把这些高斯投影到屏幕,再按遮挡关系混合,便能得到新图像。
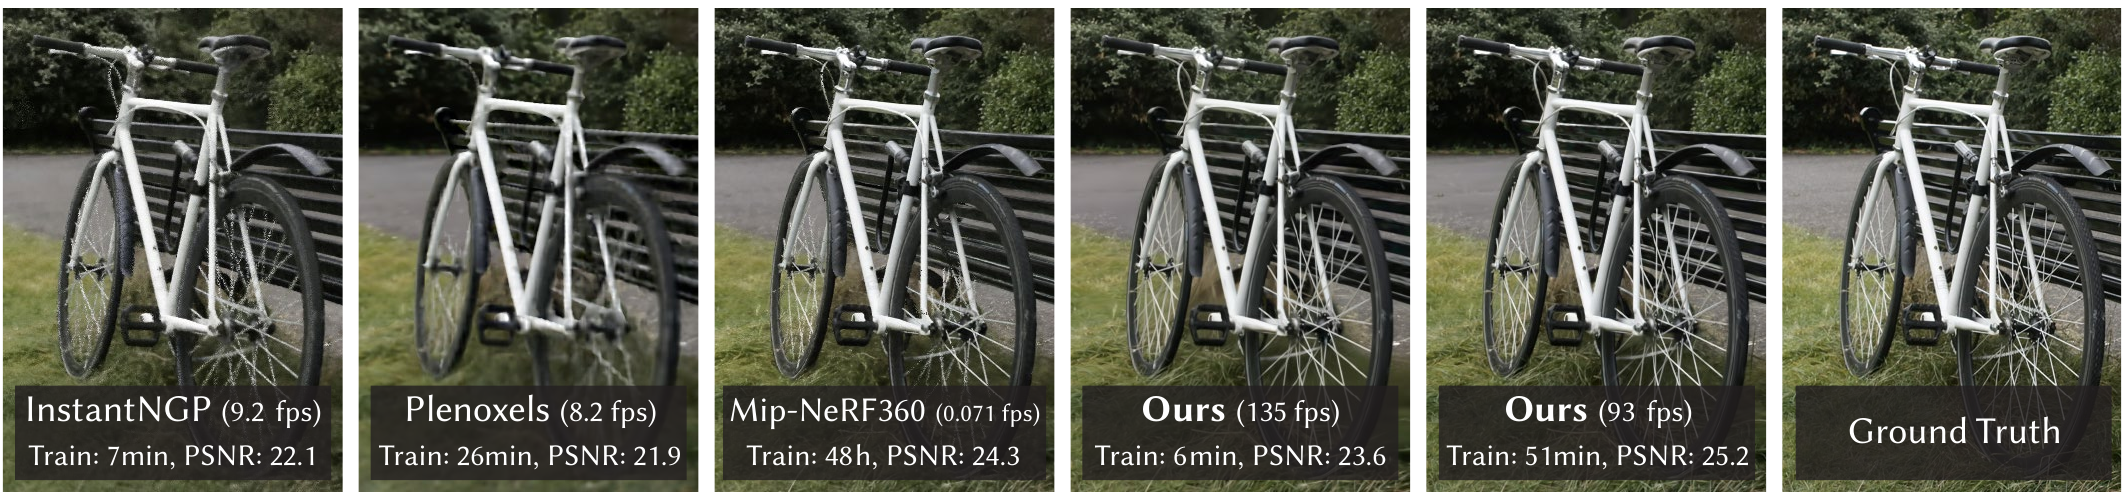
图1给出的是一个具体场景的结果:短时间训练已经能得到可交互的画面,继续训练则补足更多细节。图中的单场景数字与后文的数据集平均值属于不同统计口径,阅读时需要分开。
这篇论文的关键,在于让表示方法、优化策略和GPU渲染器彼此配合:高斯足够灵活,可以贴合场景;数量能够随训练调整,可以覆盖缺失区域;投影和混合能够并行执行,可以迅速把它们变成图像。
为什么要用一团有方向的“雾”?
先看两种常见表示。网格把物体描述成相连的三角形,适合快速渲染,但从照片中优化拓扑和复杂细节并不容易。普通点云容易初始化,却只记录离散位置;点太稀会漏出空洞,点太大又会模糊边缘。
高斯给点增加了空间范围。它在中心最强,向外平滑衰减,多个高斯可以重叠覆盖,位置和形状变化时,图像通常也会连续变化。这种平滑性有利于利用图像误差计算梯度。
进一步说,高斯不必是球。它可以拉长、压扁、旋转:墙壁附近可以是一片扁椭球,细杆附近可以是一条细长椭球。作者用各向异性描述这种“不同方向具有不同尺度”的能力。
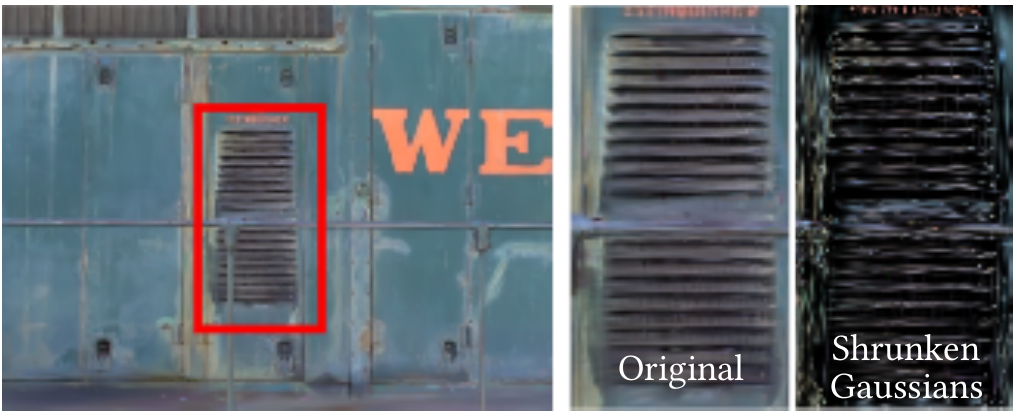
图3右侧把高斯缩小,用于观察它们怎样分布在火车结构上。这个操作只是可视化,并不是训练时的一步剪枝。看到的一串串小基元,也不意味着算法已经输出了一个闭合的三角网格。
把原论文公式(4)的中心化坐标展开,一个高斯可以写成:
$$ G(\mathbf{ p })=\exp\!\left[-\frac12(\mathbf{ p }-\boldsymbol{\mu})^T\boldsymbol{\Sigma}^{-1}(\mathbf{ p }-\boldsymbol{\mu})\right]. \tag{4} $$
这里,$\mathbf{ p }$是空间中的查询位置,$\boldsymbol{\mu}$是高斯中心,$\boldsymbol{\Sigma}$是控制形状与方向的协方差矩阵。中心处指数为零,函数值为1;离中心越远,数值通常越小。矩阵决定了“远”应该沿哪些方向衡量:沿长轴移动同样距离,衰减比沿短轴慢。
这里使用的是未归一化的高斯核,不要求它在整个空间的积分等于1。一个基元对图像有多强的遮挡作用,还由单独学习的不透明度决定。
直接优化矩阵中的每个数,可能把它变成一个不合法的协方差矩阵。作者因此改为优化旋转与尺度:
$$ \boldsymbol{\Sigma}=\mathbf{ R }\mathbf{ S }\mathbf{ S }^T\mathbf{ R }^T. \tag{6} $$
$\mathbf{ S }$是三个轴向尺度组成的对角矩阵,$\mathbf{ R }$是旋转矩阵。实现中用指数映射得到正尺度,用归一化四元数表示旋转。这样既能控制椭球,又容易保持矩阵合法。
为什么这种形式有效?下面是对原式的补充推导。对任意向量$\mathbf{ v }$,有
$$ \mathbf{ v }^T\boldsymbol{\Sigma}\mathbf{ v } =\left\|\mathbf{ S }^T\mathbf{ R }^T\mathbf{ v }\right\|_2^2\geq0. $$
也就是说,矩阵对应的二次型不会出现负值。这个分解把数学约束转化成了容易优化的参数形式。
三维椭球怎样落到二维屏幕?
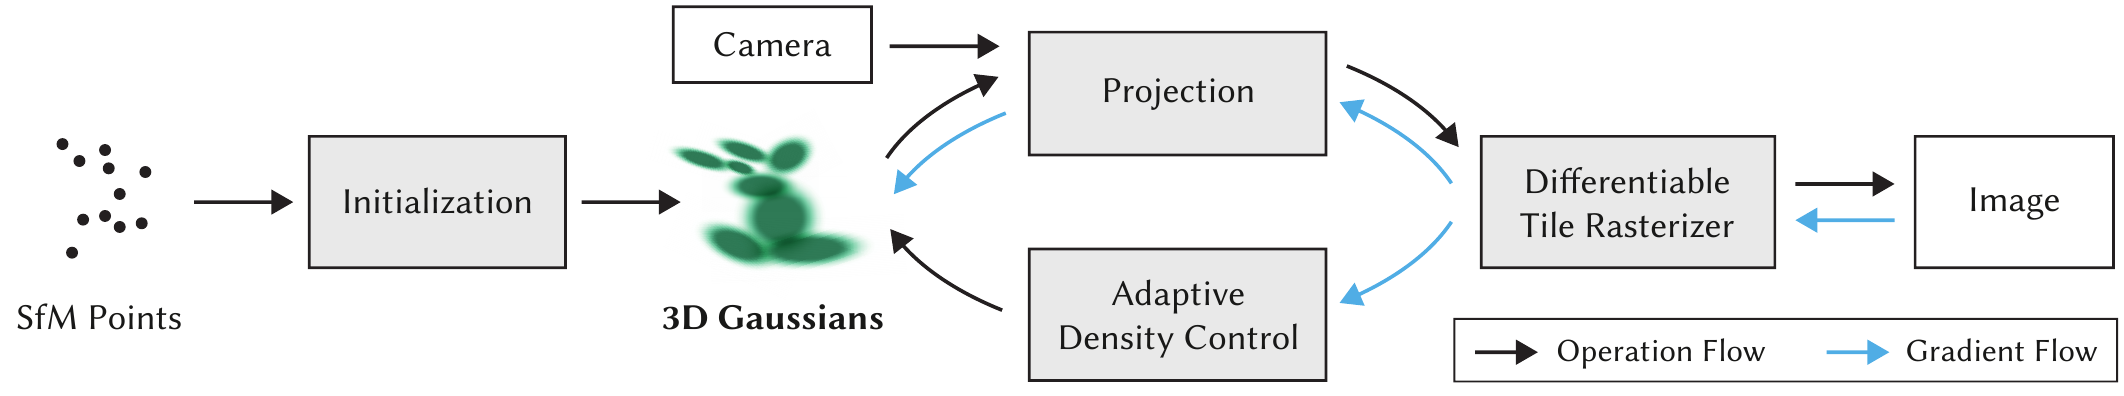
图2从左到右展示了完整过程。输入照片首先通过运动恢复结构,即SfM,得到相机参数和稀疏点云。每个点被初始化为一个高斯,随后投影到当前相机的屏幕上,形成二维椭圆状的覆盖区域。渲染图与真实照片比较后,误差沿蓝色箭头反向传回,调整三维参数。
高斯中心可以直接进行透视投影,但高斯的整体形状需要进一步处理。作者在中心附近,把透视变换近似为一个局部线性变换,再传播协方差:
$$ \boldsymbol{\Sigma}'=\mathbf{ J }\mathbf{ W }\boldsymbol{\Sigma}\mathbf{ W }^T\mathbf{ J }^T. \tag{5} $$
$\mathbf{ W }$表示视图变换在协方差上的线性作用,$\mathbf{ J }$是投影变换的雅可比矩阵。按原文约定,最后取屏幕方向对应的二维协方差,得到椭圆的尺度和方向。
这一步可以从熟悉的针孔相机理解。设相机坐标为$(X,Y,Z)$,像素坐标为
$$ u=f_xX/Z+c_x,\qquad v=f_yY/Z+c_y. $$
对三个坐标求偏导,得到下面这个补充说明用的二维投影雅可比:
$$ \mathbf{ J }_{\pi}=\begin{bmatrix} f_x/Z&0&-f_xX/Z^2\\ 0&f_y/Z&-f_yY/Z^2 \end{bmatrix}. $$
它回答了一个具体问题:空间位置发生一点变化,屏幕位置会朝哪个方向移动多少。把三维协方差左右乘上这个局部变换及其转置,就能把三维形状近似传到二维。
因此,3DGS的屏幕椭圆来自局部仿射近似。它不是对任意大高斯进行精确的透视投影;这一点也与后续2DGS关注的透视一致表面求值有关。
每个高斯还携带球谐系数,用于根据观察方向计算颜色。可以把球谐理解为一组描述方向变化的基函数:低阶表示平缓变化,高阶增加方向细节。原文逐步启用0到3阶,共4个频带、16个方向基函数,每个RGB通道各有一组系数。
这使模型能够拟合部分视角相关外观。不过,球谐颜色记录的是采集光照下“从这个方向看是什么颜色”,没有把光源、反射率和材质分开,因而不直接提供任意换光能力。
一个像素被多个高斯覆盖,应该听谁的?
假设屏幕上某个像素先看到一层半透明的前景,后面还有物体和背景。前景越不透明,后面的颜色就越难透过来。这个规则正是前向透明度混合。
为避免把基元自身的不透明度与像素处的实际贡献混淆,下面把前者记为$o_i$,把后者记为$a_i(\mathbf{ p })$。这是解释时的符号区分:
$$ a_i(\mathbf{ p })=o_iG_i^{2D}(\mathbf{ p }). $$
靠近投影高斯中心的像素,受到它的作用较强;离开中心后,作用逐渐衰减。按照从近到远的顺序,原论文公式(3)的混合关系为:
$$ \mathbf{ C }=\sum_{i\in\mathcal{N}}\mathbf{ c }_i a_i\prod_{j<i}(1-a_j). \tag{3} $$
$\mathbf{ c }_i$是颜色,$a_i$是当前位置的不透明度,乘积表示前面所有高斯还留下了多少透光机会。若前两层不透明度分别为0.6和0.5,第一层的颜色权重是0.6,第二层是$(1-0.6)\times0.5=0.2$,还剩0.2的透光率留给后方。
这与NeRF的体渲染具有相通的合成结构。NeRF中一个小采样区间的不透明度通常写成$1-\exp(-\sigma_i\delta_i)$;将它记为$a_i$,累积透光率就同样成为前面各项$(1-a_j)$的乘积。
两者的联系在于颜色合成规则。3DGS计算的是投影高斯对像素的覆盖,不需要像原始NeRF那样沿每条视线进行密集步进采样;也不能仅凭形式相似,就认定它精确计算了同一个连续体积分。
已经有了高斯,为什么还要不断复制和分裂?
SfM给出的点云是稀疏的,有纹理的区域点多,光滑区域可能点少。只移动这些初始点,很难同时填上空白、恢复细结构,又保持合理的计算量。因此,3DGS把参数优化与数量调整交替进行。
训练时随机选取一个相机视角,渲染图像,与照片比较。原论文的目标函数是:
$$ \mathcal{L}=(1-\lambda)\mathcal{L}_1+\lambda\mathcal{L}_{D\text{-}SSIM},\qquad \lambda=0.2. \tag{7} $$
$\mathcal{L}_1$约束像素颜色差异,结构相似性对应的损失帮助关注局部图像结构。梯度通过渲染过程传回中心、尺度、旋转、不透明度和球谐系数,再由Adam更新这些参数。这里没有一个负责逐点预测颜色的MLP;被学习的核心就是这些显式场景参数。
但误差较大并不一定意味着“把现有高斯再挪一点”就能解决。作者统计高斯视空间位置梯度的大小:如果一个区域持续需要明显调整,通常意味着它的当前表达不够合适。原文在预热后每100次迭代检查一次,用平均梯度阈值0.0002筛选需要加密的高斯。
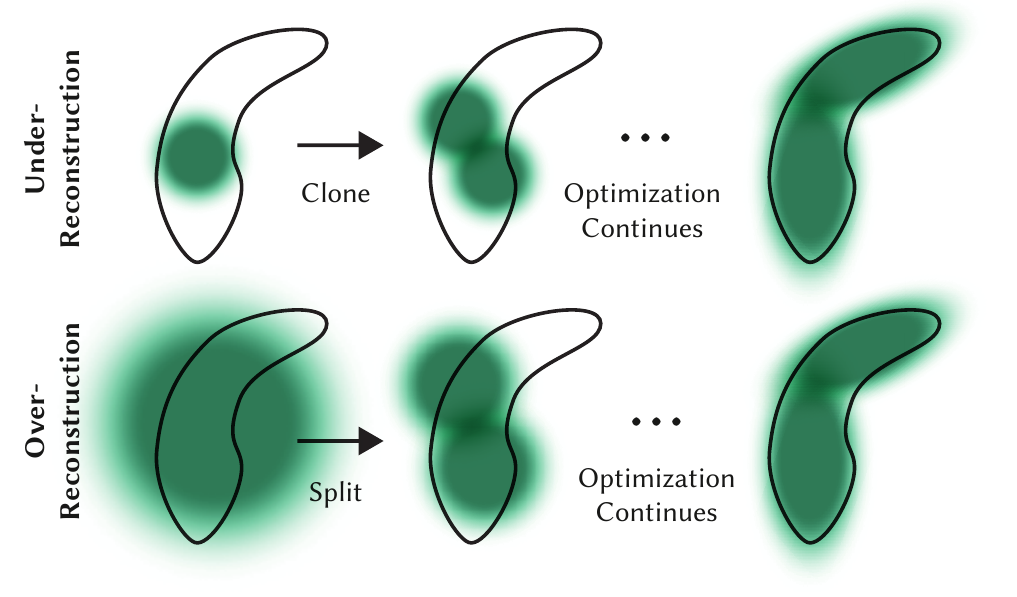
图4上排对应覆盖不足:已有高斯比较小,附近仍有区域需要表示,就复制高斯,再继续优化,让更多基元分担覆盖。下排对应表达过粗:一个较大的高斯跨过了复杂结构,就把它替换成两个更小的高斯,让它们分别调整。
分裂时,子高斯的位置按原高斯的空间分布采样,尺度按1.6的因子缩小。这个规则服务于加密与优化,不应解释为严格的物理质量或体积守恒。
与此同时,近乎透明、已经不起作用的高斯会被移除,过大的基元也会在相应阶段被处理。作者还每3000步把不透明度压到接近零,让有观测支持的高斯在后续优化中重新增强,而无效基元逐渐被剪掉。这有助于控制漂浮伪影与无依据的增长。
这里所谓“密度控制”,说的是高斯基元在场景中的分布与数量,不能直接等同于体渲染公式中的消光密度$\sigma$。
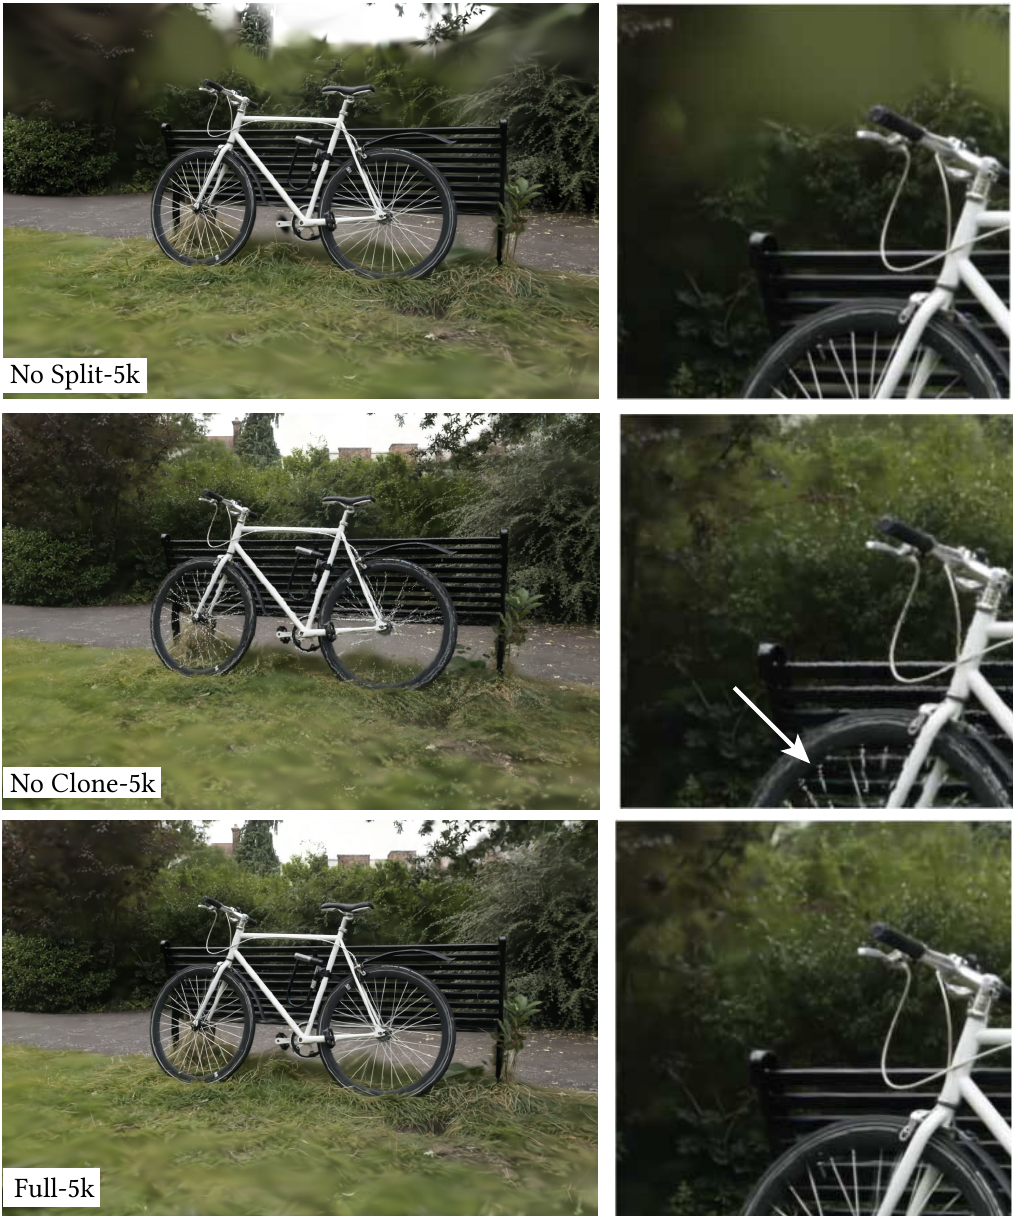
图8把这两种操作的效果放在一起。缺少分裂,大基元难以细化复杂轮廓;缺少复制,局部覆盖仍可能不足。二者针对不同情形,配合起来才能更完整地恢复细杆和轮廓。它们是离散的结构调整,不是对“新增几个高斯”这个整数直接求导。
真正让画面跑起来的,是怎样安排GPU工作
如果每个像素都去检查整个场景的几百万个高斯,即使用了显式表示,也很难实时。作者因此把屏幕分成16×16像素的图块,只让像素处理覆盖当前图块的高斯。
具体来说,渲染器先剔除视锥外的基元,再计算屏幕覆盖范围。一个高斯若跨过多个图块,就为这些图块分别建立临时记录。记录带有图块编号和高斯的视空间深度,用一次GPU基数排序,把同一图块的记录聚在一起,并按深度排列。
这里生成的是渲染期间的索引记录,与训练中的“复制高斯”不同,不会因此增加持久场景模型中的基元数。
接着,每个线程块负责一个屏幕图块,分批把相关高斯装入共享内存;像素线程沿从近到远的顺序累积颜色。若前方已经几乎完全遮住背景,就提前停止,省去后面贡献极小的计算。
这种组织方式同时减少了空区域计算、重复数据访问和无效透明度混合。它也保留了近似:排序主要依据高斯的深度,而不是为每个像素重新求一个精确的几何交点顺序。高斯很大或观察位置变化时,顺序跳变可能产生可见伪影。
训练还要求反向传播。如果为每个像素保存所有中间混合状态,内存开销会很大。作者让反向过程复用排序列表,从后向前遍历,并借助前向记录的最终状态恢复所需信息。
可以用透光率递推理解这一思想。以下是解释递推关系的补充推导:
$$ T_{i+1}=T_i(1-a_i)\quad\Longrightarrow\quad T_i=\frac{T_{i+1}}{1-a_i}. $$
已知后一步的透光率,就能在数值条件允许时恢复前一步,而不必逐层存下全部状态。实现还会限制不透明度、跳过极小贡献,以改善数值稳定性。这里的可微主要针对局部固定排序与可见性条件下的连续参数;排序、剔除和增删基元本身仍有离散变化。
实验里,快和好分别体现在哪里?
作者在13个真实场景上评价方法:Mip-NeRF360的9个场景、Tanks and Temples的2个场景,以及Deep Blending的2个场景。测试视角从输入序列中留出,用来检查模型能否合成没有参与训练的位置;每个场景单独训练。
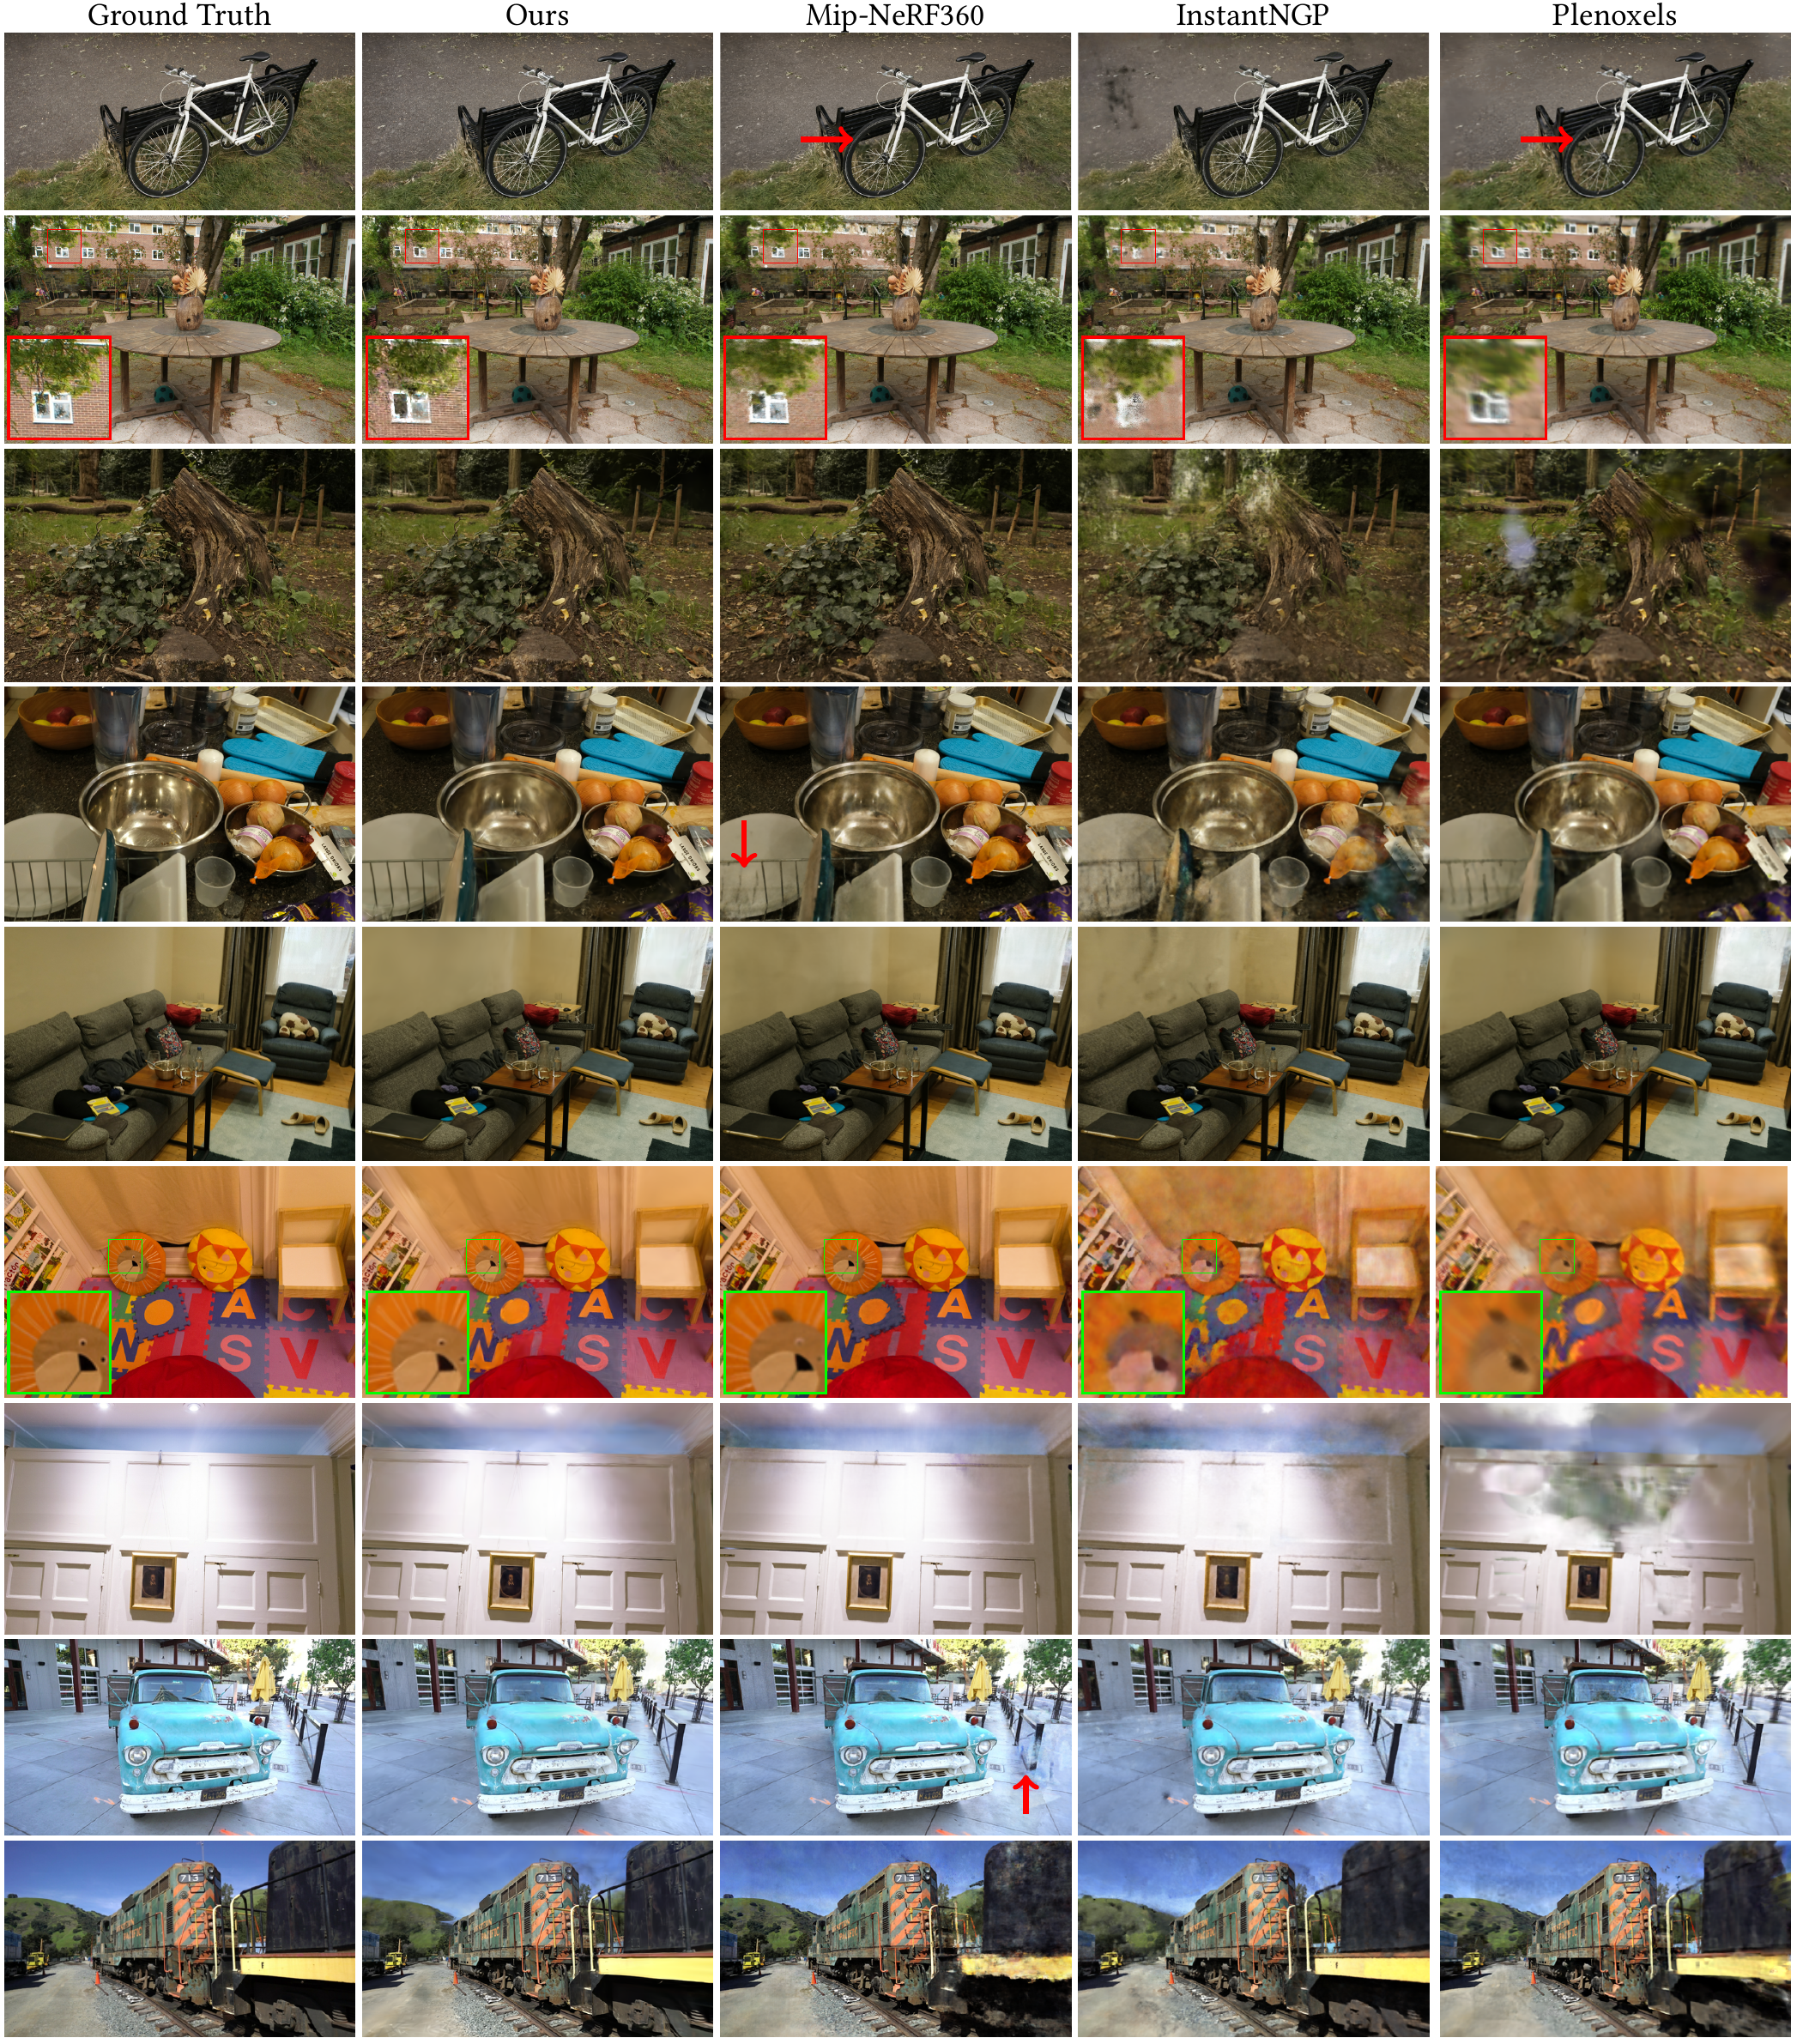
图5第一列是真实照片,后面依次是本文、Mip-NeRF360、InstantNGP与Plenoxels。自行车的细杆、花园的叶片和室内物体边缘,展示了表示细节的差异。这些图支持视觉判断,整体质量仍要结合数值指标。
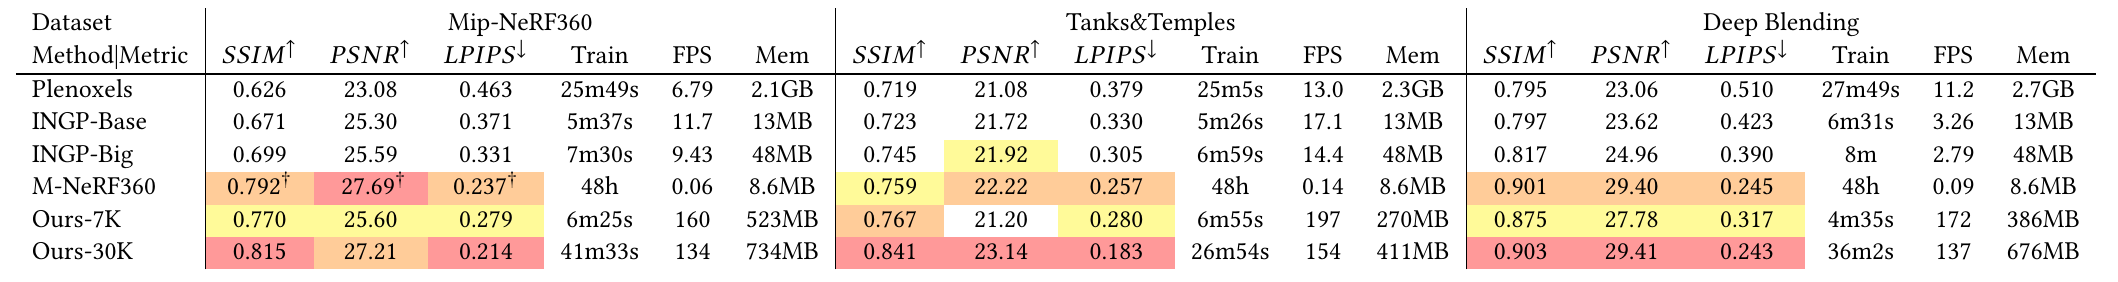
从表1提取3DGS两种训练长度,便于观察它自身的取舍。PSNR、SSIM越高越好,LPIPS越低越好;时间与帧率均为原表的数据集平均值。
| 数据集 | 迭代次数 | PSNR↑ | SSIM↑ | LPIPS↓ | 训练时间 | FPS↑ | 模型存储 |
|---|---|---|---|---|---|---|---|
| Mip-NeRF360 | 7k | 25.60 | 0.770 | 0.279 | 6分25秒 | 160 | 523 MB |
| Mip-NeRF360 | 30k | 27.21 | 0.815 | 0.214 | 41分33秒 | 134 | 734 MB |
| Tanks and Temples | 7k | 21.20 | 0.767 | 0.280 | 6分55秒 | 197 | 270 MB |
| Tanks and Temples | 30k | 23.14 | 0.841 | 0.183 | 26分54秒 | 154 | 411 MB |
| Deep Blending | 7k | 27.78 | 0.875 | 0.317 | 4分35秒 | 172 | 386 MB |
| Deep Blending | 30k | 29.41 | 0.903 | 0.243 | 36分02秒 | 137 | 676 MB |
继续训练后,画质提高,但模型更大,渲染也略慢。这符合加密过程的直觉:更多高斯能够分担细节,同时带来更多投影与混合工作。
与质量基线相比,Mip-NeRF360方法在同名数据集上的PSNR是27.69,高于3DGS的27.21;3DGS的SSIM和LPIPS则更好。因此,原表支持的是质量接近或在部分指标上超过此前方法,同时大幅提高渲染速度,并非每项指标都第一。
硬件与计时也需要对齐:本文结果主要在A6000上测得,而Mip-NeRF360基线使用4张A100运行约12小时,原文按总GPU时记作48小时。这个数不能直接解释为同一张A6000上的实测墙钟时间。各数据集的评测分辨率也不同,表里的全部FPS不能统一标成“1080p实测”。
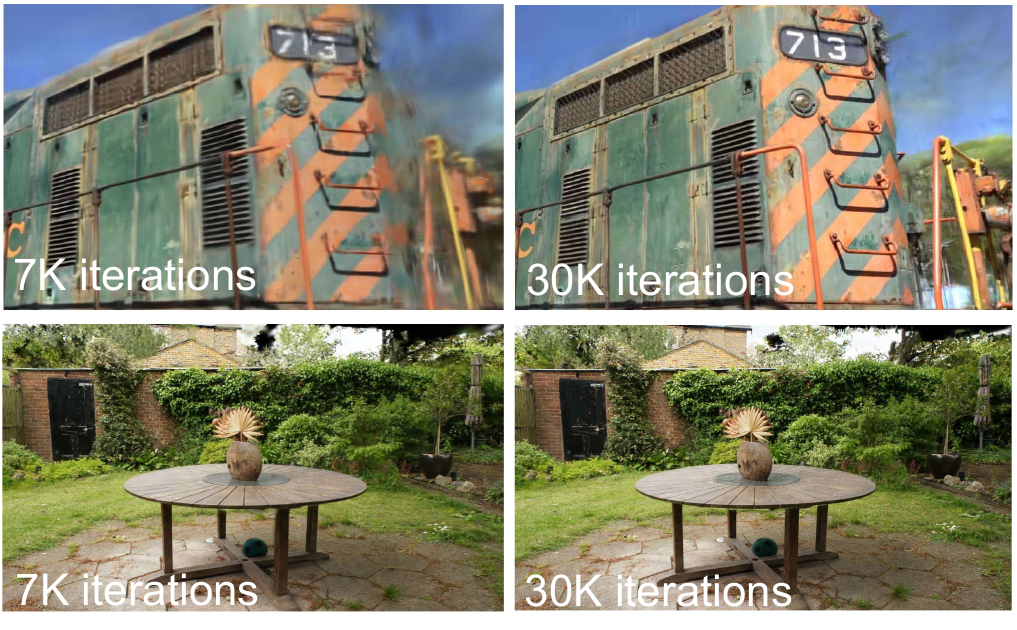
图6上排的火车场景,长时间训练明显减少了背景伪影;下排花园的差别小得多。这说明更多训练能带来多少改善,取决于场景本身,并不是所有画面都需要等比例增加计算。
原论文还在8个Synthetic NeRF场景上测试,平均PSNR为33.32。它说明方法也适用于受控的合成物体场景,但不能拿这个平均值替代真实室内外场景的表现。
哪些设计真的有用,消融实验怎样回答?
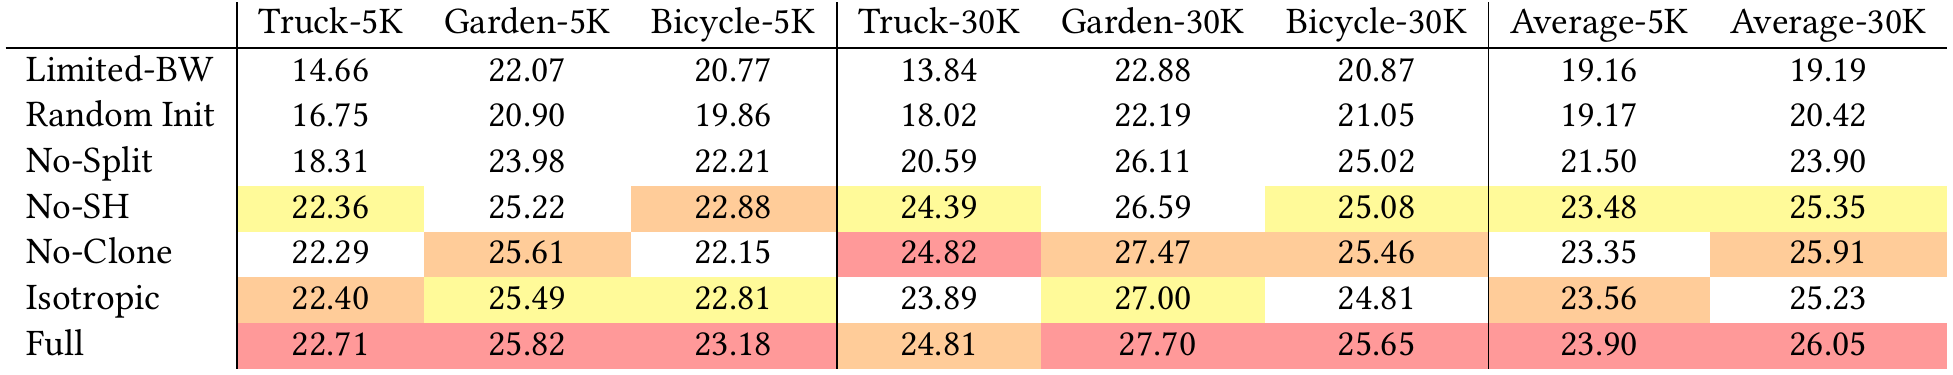
消融实验在Truck、Garden和Bicycle三个场景上进行。30k迭代时,完整方法平均PSNR为26.05;去掉分裂降到23.90,改成各向同性降到25.23,去掉球谐降到25.35。它们分别对应局部细化、形状适配和方向外观的贡献。
若把反向传播贡献限制在前10个相关基元,平均PSNR降到19.19。这个结果解释了为什么渲染器不仅要快,还要让足够多的相关高斯获得梯度。前向看起来接近的简化,可能妨碍后续优化。
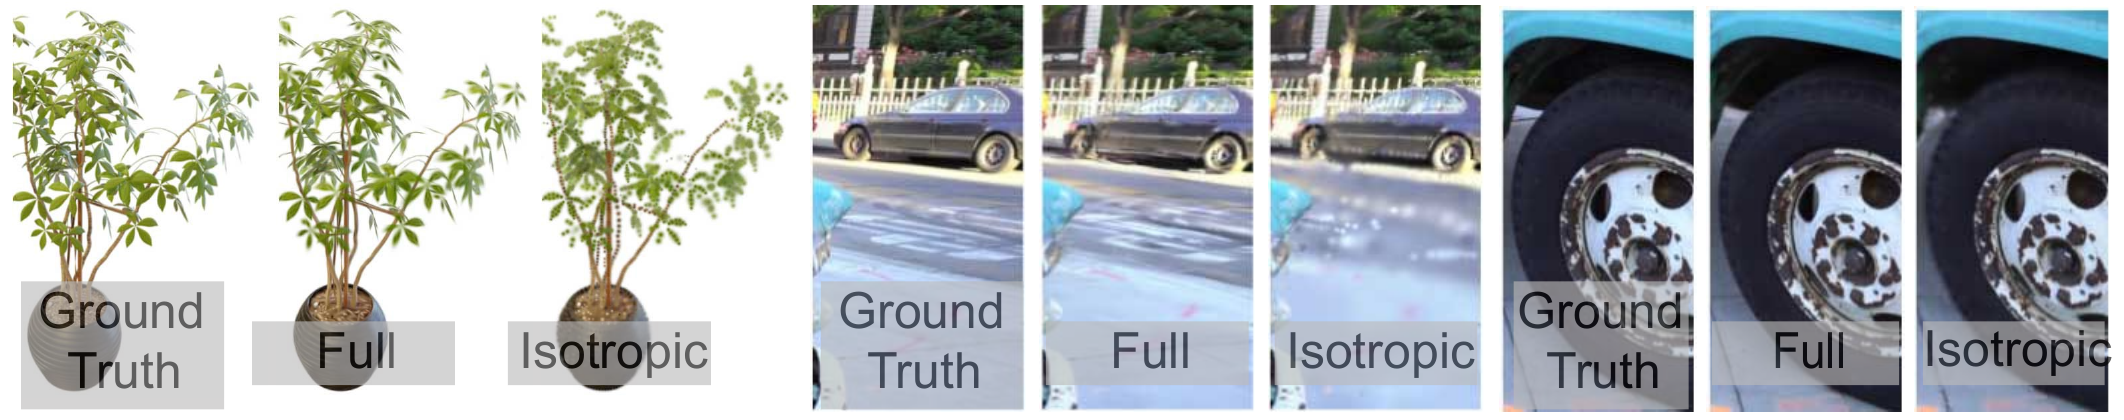
图10的Ficus示例中,两种配置都限制最多5k个高斯,便于观察表示差异。图中的细枝、车轮和植物进一步说明:允许基元拉长与旋转,可以用更贴合结构的形状覆盖场景。不过,消融是特定场景与设置下的证据;不能据此推断每个模块在每个单独场景上都严格提高所有指标。
从3DGS读到2DGS,以及人脸重建
3DGS成功解决了一个很具体的问题:怎样从多视角照片优化出高质量、可实时显示的场景外观。它让三维表示直接进入GPU擅长的投影与混合流程,又通过自适应增删基元维持表达能力。
这也帮助理解后续工作的切入点。对于2DGS,关注点进一步转向具有一致表面解释的几何;对于可重打光头像,必须继续处理材质与光照的分离;对于偏振引导的人脸重建,还需要把偏振观测提供的物理约束接入优化。这些任务都超出了原始3DGS的RGB外观拟合目标。
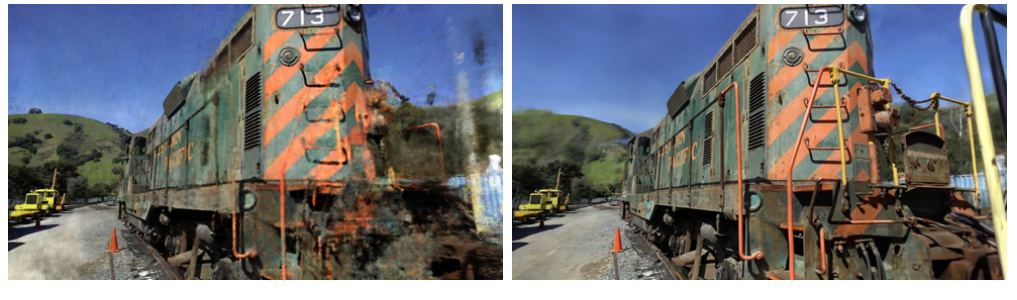
原文没有回避不足。观测稀疏或缺少训练视角覆盖时,场景仍可能出现漂浮物、拉长的高斯和不稳定背景;图11中两种方法都有各自的伪影。模型常包含百万量级的高斯,数百MB存储也明显高于小型神经网络表示。训练峰值显存和模型文件大小还是不同的开销,不能混为一谈。
因此,渲染出的毛孔纹理清晰,并不足以证明毛孔的三维深度已经准确恢复。评价几何还需要独立的几何真值、表面误差或其他有针对性的证据。原论文主要报告的是图像质量、训练与渲染效率,没有提供毛孔级人脸几何验证。
读懂这篇基础论文,最有价值的是理解这套方法如何协同工作:连续可调的高斯让图像误差能够反向优化场景,自适应加密把表达能力放到需要的位置,图块化渲染器再把这些基元高效地转成画面。后续研究对几何、反射和人脸细节的改进,正是在这套机制上加入新的约束与表示能力。
