
 洗子
 匿名

一个数字人正面看起来很像本人,但当他皱眉、闭眼,或者镜头拉近到胡须和眼角,细节就可能开始变糊。脸型还在,表情也大致正确,细纹和毛发却没能跟着运动保持清晰。
这并不只是渲染分辨率不够。即使输出一张更大的图片,如果用于表示皮肤的元素没有被放在合适的位置,或者不同表情下的细节没有对齐,放大之后仍然会模糊。
TeGA关注的正是这个问题。它从多视角视频建立可驱动的头部化身:用网格控制大范围运动,在网格周围的连续空间里优化高斯,再用局部形变与动态明暗修正补足细节。模型最多使用400万个高斯,面向4K级高分辨率渲染。
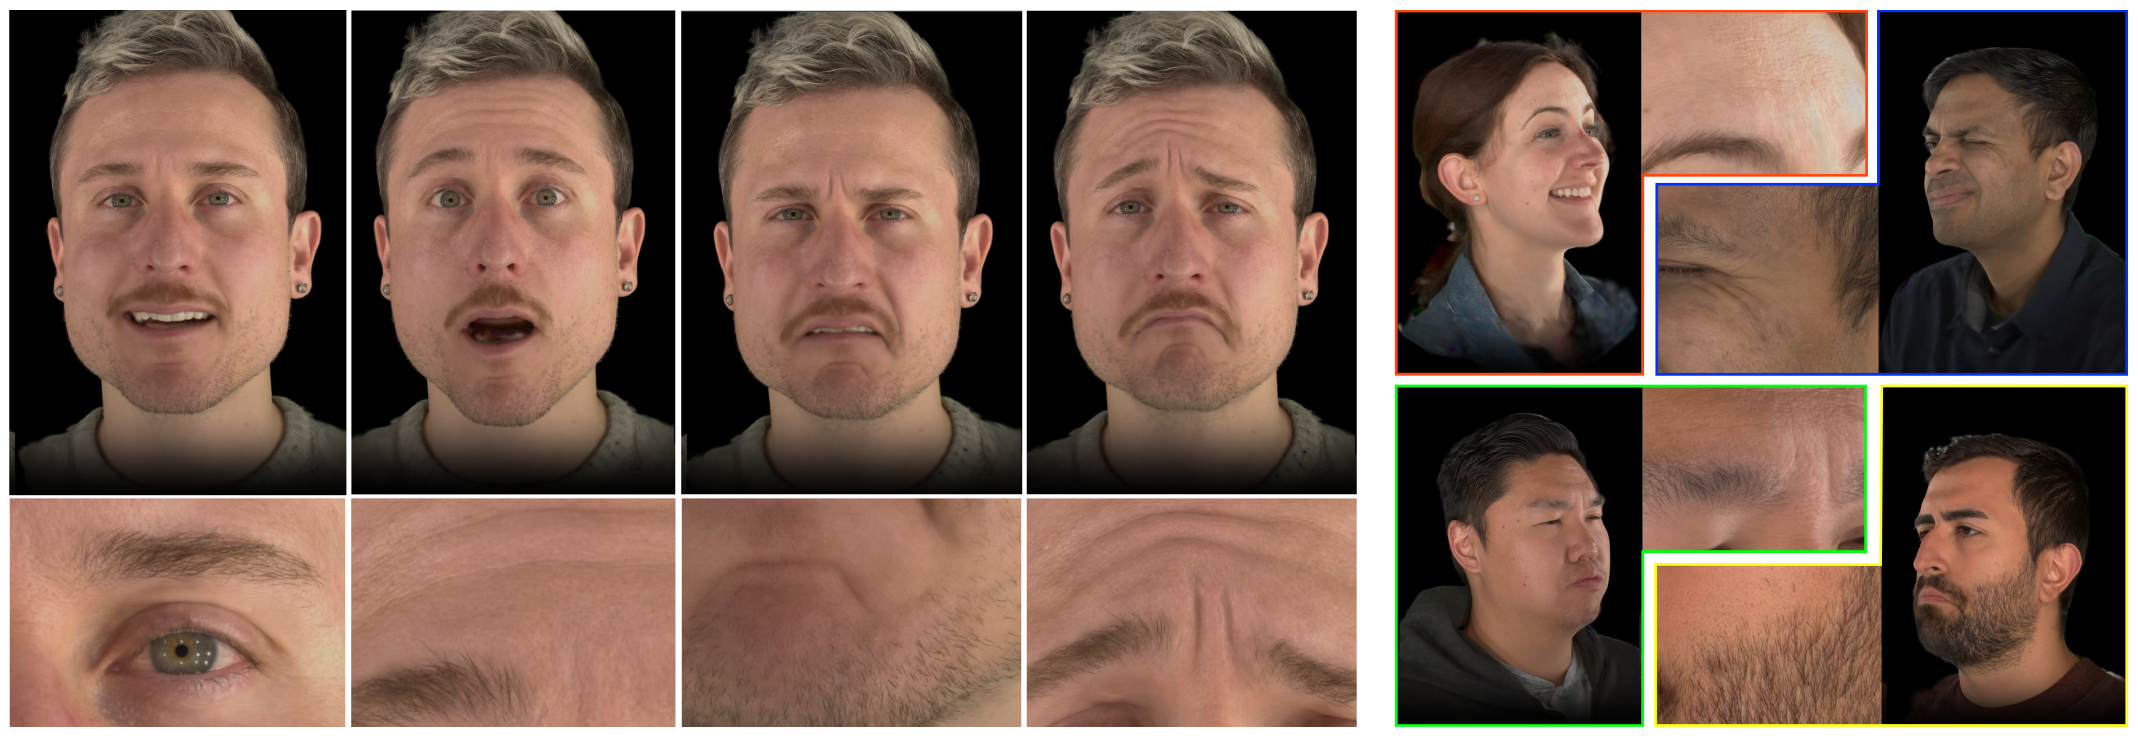
图1|不同表情下的头部重建,及眼周、额头、眉毛和胡须等局部细节。来源:原论文图1。
这篇论文值得细读的地方,是它如何把“网格容易控制”与“高斯便于增加局部细节”结合起来。高斯需要跟着脸动,也需要在优化时调整位置;网络需要描述表情变化,又不能让模型规模被固定的纹理分辨率卡住。
论文信息
| 项目 | 内容 |
|---|---|
| 英文标题 | TeGA: Texture Space Gaussian Avatars for High-Resolution Dynamic Head Modeling |
| 中文标题 | TeGA:用于高分辨率动态头部建模的纹理空间高斯化身 |
| 发表 | SIGGRAPH 2025 Conference Papers,Article 144 |
| 作者 | Gengyan Li、Paulo Gotardo、Timo Bolkart、Stephan Garbin、Kripasindhu Sarkar、Abhimitra Meka、Alexandros Lattas、Thabo Beeler |
| 机构 | ETH Zürich、Google |
| 项目主页 | https://syntec-research.github.io/UVGA/ |
| 论文 | https://syntec-research.github.io/UVGA/static/tega.pdf |
| DOI | https://doi.org/10.1145/3721238.3730710 |
| 代码 | 本次核对时,官方项目页未提供公开实现入口 |
| 公共数据 | Multiface:https://github.com/facebookresearch/multiface |
| 关键词 | 高斯溅射、头部化身、纹理空间、UVD、雅可比矩阵、表情形变、动态外观 |
一、为什么高斯人脸一动,细节就容易变糊?
先区分两种任务。重建某一个静止表情时,可以让高斯充分适应这一帧;构建可驱动化身时,同一套表示还需要解释许多表情,并在新的表情下继续工作。
运动估计稍有偏差,同一条细纹在不同帧就可能对应不同位置。训练将这些观测汇总到同一个模型里,结果往往趋向于折中,细节随之变软。增加输出像素数,也不能自动解决这种对应关系。
已有高斯头部方法大致有两种组织方式。一种把高斯绑定到网格三角形,让它们随网格运动;另一种让卷积网络在UV图上直接预测高斯属性。
前者方便驱动,也能增加高斯,但如果一个高斯被分配给了不合适的三角形,固定绑定就可能限制后续优化。后者能利用纹理空间的局部结构,却往往把高斯数量与输出纹理格点数量关联起来:一张$N\times N$属性图,通常对应固定预算的高斯。
TeGA尝试同时解决这两个问题:用连续UVD坐标组织高斯,使它们在优化时能够跨三角形移动;让CNN生成可查询的局部形变特征,使纹理分辨率与高斯数量分开。
这样,需要更多细节的区域可以继续增加高斯,而这些高斯仍然共享同一套表情控制。
二、整体流程:网格负责粗运动,高斯负责细外观
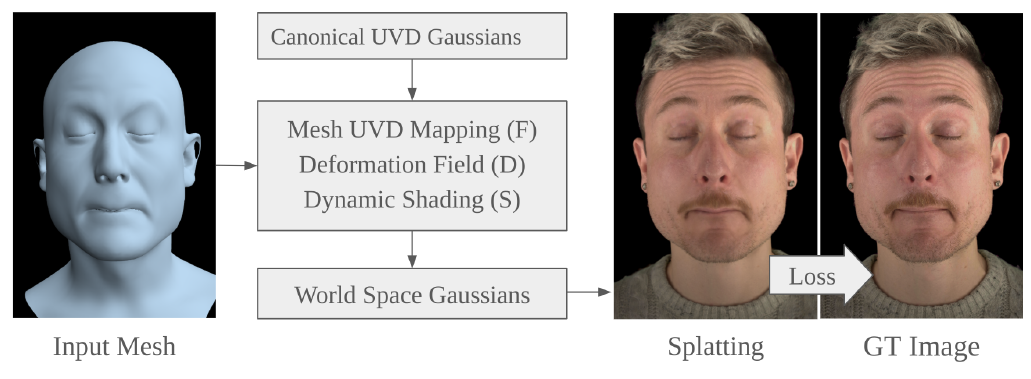
图2|输入表情网格后,将标准空间高斯映射并形变到世界空间,加入动态明暗,再通过高斯溅射渲染,与真实图像比较。来源:原论文图2。
TeGA的输入包括多视角训练图像,以及已经跟踪好的人脸网格。训练和驱动时,网格具有一致的拓扑与UV对应关系。
UV空间可以理解为三维表面的一张二维地图。 网格上的某个位置,在地图中有固定的地址。脸做表情时,地图地址不变,地址对应的三维位置随网格变化。
但头部细节不完全落在网格表面上,头发、胡须等还具有一定厚度。作者在UV坐标之外增加一个沿表面法线的位移维度D,形成UVD空间。每个高斯因而有三个连续坐标:在表面地图上的位置,以及离开表面的距离。
整个模型可以顺着数据流理解:网格先给出基本的位置与运动;残差场进一步修正局部运动;雅可比矩阵将局部形变传递给高斯的形状;动态明暗网络补充表情相关的亮暗变化;最后通过溅射得到图像。
三、先认识高斯:它不只是一个三维点
一个三维高斯具有中心、旋转、尺度、颜色参数和不透明度。中心决定它在哪里;旋转和尺度共同决定它在空间中呈现怎样的椭球形状。
论文用协方差矩阵描述高斯的形状:
$$ \boldsymbol\Sigma=\mathbf{ R }\mathbf{ S }\mathbf{ S }^\top\mathbf{ R }^\top. $$
$\mathbf{ R }$是旋转矩阵,$\mathbf{ S }$由三个方向的尺度组成,$\boldsymbol\Sigma$为$3\times3$矩阵。它既包含朝向,也包含沿不同方向延伸的程度。
颜色则使用球谐函数表示视角相关的变化:
$$ \mathbf{ c }(\mathbf{ v })=\mathbf{ b }_{SH}(\mathbf{ v })\mathbf{ h }. $$
$\mathbf{ v }$是观察方向,$\mathbf{ b }_{SH}$是相应方向上的球谐基,$\mathbf{ h }$为颜色系数。论文采用的系数维度为$16\times3$,对应16个基与RGB三个通道。
渲染时,多个高斯投影到图像并按不透明度等因素进行混合。它们共同表达头部的外观,因此高斯中心的移动与高斯形状的变化,都影响最后的细节。
这也引出下一个问题:当皮肤发生拉伸时,只把高斯中心移到新位置,显然还不够。高斯本身的朝向和延展也应该随局部表面变化。
四、连续UVD:高斯怎样跟着网格走?
设高斯在标准UVD空间中的中心为$\boldsymbol\mu_{uvd}$,对应的世界坐标为$\boldsymbol\mu_{xyz}$。原论文式(1)写为:
$$ \boldsymbol\mu_{xyz}=F(\boldsymbol\mu_{uvd}). \tag{1} $$
$F$根据UV位置找到当前网格上的对应三角形,通过重心插值得到表面点和法线,再根据D坐标沿法线偏移。网格表情改变时,映射$F$也随之改变。
为说明其中的几何关系,可以写出下面的补充表达。设$\mathbf{ m }(u,v)$为网格表面位置,$\mathbf{ n }(u,v)$为插值得到的单位法线,则:
$$ F(u,v,d)=\mathbf{ m }(u,v)+d\,\mathbf{ n }(u,v). $$
这不是论文新增的一条编号公式,而是将式(1)的图形学含义展开。它说明:U和V负责在表面上定位,D负责向表面内外延伸。
与绑定到单个三角形的方式相比,高斯可以在连续UV位置上优化。它移到另一个三角形覆盖的区域后,使用新的对应关系,而不是一直继承最初的三角形绑定。
这里的“自由移动”描述的是训练中的位置优化。动画播放时,模型依然受到网格及表情形变的控制,并不意味着高斯脱离了人脸随意运动。
雅可比矩阵:描述当前位置附近怎样变形
位置映射还需要作用于高斯的形状。作者使用$F$的雅可比矩阵$J_F$,得到原论文式(2):
$$ \boldsymbol\Sigma_{xyz} =J_F\boldsymbol\Sigma_{uvd}J_F^\top. \tag{2} $$
雅可比矩阵是局部导数。因为输入UVD和输出XYZ都是三维,所以$J_F$是$3\times3$矩阵。它描述:在当前位置沿U、V、D分别挪动一点,世界空间会朝哪个方向、移动多少。
在上面的展开式中,它的三列可写成:
$$ J_F=\left[ \frac{\partial\mathbf{ m }}{\partial u}+d\frac{\partial\mathbf{ n }}{\partial u},\quad \frac{\partial\mathbf{ m }}{\partial v}+d\frac{\partial\mathbf{ n }}{\partial v},\quad \mathbf{ n } \right]. $$
这属于补充解释。表面位置与法线如何随UV变化,共同决定了附近空间怎样旋转、拉伸或倾斜。
为什么协方差要左右各乘一次雅可比?
下面从局部线性近似出发,补充式(2)的推导。
将高斯附近的随机位置写为$\mathbf{ z }=\boldsymbol\mu+\delta\mathbf{ z }$,其中$\mathbb E[\delta\mathbf{ z }]=0$。在中心附近对$F$作一阶展开:
$$ F(\boldsymbol\mu+\delta\mathbf{ z }) \approx F(\boldsymbol\mu)+J_F\delta\mathbf{ z }. $$
因此,变形后的局部位置偏差近似为$J_F\delta\mathbf{ z }$,其协方差为:
$$ \begin{aligned} \mathbb E\left[(J_F\delta\mathbf{ z })(J_F\delta\mathbf{ z })^\top\right] &=J_F\mathbb E\left[\delta\mathbf{ z }\delta\mathbf{ z }^\top\right]J_F^\top\\ &=J_F\boldsymbol\Sigma_{uvd}J_F^\top. \end{aligned} $$
这样,高斯的中心与形状就服从同一个局部几何映射。该关系对线性映射精确成立,对一般非线性映射则是一阶局部传播,不能理解成任意非线性变形后的分布都仍然严格保持高斯。
五、只预测三维位移,为什么还能得到旋转与拉伸?
网格提供了基本运动,但它通常比较粗,难以解释皱眉时细小的局部挤压、眼周变化或胡须附近的复杂运动。因此,TeGA增加了残差形变场。
原论文式(3)为:
$$ \begin{aligned} \boldsymbol\mu_{xyz} &=F(\boldsymbol\mu_{uvd})+\Delta\boldsymbol\mu_{xyz},\\ \Delta\boldsymbol\mu_{xyz} &=D(\boldsymbol\mu_{uvd};\mathbf{ f }_{uv}). \end{aligned} \tag{3} $$
$D$是学习到的形变场,输入高斯的UVD位置及局部表情特征$\mathbf{ f }_{uv}$,输出世界空间中的三维残差位移。注意,这里的函数$D(\cdot)$与UVD中的位移坐标D并不是同一个对象。
如果网络还要独立预测旋转、缩放等参数,输出与约束都会更复杂。TeGA利用前面的雅可比传播,将全部位置映射记为$F+D$,原论文式(4)得到:
$$ \begin{aligned} \boldsymbol\Sigma_{xyz} &=(J_F+J_D)\boldsymbol\Sigma_{uvd}(J_F+J_D)^\top\\ &=J_{F+D}\boldsymbol\Sigma_{uvd}J_{F+D}^\top. \end{aligned} \tag{4} $$
推导来自导数的可加性:对固定表情下的位置映射求导,有$J_{F+D}=J_F+J_D$,再代入式(2)即可。$J_D$描述残差位移在空间中如何变化,通过自动微分计算。
关键在于,网络预测的是随位置变化的位移场。如果所有位置都加上完全相同的位移,只会整体平移;如果相邻位置的位移不同,局部区域就会被拉伸、旋转或剪切。这些变化已经包含在位移场的空间导数中。
因此,输出只有三个位置分量,并不意味着形变只能平移。模型通过局部导数将空间变化传给协方差,从而减少了独立预测形状变换的负担。
眼球是一个例外。作者将放在眼球上的高斯排除在这一残差形变场之外,避免把刚性眼球当成皮肤一样进行局部扭曲。
六、局部表情特征从哪里来?
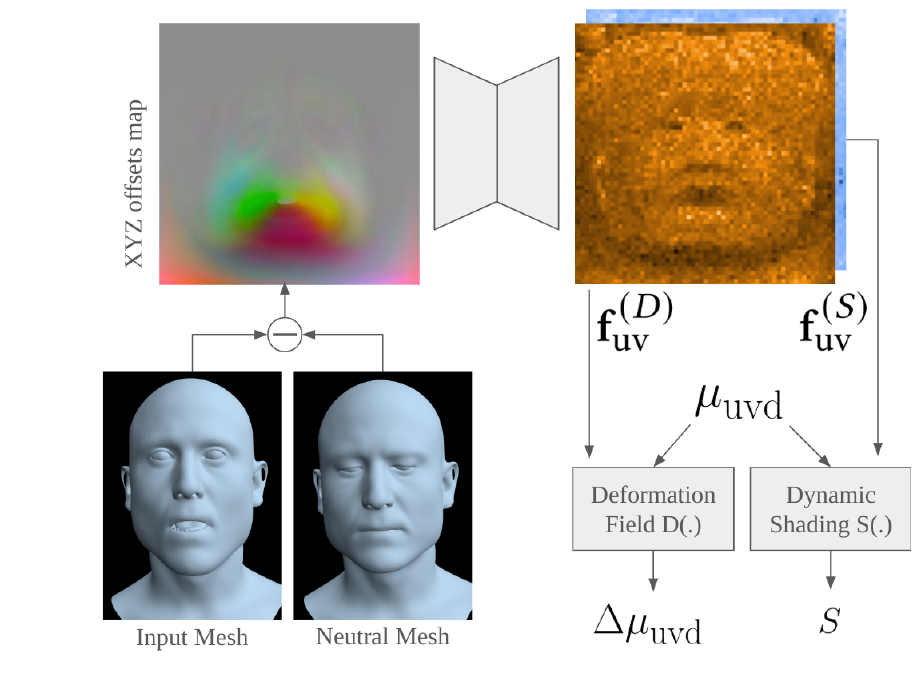
图3|输入表情网格与中性网格的顶点位置差,在UV空间经U-Net编码;局部特征分别送入形变与动态明暗MLP。来源:原论文图3。
作者先把当前表情网格的XYZ顶点坐标栅格化到UV空间,再减去中性网格对应的坐标图,得到逐纹理像素的顶点偏移。计算时去除整体头部姿态,只保留表情导致的变化,避免把转头误当成局部皮肤变形。
U-Net读取这张偏移图,输出$N\times N\times64$的潜在特征纹理。论文设置$N=256$。对于任意高斯,系统根据它的连续UV位置,通过双线性插值读取局部特征$\mathbf{ f }_{uv}$。
一个具有两个隐藏层的小MLP,再结合经过正弦位置编码的UVD坐标与局部特征,预测式(3)中的残差位移。
为什么这能摆脱固定高斯数量?
若CNN直接在每个纹理格点输出一个高斯,增加高斯数量通常就需要增加纹理分辨率。TeGA的纹理图存储的是局部表情特征,高斯则作为另一组独立的连续查询点存在。
因此,一张$256\times256$特征图不只服务于65536个固定高斯。训练可以在头发、胡须等区域继续增加查询点,各点仍从同一张特征图中取值,并结合自己的连续坐标计算形变。
这种分离降低了“增加高斯就必须同步扩大CNN输出”的压力,但并不意味着内存与高斯数量无关。高斯本身的属性、逐点查询和渲染仍有成本,所以作者依然设置了400万的数量上限。
局部特征也与单个全局表情向量有所不同。眉毛附近的查询点能够读取与该区域运动有关的特征,嘴角附近则使用另一处局部信息,更有利于描述位置不同、变化也不同的细节。
七、几何正确之后,皱纹为什么还可能不够明显?
皱眉会改变局部形状,也会改变亮暗。细沟加深后,内部常常更暗;如果颜色一直是与表情无关的固定属性,即使形变已经改善,皱纹仍可能缺少应有的视觉对比。
作者增加了表情相关的动态明暗项,原论文式(5)为:
$$ \mathbf{ c }_e(\mathbf{ v },\mathbf{ f }_{uv}) =\mathbf{ c }(\mathbf{ v })\,S(\boldsymbol\mu_{uvd};\mathbf{ f }_{uv}). \tag{5} $$
$\mathbf{ c }(\mathbf{ v })$是标准球谐颜色,$S$是一个标量,表示表情相关的明暗缩放。它由另一个具有两个隐藏层的小MLP预测。
U-Net的大部分编码计算共享,但最后一层分出专用于形变和明暗的特征,分别驱动两条MLP分支。这样可以对形变施加平滑约束,而不强迫动态明暗具有完全相同的平滑程度。
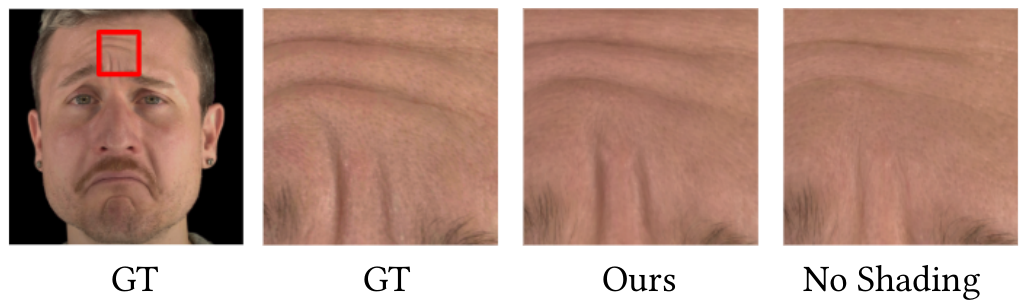
图7|从左到右为目标人物、真实局部、完整方法和移除动态明暗后的结果。来源:原论文图7。
图7中应重点观察额头皱纹的暗部。动态明暗补充的是随表情出现的亮度变化,让微小形变具有更接近照片的外观。
但这里并没有显式求解物理遮挡、光源或材质。$S$是从训练图像学习到的修正项,不能直接称为物理重光照模型。
而且,$S$只用一个数同时缩放RGB三个通道,无法单独改变色度。它可以让一处皮肤更亮或更暗,却不能充分描述血流变化导致的发红等动态肤色变化。这也是作者明确指出的限制。
八、怎样训练,才能避免细节与运动互相干扰?
模型同时优化高斯、局部形变和动态明暗,存在互相补偿的可能。例如,一处暗纹既可以通过改变位置解释,也可以通过把颜色调暗解释。TeGA没有一开始就让所有分支全力拟合细节,而是采用分阶段训练。
先建立标准体积,再学习残差运动
作者初始化约50万个高斯。对于落在无效UV区域的中心,投影到最近的网格三角形。初始残差场为零,动态明暗为1,让模型先从网格给出的基本运动开始。
最初1万次迭代先拟合标准高斯,不启用残差形变场。由于高斯已经能通过网格随表情运动,这段预热有助于先建立较稳定的体积外观,再让残差场处理剩余误差。
用图像损失拟合,再逐步加强感知细节
原论文式(6)为:
$$ \mathcal L =\lambda_1\mathcal L_1 +\lambda_{D\text{-}SSIM}\mathcal L_{D\text{-}SSIM} +\lambda_{VGG}\mathcal L_{VGG} +\lambda_{J_D}\mathcal L_{J_D}. \tag{6} $$
$\mathcal L_1$比较像素差,$\mathcal L_{D\text{-}SSIM}$约束结构相似性,$\mathcal L_{VGG}$强调感知特征,$\mathcal L_{J_D}$约束形变场平滑。前两项权重分别为0.8和0.2。
原论文式(7)的感知损失为:
$$ \mathcal L_{VGG} =\left\|F_{VGG}(I)-F_{VGG}(\widehat I)\right\|. \tag{7} $$
$I$是真实图像,$\widehat I$是渲染图像,$F_{VGG}$提取预训练VGG前四层的特征。
感知损失有助于恢复细节,但过早加入也可能干扰运动估计。作者在前半程将其权重设为0;训练过半后从0.01开始,指数增加到0.1。也就是先把运动与基本外观学稳,再加强高频细节。
平滑约束作用于整个空间,而不只作用于现有高斯
原论文式(8)为:
$$ \mathcal L_{J_D} =\sum_{\mathbf{ s }_{uvd}} \left\|J_D(\mathbf{ s }_{uvd})\right\|_F^2. \tag{8} $$
$\|\cdot\|_F$是矩阵元素平方和的平方根。惩罚雅可比矩阵的平方范数,就是限制残差位移在相邻位置之间变化得过于剧烈。
作者在UVD空间随机采样10万个点计算这一项,UV范围为$[0,1]$,位移范围为$[-50,200]$毫米。它约束的是整个被采样空间中的形变场,而不只检查当前高斯中心,因此能帮助尚未被高斯覆盖的位置保持较平稳的形变。
该项权重从1开始,在前半程指数降到0.1。开始时更强的平滑约束有助于稳定,后续适当放松,给局部细节留下空间。这里惩罚的是一阶导数,不能把它误写成二阶弯曲能量。
完整训练共6万次迭代,论文使用NVIDIA H100,耗时约10至16小时。
九、高斯怎样在需要细节的地方增加?
TeGA保留了3DGS的自适应加密:对投影误差信号较强的区域,通过克隆小高斯或分裂较大的高斯增加表示能力。触发信号来自渲染投影相关梯度,克隆与分裂则发生在UVD空间。
这使加密与表面坐标保持联系:新高斯不必锁死在父高斯原来绑定的三角形上,可以继续调整连续位置,找到更合适的对应关系。
因此,连续UVD、局部形变场和自适应加密是互相配合的。只有更多高斯而没有准确运动,细节可能仍被多帧平均;只有更灵活的运动而表示过稀,也无法支撑清晰的毛发和皮肤纹理。
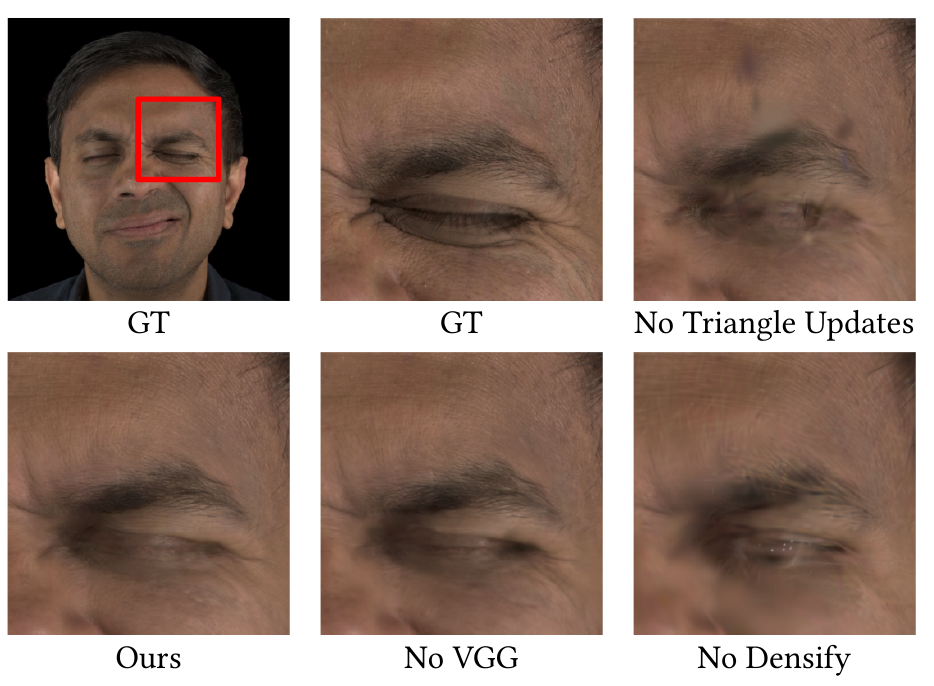
图6|比较完整方法、不更新三角形对应、不使用VGG损失和不加密的局部结果。来源:原论文图6。
图6的闭眼区域提供了直接观察:固定三角形继承可能在眨眼姿态留下伪影,移除加密会明显损失细节,移除感知损失也会使局部外观变软。它们分别对应参数组织、表示容量和训练目标三个层面的设计。
十、实验用了怎样的数据,测试的又是什么?
| 数据 | 人物与采集 | 训练设置 |
|---|---|---|
| 作者自采数据 | 8人,13台2600万像素相机,14个小面光源;每人44段30 fps短视频 | 每人均匀选400个时刻,图像下采样到$3072\times2048$ |
| Multiface子集 | 4人,选择40个相机视角,使用数据集提供的跟踪网格 | 每人均匀选400个时刻,分辨率$2048\times1334$ |
论文面向4K级高分辨率渲染,但自采数据实际训练尺寸是$3072\times2048$,Multiface则为$2048\times1334$。不能把所有训练数据都称为原生4K输入。
测试分为两类。一类是未见表情驱动,在三个训练相机视角下比较测试帧;另一类是新视角合成,使用训练表情,在三个保留相机上评价。这两项分别检验表情泛化和视角泛化,不宜合并成“任意新表情与新视角的全部组合”。
指标包括PSNR、SSIM、LPIPS,以及眼、鼻、嘴关键点的误差。关键点指标使用检测器在真实图与渲染图上的预测坐标计算均方差,反映图像中的表情对齐,并不是三维表面距离。
十一、与已有方法相比,TeGA改善在哪里?
先看表情和细节是否同时保留下来
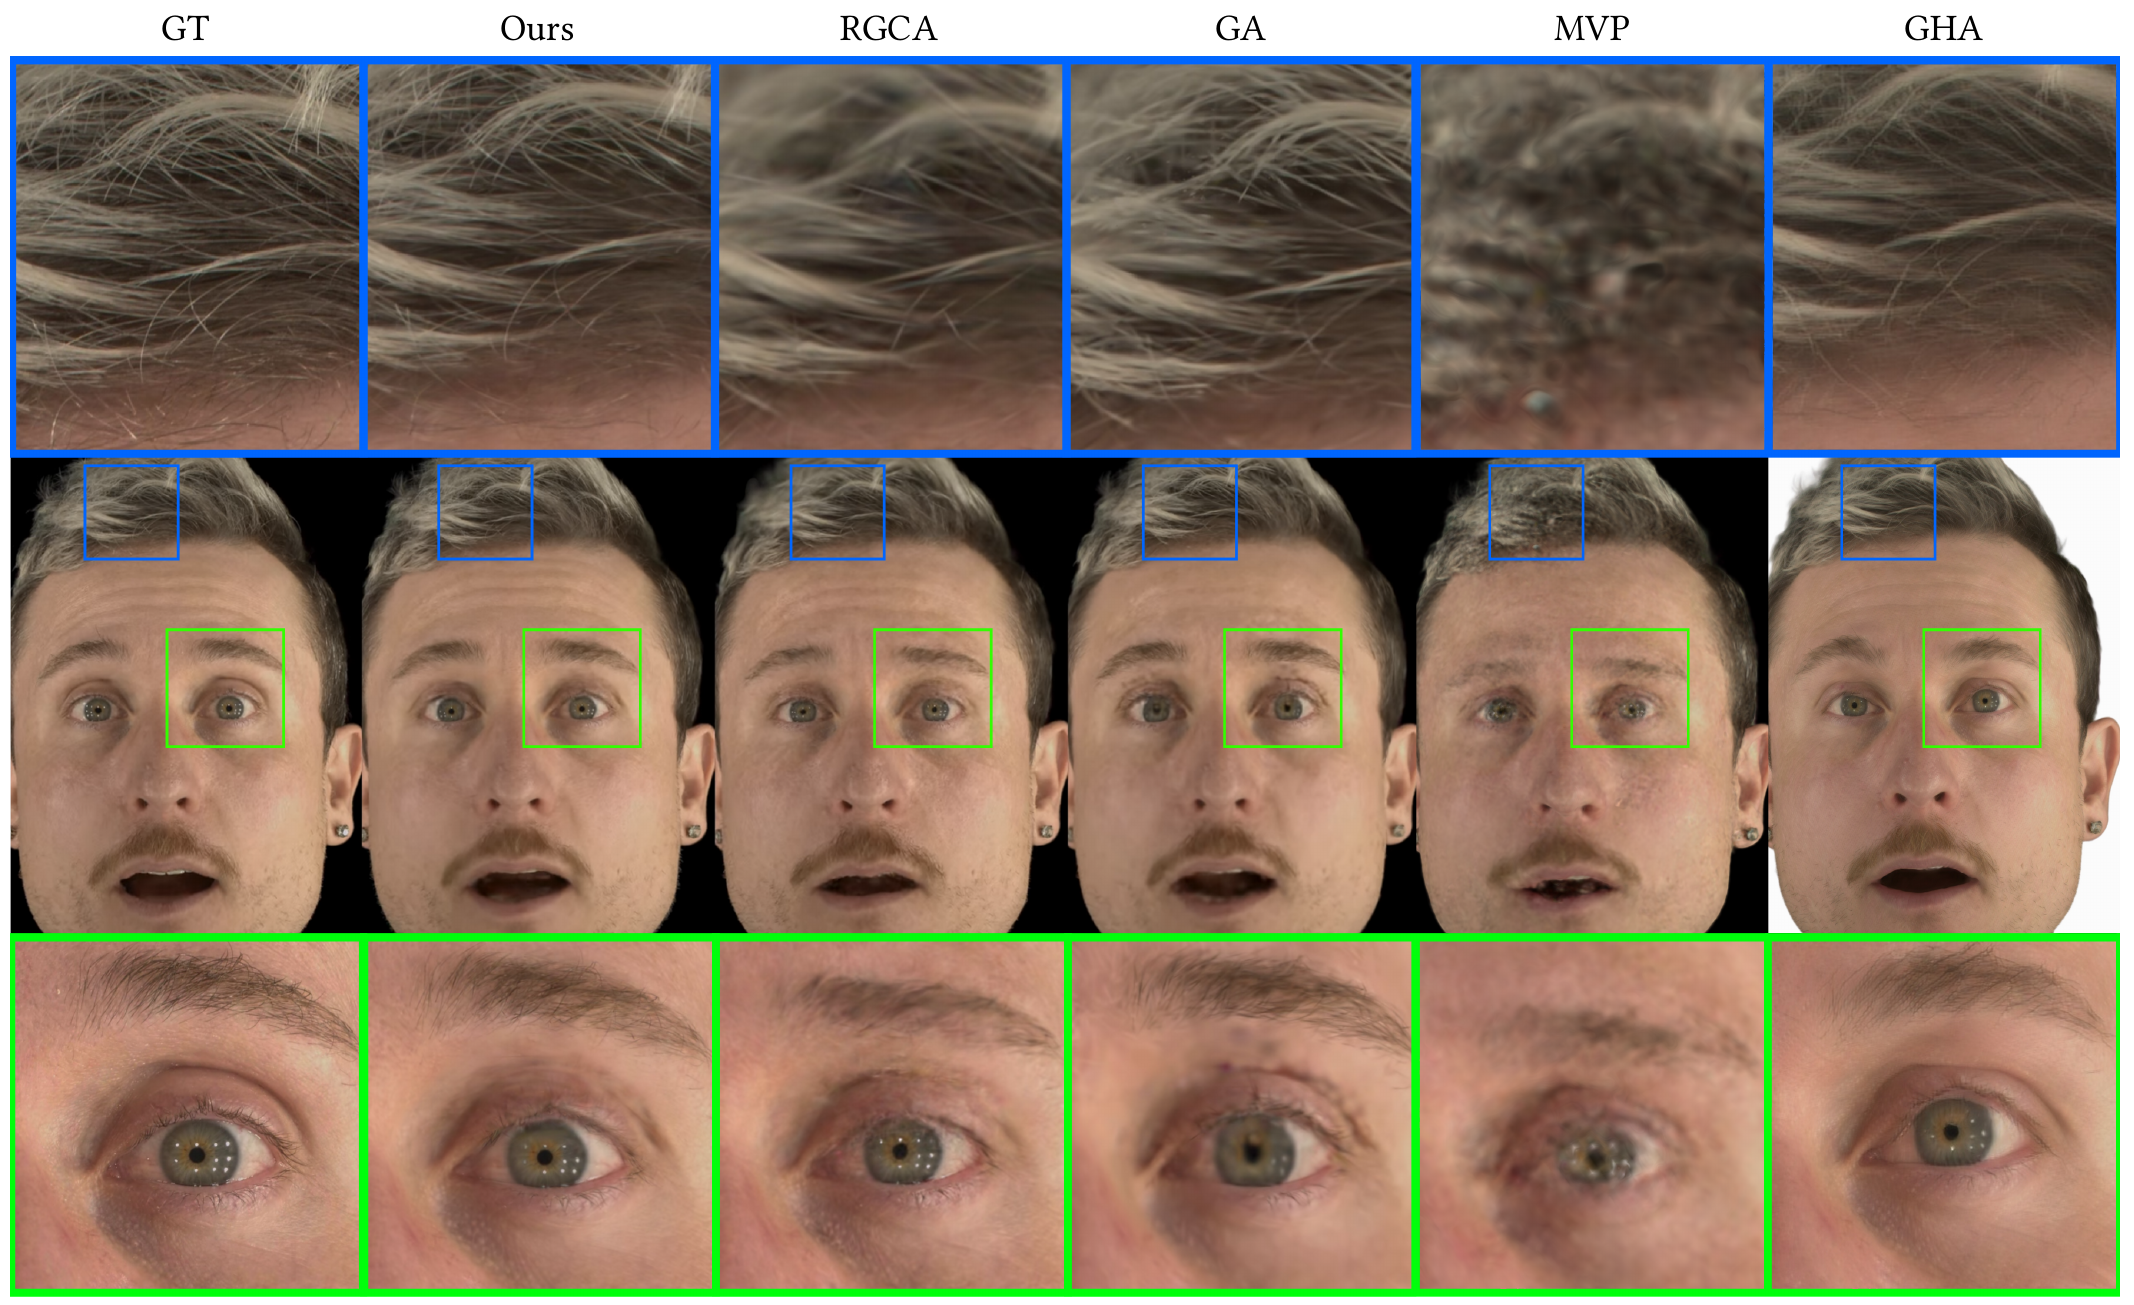
图4|各列依次为真实图像、TeGA、RGCA、GaussianAvatars、MVP和GHA。上方放大头发,下方放大眼部。来源:原论文图4。
观察这类结果,不能只挑一块更清晰的皮肤。先看嘴形、闭眼程度和眉毛位置是否对应目标,再看头发、眼周细节是否仍然清楚。
图4中,TeGA通过局部形变和加密,较好地保留了表情对应与局部细节。毛发尤其能暴露表示不足:如果高斯太少或运动对应不准确,细发容易被混成连续色块。
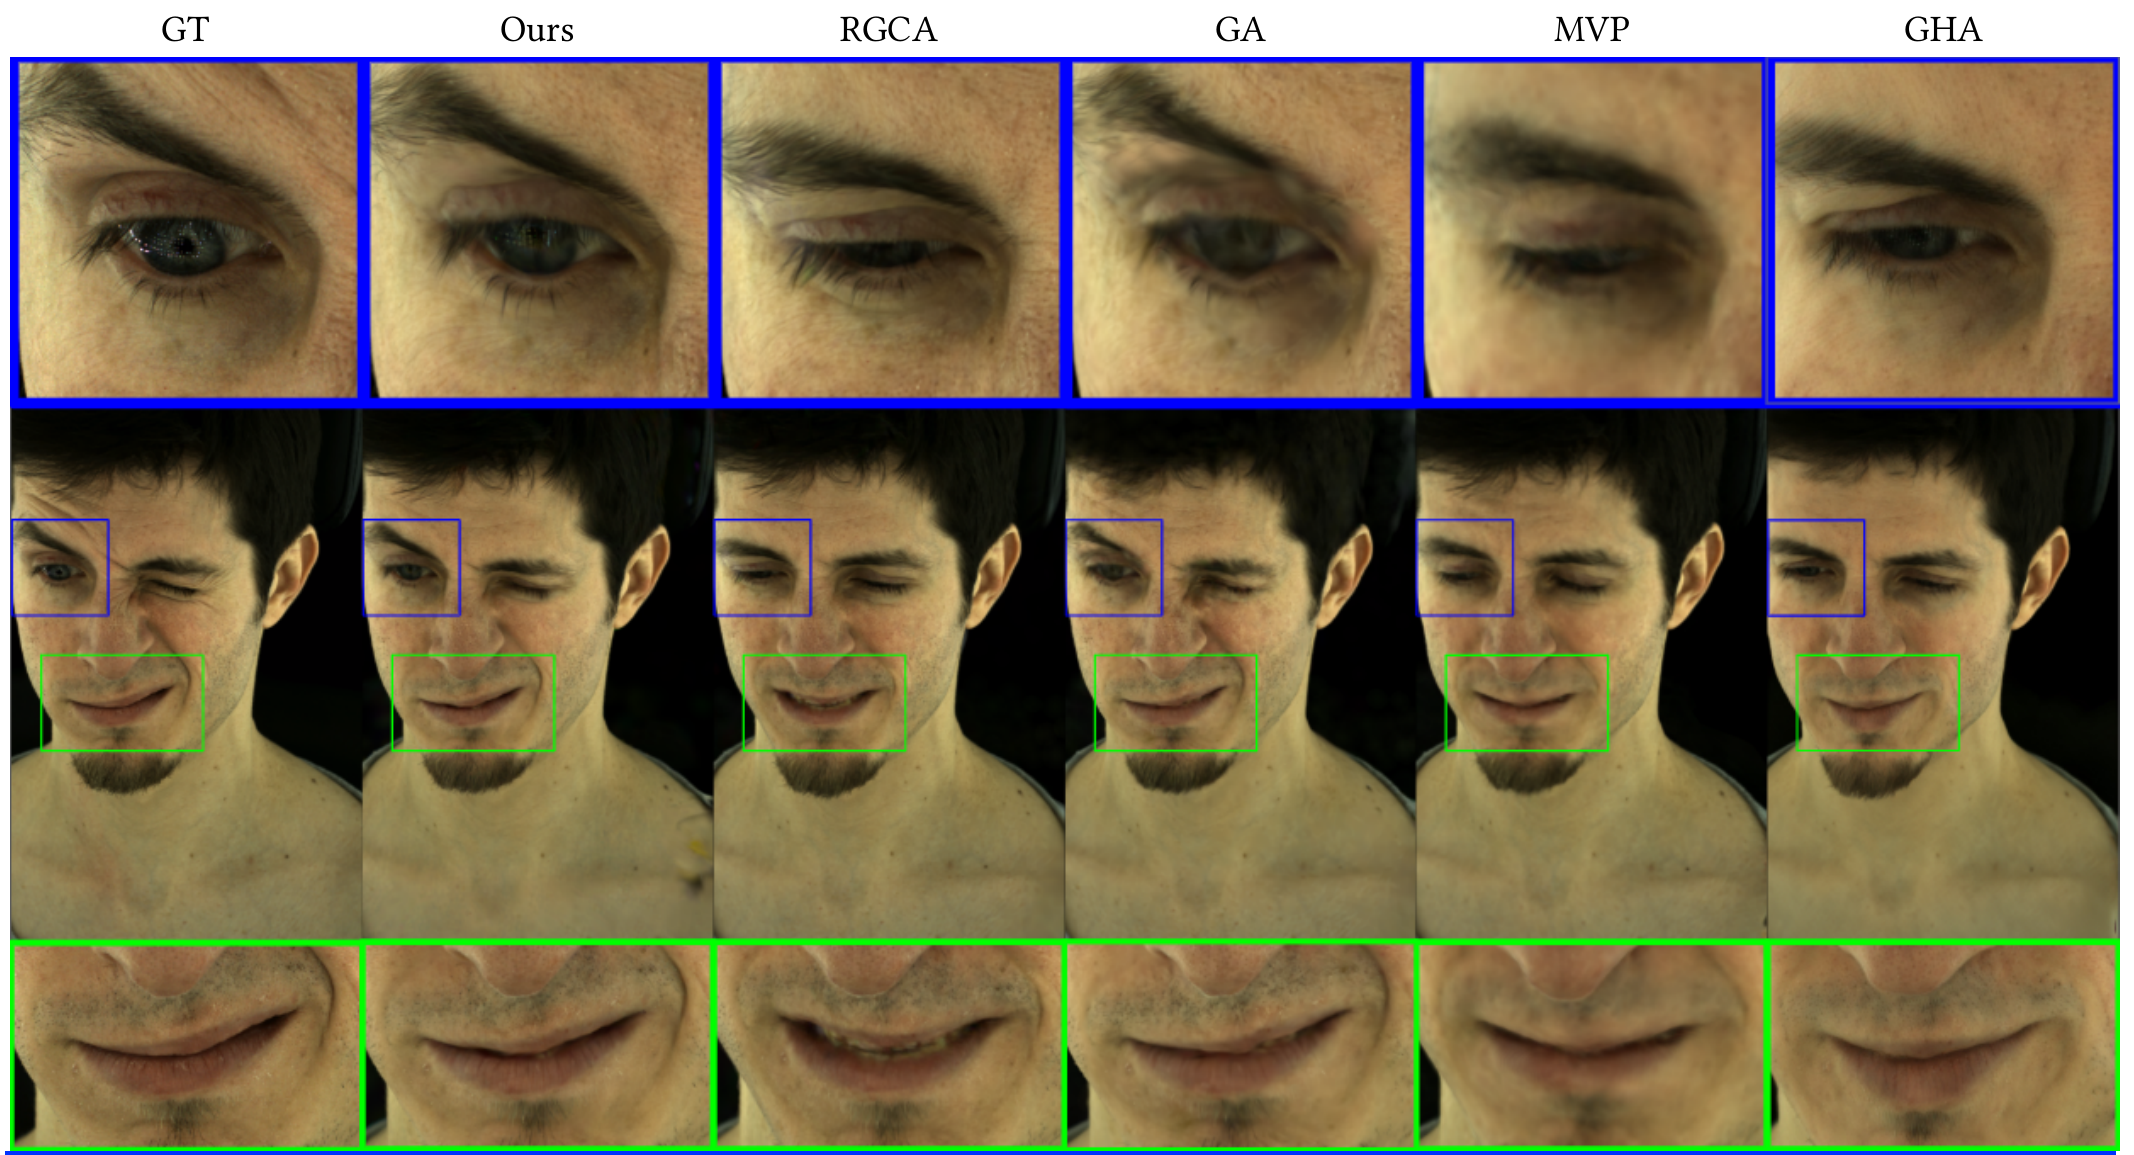
图8a|皱眉与嘴部运动的比较,列顺序为GT、TeGA、RGCA、GaussianAvatars、MVP、GHA。来源:原论文图8上半部。
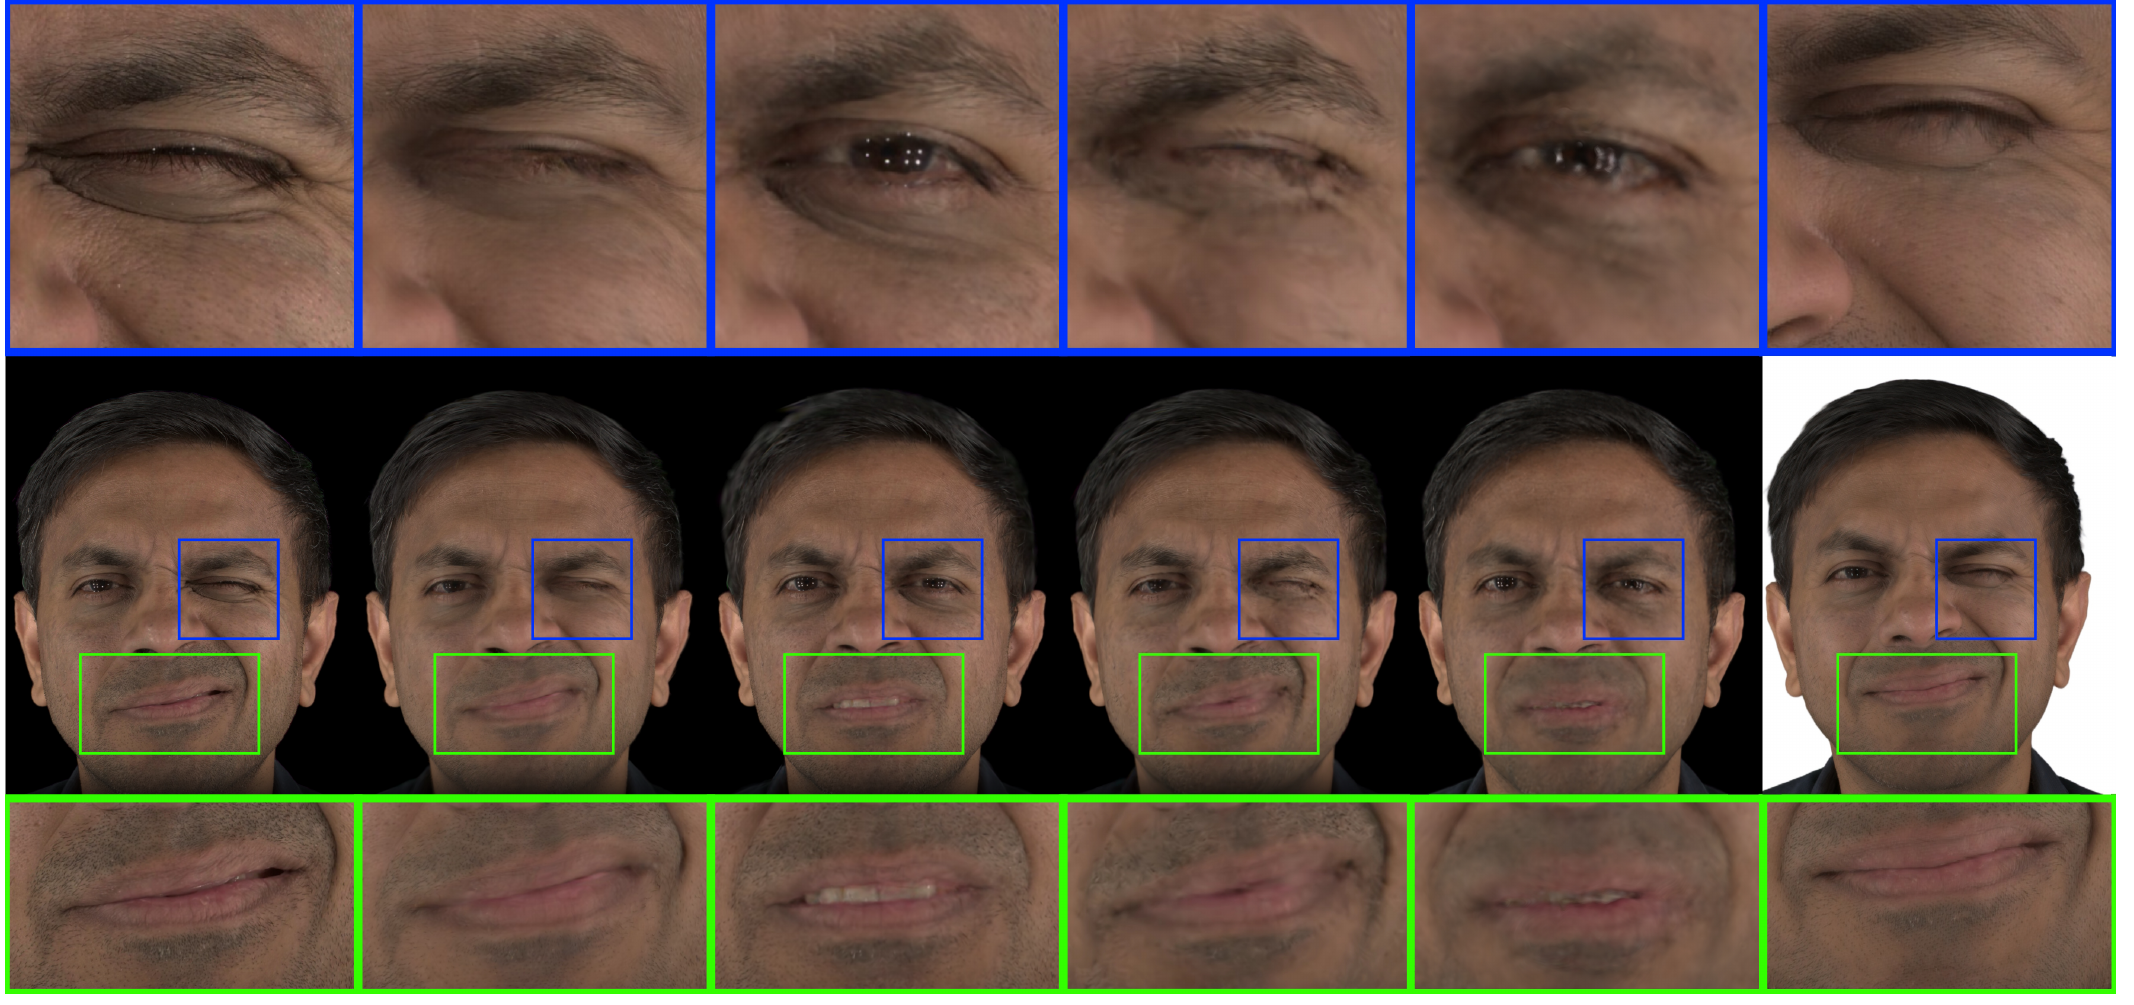
图8b|同样列顺序,比较闭眼和嘴部局部表现。来源:原论文图8下半部。
这些样例体现了细节与表情对齐的关联。一个方法可能保留粗脸型,却没有让眼睑准确闭合;另一个可能大致跟上表情,但局部皮肤变得模糊。TeGA希望同时减少这两类问题。
定量结果是否所有指标都最好?
下面选取原论文表1中的对比方法,保留指标均值。完整的均值与离散程度见附带原表图片。
| 方法 | 表情关键点误差↓ | 表情LPIPS↓ | 表情SSIM↑ | 表情PSNR↑ |
|---|---|---|---|---|
| GaussianAvatars | 71.7 | 0.249 | 0.773 | 24.1 |
| RGCA | 116.9 | 0.212 | 0.730 | 23.0 |
| GHA | 1421 | 0.229 | 0.669 | 15.5 |
| MVP | 208.0 | 0.268 | 0.748 | 23.1 |
| TeGA | 31.7 | 0.150 | 0.779 | 24.4 |
原论文表1中的完整方法与基线,均为作者自采数据的全头评价,仅展示均值。
在这组基线比较中,TeGA的表情对齐误差和LPIPS优势较明显。相对GaussianAvatars,关键点均方误差下降约55.8%,LPIPS下降约39.8%。两者计算都是以对应基线值为分母的相对下降,不是百分点变化。
| 方法 | 新视角LPIPS↓ | 新视角SSIM↑ | 新视角PSNR↑ |
|---|---|---|---|
| GaussianAvatars | 0.201 | 0.813 | 25.4 |
| RGCA | 0.177 | 0.823 | 24.4 |
| GHA | 0.180 | 0.725 | 17.1 |
| MVP | 0.226 | 0.800 | 26.0 |
| TeGA | 0.123 | 0.848 | 26.7 |
原论文表1的新视角基线比较,保留均值。
在这组基线中,TeGA的新视角三项指标最好。但把表1中的全部消融也包括进来,就不能写成TeGA包揽所有指标。比如“不更新三角形对应”一项的新视角PSNR为27.0、SSIM为0.853,均高于完整方法;不使用VGG损失时,部分PSNR与SSIM也更高。
感知细节、像素误差和结构指标并不总是同向变化。作者的优势更适合结合LPIPS、表情对齐与局部视觉质量理解,而不是把所有数字概括成同一个“精度”。
比较设置有哪些需要一起看?
RGCA本来面向可重光照建模,作者为固定照明数据替换了其与光照相关的球谐表述,改为视角相关球谐;输入也使用顶点偏移图,以适应数据条件。GaussianAvatars与TeGA使用相同几何。GHA则使用自己的关键点驱动处理流程,不能直接使用同一套替代几何。
因此,表格反映的是论文明确设置下的比较,其中既包含表示能力,也包含表情驱动和拟合条件的差异。尤其不能把GHA的误差差距全部归因于高斯表示本身。
十二、提升是否只是因为用了更多高斯?
作者还把TeGA限制在20万个高斯,与GaussianAvatars相近的规模进行比较。
| 方法 | 表情LPIPS↓ | 新视角LPIPS↓ | 关键点误差↓ |
|---|---|---|---|
| GaussianAvatars | 0.249 | 0.201 | 71.7 |
| TeGA,20万高斯上限 | 0.207 | 0.163 | 49.0 |
| TeGA,完整设置 | 0.150 | 0.123 | 31.7 |
选取原论文表1数据。20万设置为相近规模比较,不表示两个模型实际高斯数量在所有时刻完全一致。
即使预算接近,TeGA仍然改善了这几项指标,说明提升不只是来自高斯数量增加。完整设置进一步改善,则表明增加表示容量也确实有价值。
局部网络的选择也影响可用规模。作者将U-Net局部特征替换为单个全局表情编码,再由较深MLP预测形变;在同等GPU内存下,这个替代方案只能训练约150万个高斯。
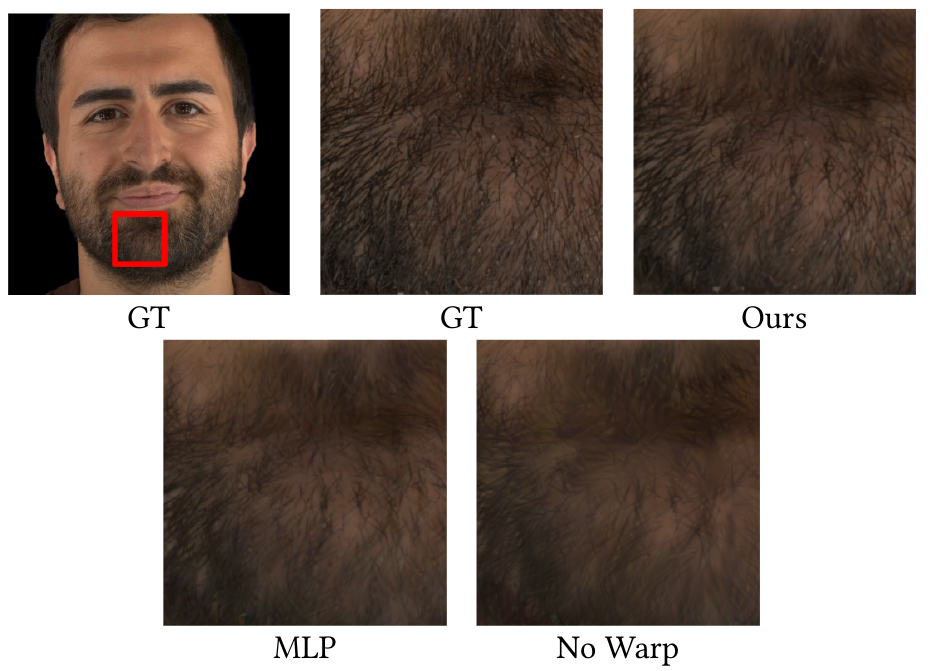
图5|比较真实局部、完整方法、全局编码驱动的MLP替代方案,以及不使用残差形变的结果。来源:原论文图5。
完整方案的胡须细节更清楚。但这项替代实验同时改变了条件特征组织、网络与可容纳高斯数量,因此支持的是整体方案的质量与成本优势,不能将全部差距单独归给“CNN一定优于MLP”。TeGA本身也使用小MLP完成逐点查询。
十三、消融实验把各部分的作用分开了吗?
| 设置 | 表情LPIPS↓ | 新视角LPIPS↓ | 表情PSNR↑ |
|---|---|---|---|
| 无残差形变 | 0.169 | 0.139 | 24.3 |
| 无动态明暗 | 0.155 | 0.128 | 24.0 |
| 两者都无 | 0.180 | 0.150 | 23.6 |
| 不加密 | 0.274 | 0.211 | 21.3 |
| 不使用VGG | 0.178 | 0.148 | 24.5 |
| 不更新三角形对应 | 0.153 | 0.123 | 24.3 |
| 完整方法 | 0.150 | 0.123 | 24.4 |
原论文表1的部分指标重排。保留相同的最小值,不将消融结果写成所有指标一致下降。
不加密时,LPIPS明显恶化,说明局部容量对高分辨率外观很重要。移除形变或明暗分支,都损失了部分感知质量;同时移除时更明显。
不更新三角形对应的平均LPIPS变化较小,但图6显示它会在特定眨眼姿态出现局部问题。局部伪影可能只影响少量像素,平均指标不一定敏感,因此需要图像与数值共同判断。
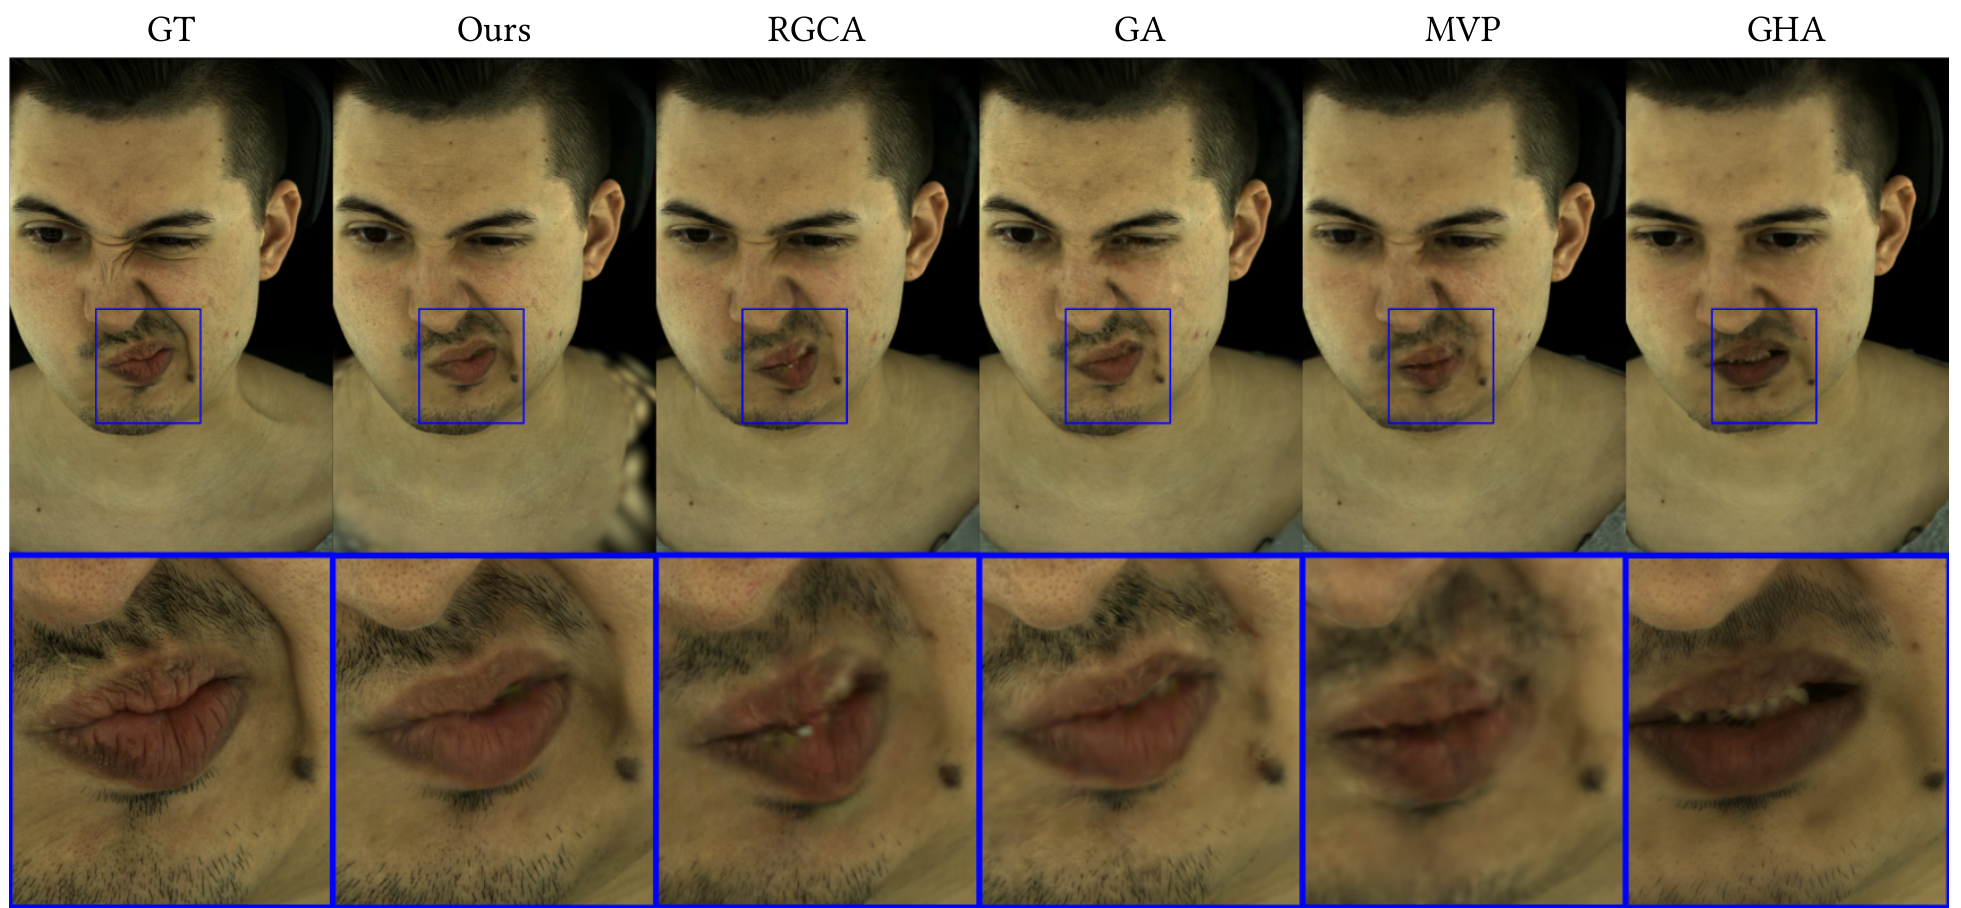
图9a|第一组胡茬区域,列顺序为GT、TeGA、RGCA、GaussianAvatars、MVP、GHA。来源:原论文图9上部。
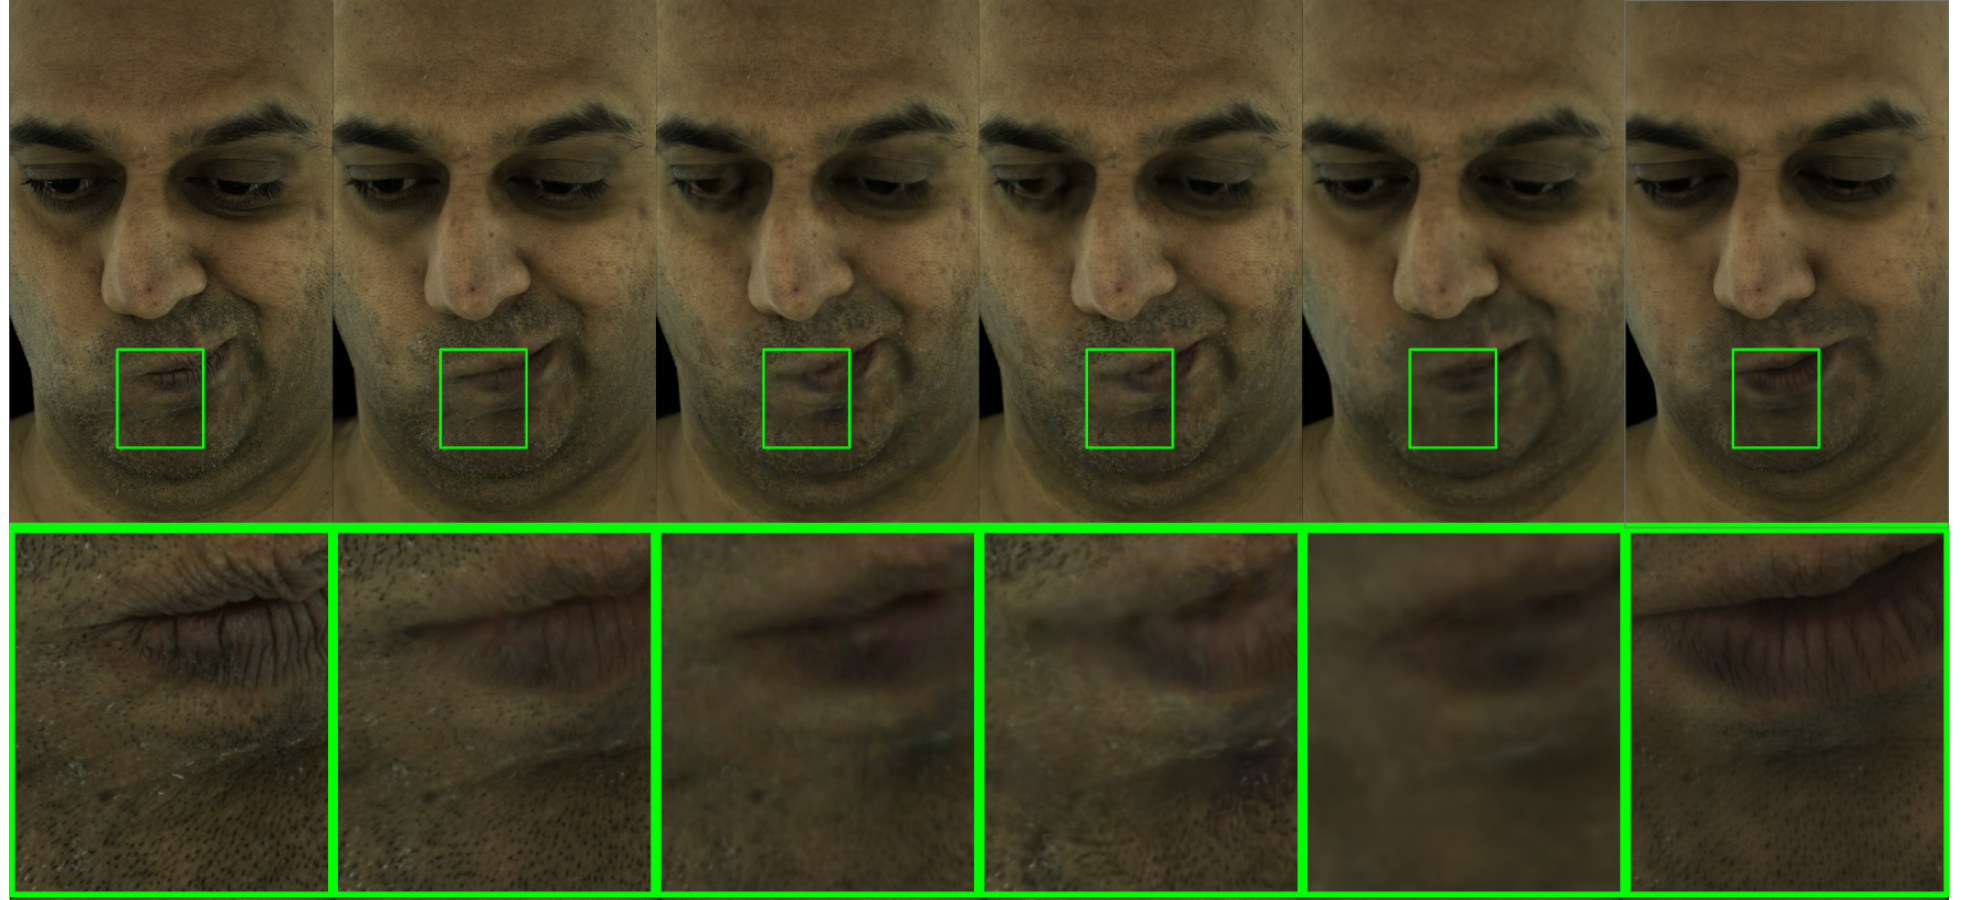
图9b|第二组嘴周局部,列顺序同上。来源:原论文图9中部。
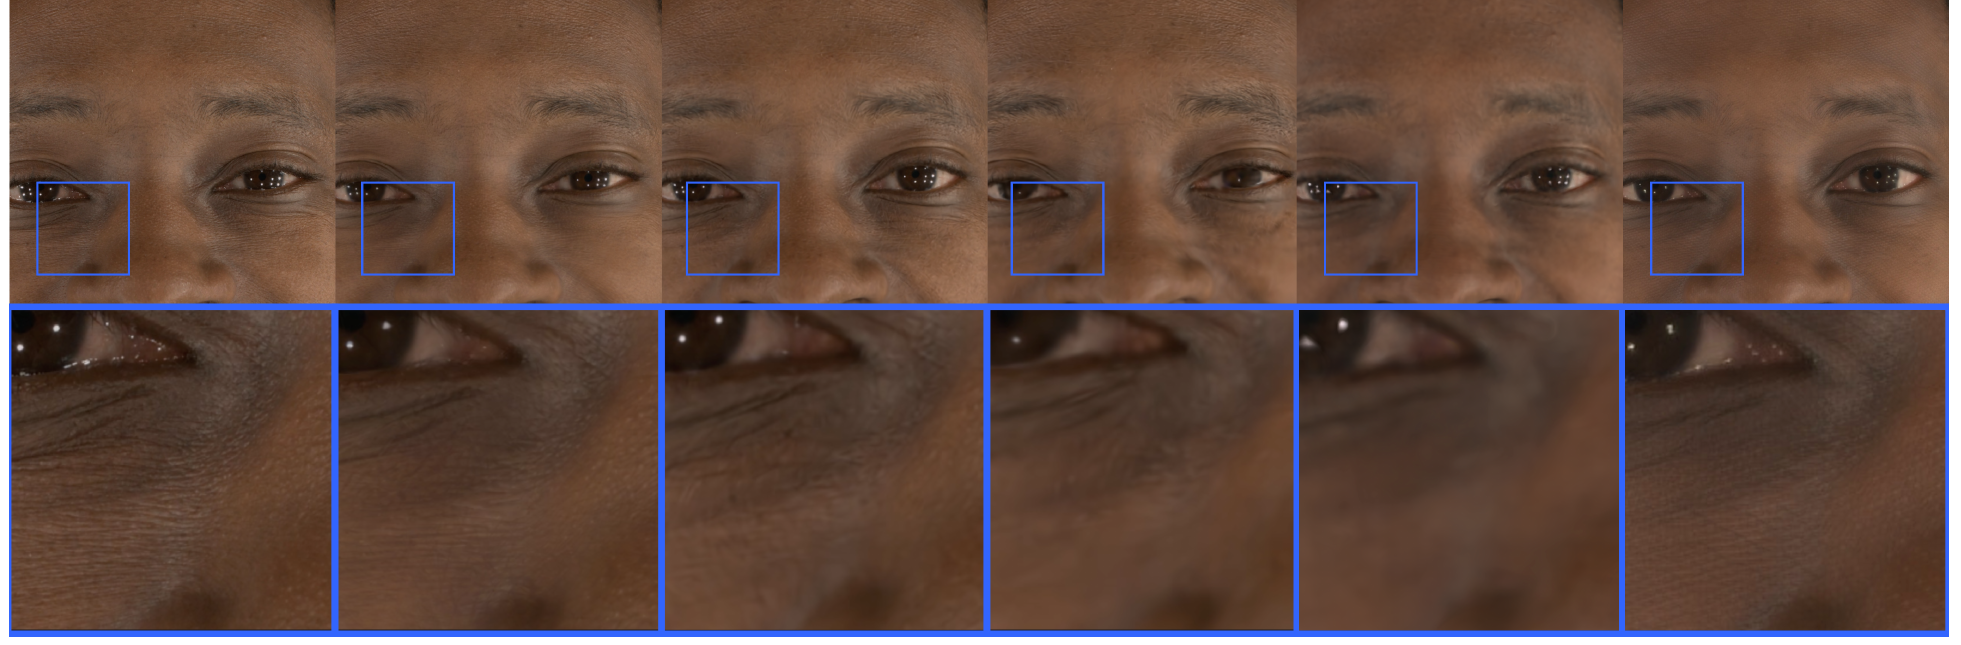
图9c|细小皮肤纹理的比较,列顺序同上。来源:原论文图9下部。
这些细节图说明了为什么论文同时关注动态形变和感知损失。能否重现粗表情,与能否在局部放大后保留皮肤、胡须的视觉层次,是两个相互关联但并不相同的要求。
十四、从高质量演示走向实际应用,还有哪些限制?
TeGA依赖已跟踪、具有对应关系的网格。牙齿、舌头和口腔内部本身较难跟踪,训练图像对这些位置的约束也较弱,因此仍可能出现细节缺失与伪影。
动态明暗与形变之间也存在歧义。一处皱纹的亮度变化,可能部分由几何解释,也可能被明暗分支吸收。论文明确承认两者可以互相补偿,因此高质量渲染不能单独证明每一处微观几何都被准确测量。
此外,单色明暗缩放不能表达完整的动态肤色变化;固定照明下学习的外观,也不等于完成了可重光照的材质分解。本文没有给出独立毛孔级表面真值距离,不能把近景细节直接改写成已验证的毛孔级几何精度。
计算成本同样需要保留。论文报告H100上约10至16小时的训练时间,并设400万高斯上限;本文正文没有报告明确的4K实时帧率,不能仅根据采用3DGS就补写实时性能。
十五、这篇论文对精细人脸建模的启发
TeGA把三类设计连在了一起:连续UVD为高斯提供能优化的表面地址,局部特征场让高斯数量与CNN输出分辨率分离,雅可比传播则让一个简单的位移场同时控制中心与形状。
其中,雅可比方法尤其值得借鉴。它让局部运动和高斯形状服从同一套空间变化,减少了分别预测平移、旋转、尺度时可能产生的不一致。配合自适应加密,模型才有机会在保持动态对应的同时增加细节。
若进一步用于偏振人脸重建,以下属于延伸思考:这种连续表面坐标与形变传播可以作为几何组织方式,但还需要额外研究偏振观测、法线与材质约束如何进入训练。TeGA验证的是动态外观建模,并没有直接验证偏振联合重建或真实毛孔深度恢复。
对这项工作的理解,可以落在一个具体问题上:高分辨率动态头部的清晰度,既取决于细节有多少,也取决于它们在运动中是否仍处于正确的位置。TeGA的贡献,是让表示容量、局部运动和外观变化能够更协调地工作。
