
 洗子
 匿名

用手机绕着脸拍一段视频,如今已经可以重建出相当像本人的模型。但把模型移到另一盏灯下,额头的高光、嘴唇的纹理和皮肤细小起伏,仍可能显得模糊或失真。
原因不只是照片拍得不够清楚。照片中的亮暗混合了肤色、表面反光、光照和局部朝向。专业采集系统用高质量相机、可控灯光和偏振片,获得更多彼此可区分的观测;普通手机视频缺少其中一部分信息,同一块亮斑就可能有多种解释。
这篇SIGGRAPH2025论文提出了一种补充信息的方式:先从专业扫描中学习“高质量皮肤材质通常怎样组合”,再用手机真实拍到的照片约束它,为当前人物恢复一套可以重打光的外观贴图。
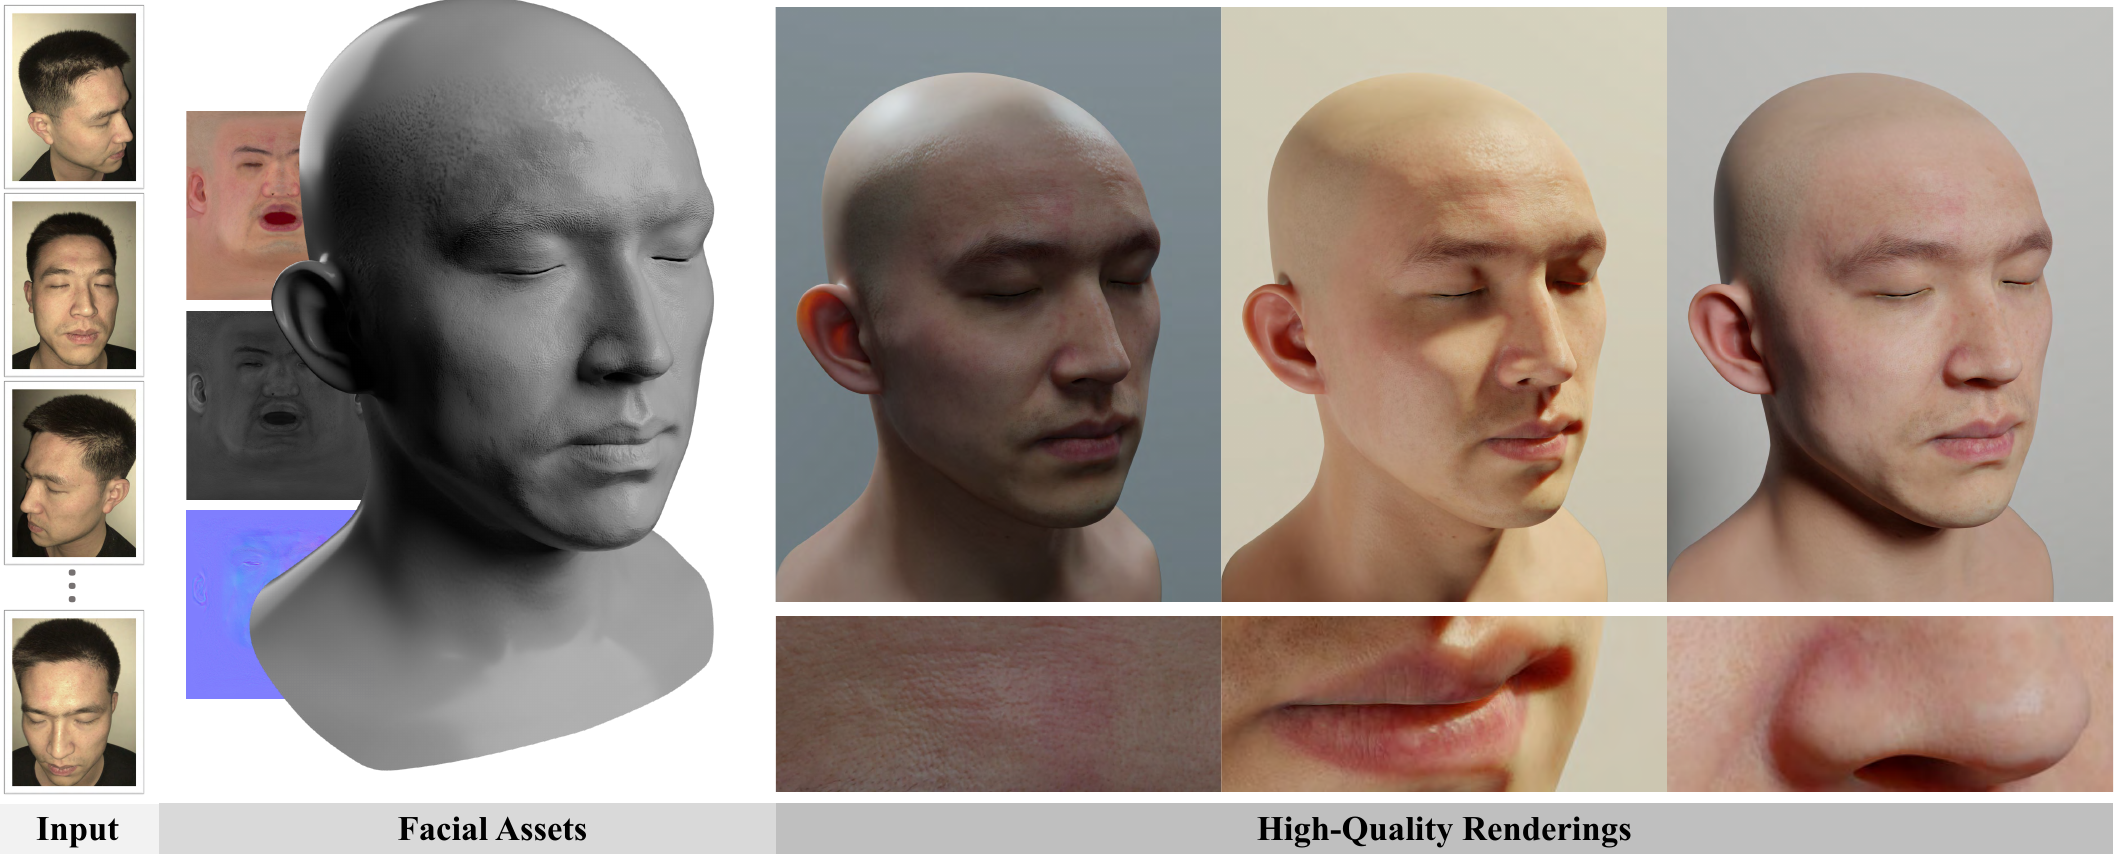
图1|输入为手机与闪光灯共位置的拍摄序列,输出包括基础几何和反射贴图,可导入Blender等引擎渲染。来源:原论文图1。
图中额头、嘴唇、鼻部的放大区域,是作者希望改善的细节。要看懂这项工作,需要同时理解两个条件:恢复结果应接近专业皮肤数据的分布,也应能解释这个人真实的手机照片。
论文信息
| 项目 | 内容 |
|---|---|
| 英文标题 | Facial Appearance Capture at Home with Patch-Level Reflectance Prior |
| 中文标题 | 利用局部反射先验在家采集人脸外观 |
| 发表 | SIGGRAPH 2025,Journal Track;ACM Transactions on Graphics 44(4) |
| 作者 | Yuxuan Han、Junfeng Lyu、Kuan Sheng、Minghao Que、Qixuan Zhang、Lan Xu、Feng Xu |
| 机构 | 清华大学、上海科技大学、Deemos Technology |
| 项目主页 | https://yxuhan.github.io/DoRA/index.html |
| 论文 | https://arxiv.org/abs/2506.03478 |
| DOI | https://doi.org/10.1145/3730825 |
| 官方仓库 | https://github.com/yxuhan/DoRA |
| 资源状态 | 本次核对时,仓库主要提供说明与素材,README仍列出完整逆渲染代码和先验模型的发布计划 |
| 关键词 | 手机人脸采集、反射先验、扩散后验采样、UV条件、重叠分块、可重打光资产 |
一、先把手机能测到的部分做好
论文的采集方式沿用CoRA:在较暗的房间中,打开手机闪光灯,绕人物拍摄一段视频。手机摄像头与闪光灯距离很近,模型把它们近似为同一位置。
这样做有两个好处。小型闪光灯提供较集中的方向性光照,能够显露局部反射变化;光与相机共位置,也减少了相机可见区域里由主光源造成的明显投影阴影,简化求解。实际仍可能有遮挡和环境光,方法用另外的低频项解释环境照明。
拍摄通常约30秒,人物需要尽量保持不动。多视角来自手机在不同时间绕拍,因而轻微呼吸、吞咽或表情变化仍可能造成不对齐。
整个流程分成两个阶段。
先用CoRA恢复几何与光照,再固定这些结果,利用扩散先验重新估计反射贴图。
具体来说,作者先用MetaShape标定相机,运行CoRA得到几何、外观与照明。随后保留几何和照明,舍弃其外观结果,并用Wrap将ICT人脸模板注册到重建形状上。
这一步的意义在于建立统一UV坐标。同一组坐标在训练扫描和新人物上,都应对应相同的大致面部区域,否则从专业数据学到的嘴唇先验,就无法稳定用于新人物的嘴唇。
本文的主要改进发生在反射贴图阶段。细节法线会改变渲染,但基础网格在该阶段保持固定,不能把法线上的细纹直接等同为新恢复了同等精度的几何起伏。
二、48张专业扫描,怎样训练一个皮肤先验?
直接训练一个生成完整4K人脸材质的模型,面临两个困难:高分辨率带来显存压力,而专业扫描数量又少。
作者购买了48份Light Stage扫描,统一到ICT拓扑和4K贴图。每份包含RGB漫反射反照率、单通道镜面反照率,以及三通道法线。模型要学习的是这几种属性的联合关系,例如一块嘴唇的颜色、反光和细纹方向应该怎样相互配合。
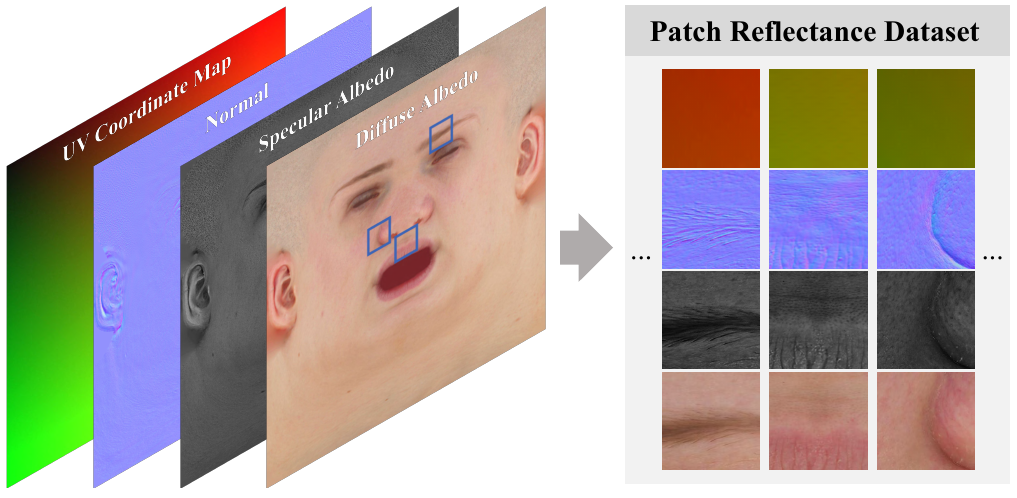
图2|从统一UV贴图中同时裁切反照率、镜面反照率、法线与UV坐标,构成局部训练样本。来源:原论文图2。
作者把三类反射属性与UV坐标沿通道拼接:
| 内容 | 通道数 | 作用 |
|---|---|---|
| 漫反射反照率 | 3 | 描述底层RGB颜色 |
| 镜面反照率 | 1 | 描述局部镜面反射强度 |
| 法线 | 3 | 描述局部表面朝向 |
| UV坐标 | 2 | 告诉模型这块来自脸的哪里 |
前7个通道是要生成的内容,后2个通道是位置条件。训练时联合裁切256×256的小块,得到10000组样本。10000是局部裁切样本数,原始人物扫描仍为48份。
局部训练降低了分辨率和样本稀缺带来的难度,但也丢掉了整张脸的上下文。同样一块深色区域,位于眉毛还是嘴唇,合理的法线与镜面结构可能完全不同。UV条件因此很重要:它给每块皮肤一个位置提示。
作者还对UV坐标做位置编码,再将编码结果拼接到去噪网络输入。低频坐标由此变成更有区分度的特征,帮助网络分辨相近位置。
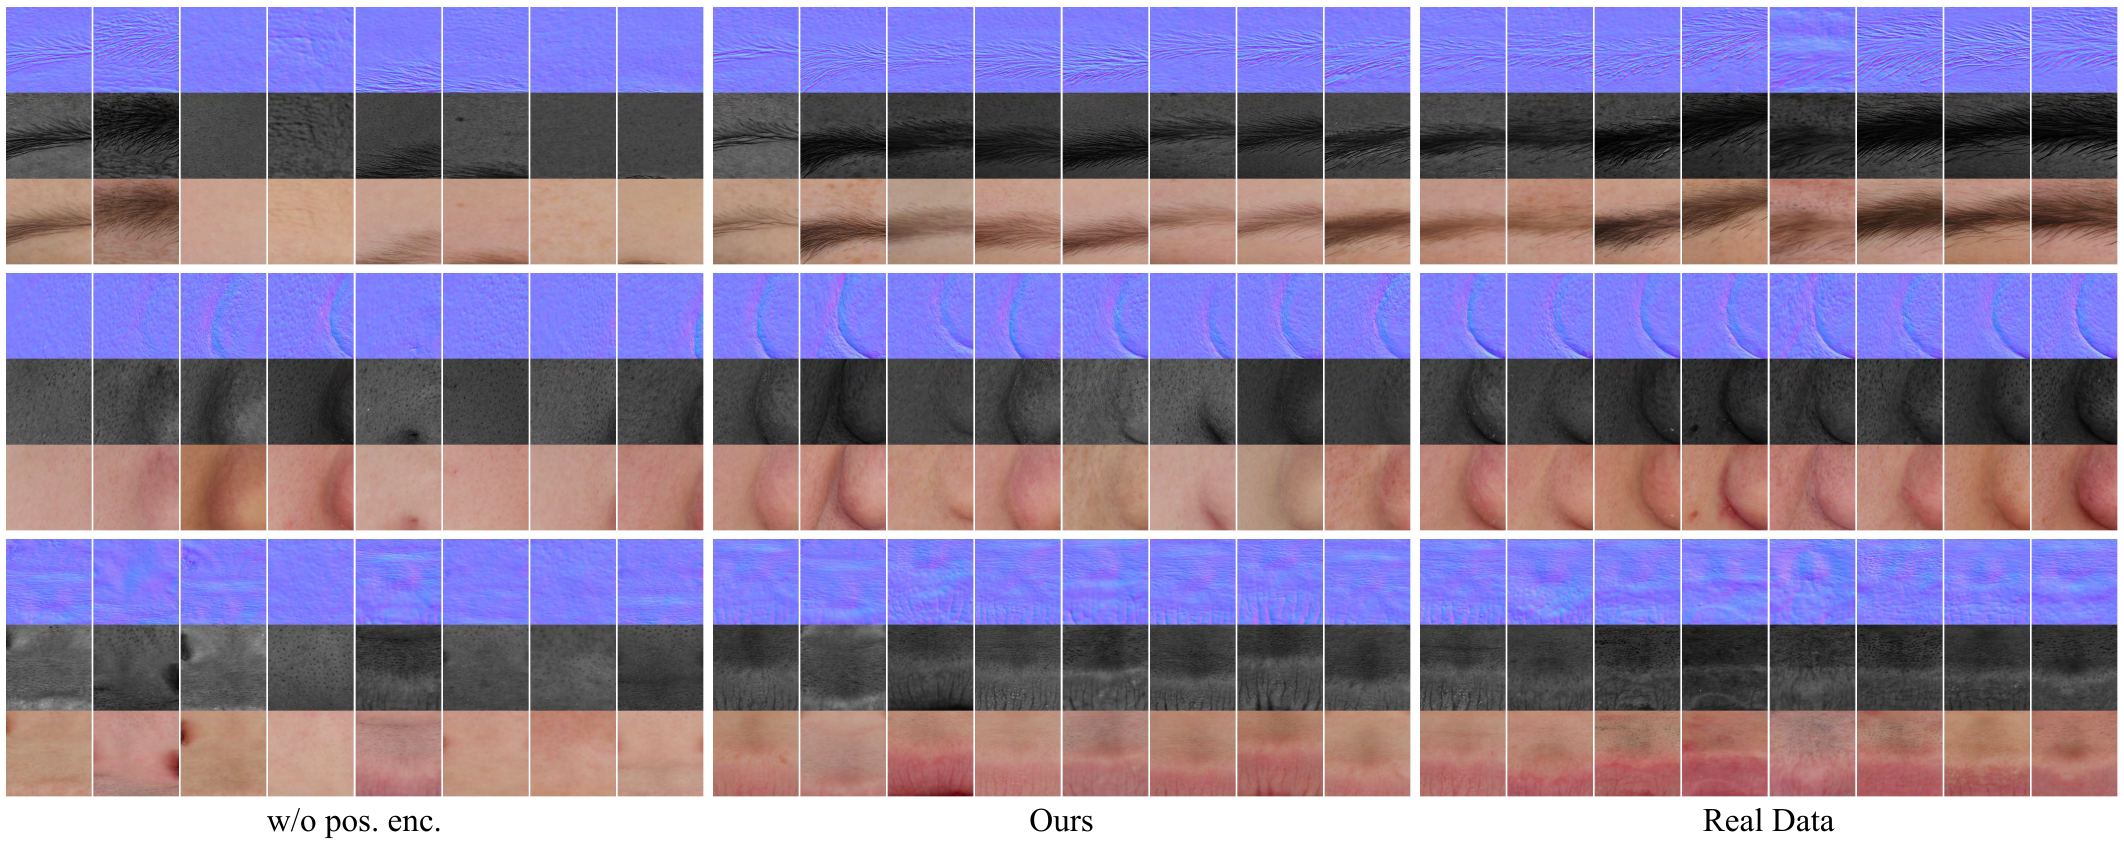
图11|眉毛、鼻部、嘴唇三个位置的随机生成样本;从左到右为无位置编码、完整方法和真实训练裁块。每个位置均展示法线、镜面与漫反射属性。来源:原论文图11。
这里展示的是按位置生成局部材质的能力。它说明先验能区分面部区域,尚未说明某一块随机生成的细纹就属于待采集人物;人物照片的约束将在后面加入。
三、扩散模型学到的,到底是什么?
扩散训练把真实材质逐步加噪,再训练网络去预测噪声。用$x_0$表示一块干净的七通道反射数据,原论文式(2)给出任意时间步的加噪分布:
$$ q(x_t\mid x_0)=\mathcal N \left(x_t;\sqrt{\bar\alpha_t}x_0,(1-\bar\alpha_t)\mathbf{ I }\right). \tag{2} $$
$\bar\alpha_t$由噪声日程决定。这个式子等价于从标准高斯噪声$\epsilon$构造:
$$ x_t=\sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\epsilon. $$
这是对原式的重参数化解释。时间步越往后,真实材质的成分越少,噪声越多。
训练好的网络$\epsilon_\theta(x_t,t\mid y)$根据带噪样本、时间步和UV条件$y$预测噪声。原论文式(6)用它估计干净材质:
$$ \hat x_t=\frac{1}{\sqrt{\bar\alpha_t}} \left(x_t-\sqrt{1-\bar\alpha_t}\epsilon_\theta(x_t,t\mid y)\right). \tag{6} $$
理解这个式子只需要把前面的加噪关系倒过来:从当前样本中减去预测噪声,再除以真实信号的缩放系数,就得到对干净材质的估计。
论文采用EDM架构训练扩散先验,从零训练256×256分辨率的去噪网络。生成内容是七通道联合材质,UV负责条件控制。主文用上述扩散公式解释过程,实际重建采用确定性的DDIM采样,减少额外随机噪声带来的不一致。
一旦训练完成,先验网络固定。采集新人物时,系统调整的是当前采样中的反射贴图,而不是为每个人重新训练这套扩散网络。
四、让先验认识“这个人”,需要把它渲染回照片
单靠先验,模型可以生成合理的皮肤,却不一定保留当前人物的痣、唇纹或肤色分布。作者需要一项照片误差,让生成结果受到实际观测的牵引。
先看成像模型。原论文式(7)把颜色分成闪光灯与环境光:
$$ l_o=l_{flash}+l_{amb}. \tag{7} $$
闪光灯项为:
$$ l_{flash}=\frac{L}{\|\mathbf{ x }-\mathbf{ o }\|_2^2} f_{pbr}(\mathbf{ l },\mathbf{ v },\mathbf{ n },c,s,\rho) \max(\mathbf{ n }\cdot\mathbf{ v },0). \tag{8} $$
$\mathbf{ x }$是皮肤上的位置,$\mathbf{ o }$是相机与近似共位置光源的位置。距离平方分母表示点光源衰减;$f_{pbr}$是Disney BRDF,输入法线、观察与照明方向,以及漫反射反照率$c$、镜面反照率$s$、粗糙度$\rho$。
因为光源与相机共位置,$\mathbf{ l }=\mathbf{ v }$,所以接收光照的余弦项写成法线与观察方向的点积。环境项则由0—2阶球谐系数描述,并经过SoftPlus保证非负:
$$ l_{amb}=c\cdot\operatorname{SoftPlus} \left(\sum_{l=0}^{2}\sum_{m=-l}^{l}K_{lm}Y_{lm}(\mathbf{ n })\right). \tag{9} $$
这里的球谐用于近似低频环境照明对漫反射的影响,不是一个能准确模拟所有复杂室内光传输的完整环境模型。
在固定几何与照明之后,给定反射贴图$x$和视角$i$,可微渲染器$\mathcal R$可以预测图像。原论文式(12)为:
$$ \mathcal L_{pho}(x)=\sum_{i=1}^{V} \|\mathcal R(x,i)-I_i\|_2^2. \tag{12} $$
它累加预测图像与真实照片的颜色差异。重建从视频中均匀选取20个视角,图像缩放为960×720。输出材质是4K,输入照片仍然有限,先验正是用来约束这种欠定问题。
粗糙度贴图在本阶段固定,因为训练扫描中没有粗糙度先验。系统重新估计的是漫反射反照率、镜面反照率和法线,而非全部BRDF参数。
五、去噪之后再纠偏:后验采样怎样把两种要求接起来?
可以用贝叶斯关系理解这种思路:结果既应符合专业材质的先验,也应让观测照片在渲染后得到较好的解释。这是理解DPS的背景,不代表论文能精确计算或采样复杂反射参数的完整真实后验。
原论文式(10)先进行条件去噪,产生候选$x'_{t-1}$:
$$ x'_{t-1}=\frac{1}{\sqrt{\alpha_t}} \left[x_t-\frac{1-\alpha_t}{\sqrt{1-\bar\alpha_t}} \epsilon_\theta(x_t,t\mid y)\right]+\sigma_t z. \tag{10} $$
随后,用照片误差调整这一步的结果:
$$ x_{t-1}=x'_{t-1}-\zeta_t\nabla_{x_t}\mathcal L_{pho}(\hat x_t). \tag{11} $$
这两行连起来,就是先沿学到的皮肤分布去噪,再根据当前人物的照片作修正。式(10)是主文的通用采样表达,实际实现使用前述确定性采样策略。
式(11)里,渲染的是干净估计$\hat x_t$,而不是直接把满是噪声的$x_t$当成材质。梯度再通过“干净材质估计由当前噪声状态计算得到”的关系,传回$x_t$。
从链式法则看,照片差异先说明材质应该怎样改变,可微渲染把这个改变传到反照率和法线,再经过去噪网络对应的估计关系,决定当前采样状态如何修正。这是对原式的补充解释。
$\zeta_t$控制照片约束的力度。太小,结果容易偏向先验里常见的皮肤;太大,结果会更努力地匹配手机照片,也可能把照片噪声或模型误差吸收到法线细节中。
六、只训练小块,怎样恢复一整张没有接缝的脸?
如果把一个256分辨率训练出的UNet直接用于4K,显存消耗仍然很高。作者报告,在相应设置下,80GB A800也只能处理到约1536×1536。
把4K贴图切开分别采样,显存问题会缓解,但新的问题出现了:相邻两块可能分别找到不同的反射解释。一块把亮度归因于肤色,另一块把它归因于高光;边界处就会出现接缝。
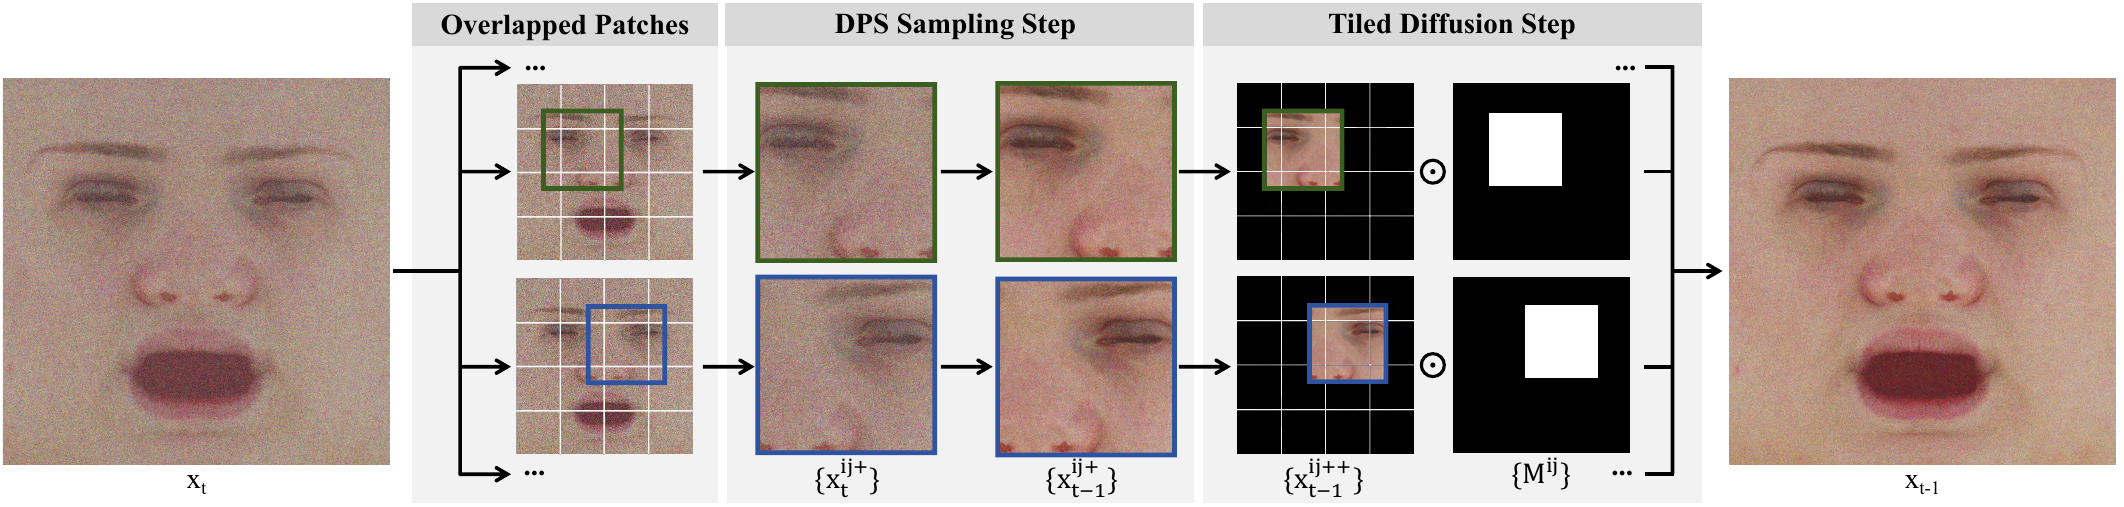
图3|每一步把当前整图切成重叠区域,分别做DPS更新,再通过Tiled Diffusion融合,形成下一时间步的整图。来源:原论文图3。
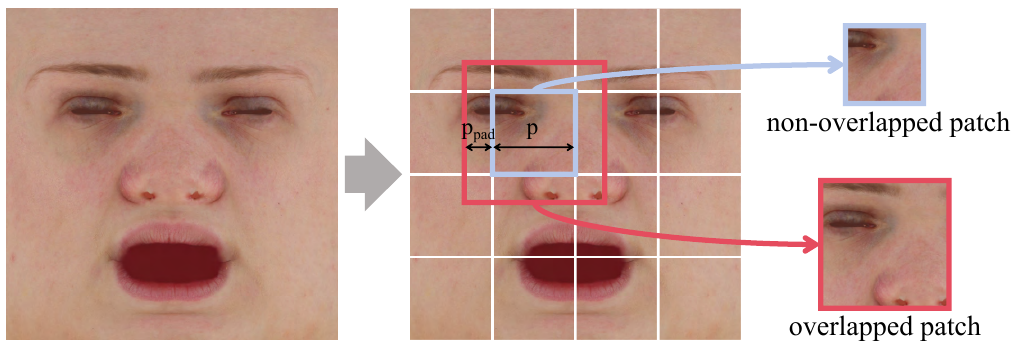
图4|先划分边长为$p$的区域,再向外扩展$p_{pad}$像素,得到带重叠的实际采样块。来源:原论文图4。
作者让相邻块在去噪过程中持续交流。每个时间步都重新从同一张全局状态裁切,独立更新,然后把重叠部分平均回一张整图。下一步再从融合后的整图开始。
原论文式(14)为:
$$ x_{t-1}=\frac{\sum_{i,j}x_{t-1}^{ij++}\cdot M^{ij}} {\sum_{i,j}M^{ij}}. \tag{14} $$
$x_{t-1}^{ij++}$表示将某个更新后的局部块放回整图坐标后的结果,$M^{ij}$是它覆盖区域的二值掩码,乘法和除法逐位置进行。
例如某个位置同时被两个块覆盖,分子把两者预测相加,分母为2,于是取平均;只被一个块覆盖,就保留该块结果。反复融合能在采样中约束相邻块,而不是等所有块各自生成完成后才修补边缘。
实际设置为$p=448$、$p_{pad}=64$,因此每块送入网络的尺寸为576×576。训练小块为256×256、重建时采用576×576,这两个分辨率承担不同角色。
七、固定几何,也让局部渲染更省计算
DPS需要不断把局部反射贴图渲染回屏幕,才能计算照片梯度。直接把每块补成4K再渲染,会在大量无用区域浪费计算。
作者利用几何固定这一条件,先把UV坐标光栅化到各个相机图像上,得到“屏幕像素对应哪个UV位置”的映射。对于某一块材质,只需调整这组UV坐标的平移与尺度,就能从局部块采样正确颜色,不必每次先补出完整贴图。
这一优化发生在渲染计算上。局部先验降低去噪网络的显存需求,UV映射复用则减少重复渲染开销,二者共同支持高分辨率求解。
但它仍然很慢:先验训练使用8张48GB L20,约24小时;新人物的几何与照明恢复在一张24GB RTX4090上约60分钟,随后1000步反射采样约8小时。“在家采集”降低的是拍摄门槛,离线处理仍需要较多计算。
八、结果改善在哪里,又有哪些指标没有改善?
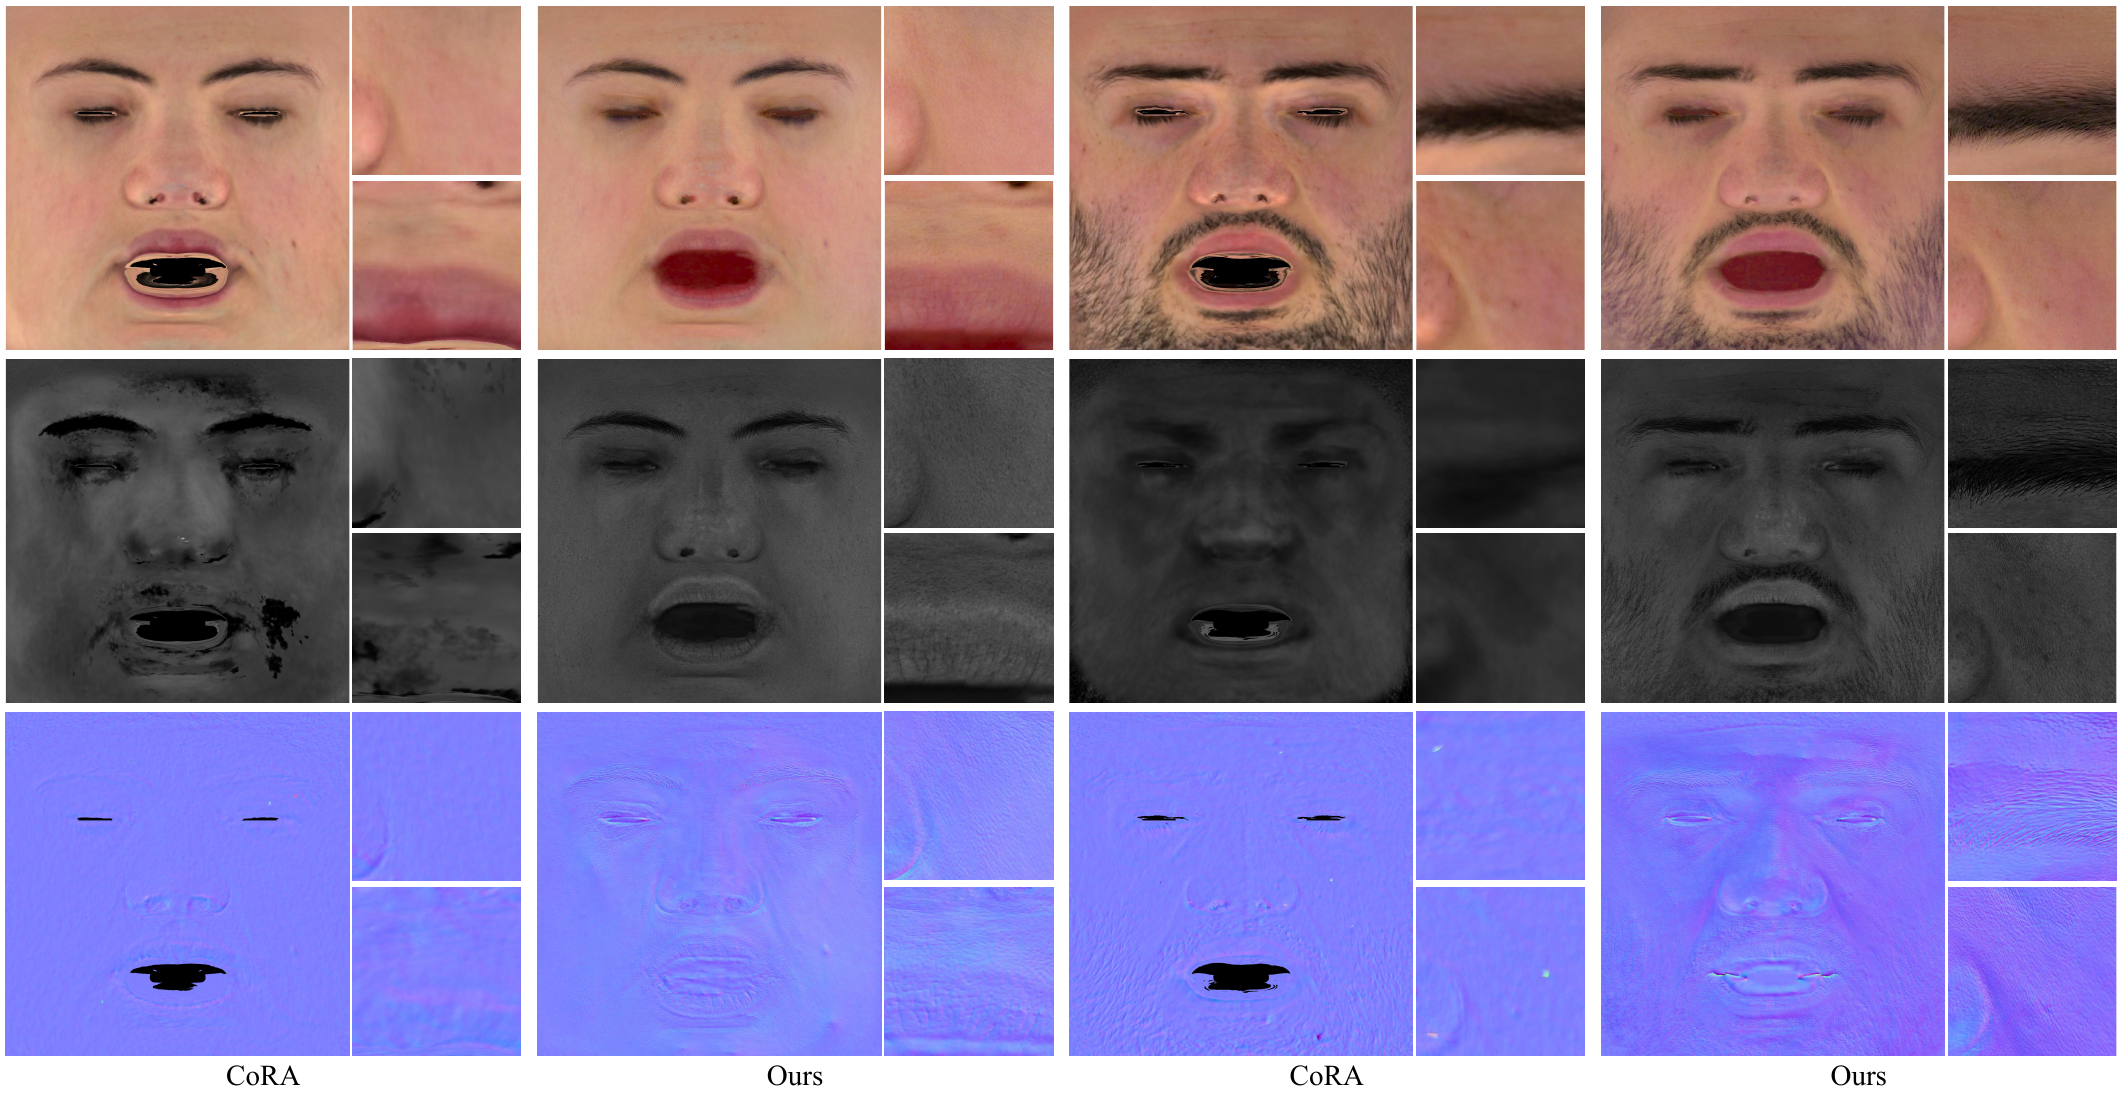
图5|两组人物的反射贴图,从上到下为漫反射反照率、镜面反照率和法线;各组左为CoRA,右为本文。来源:原论文图5。
图5可以先看眉毛和嘴唇局部。CoRA的镜面图较模糊,细节法线中也容易出现异常纹理;加入联合先验后,镜面与法线结构更加完整。作者为便于比较,把CoRA结果烘焙到同一网格上。
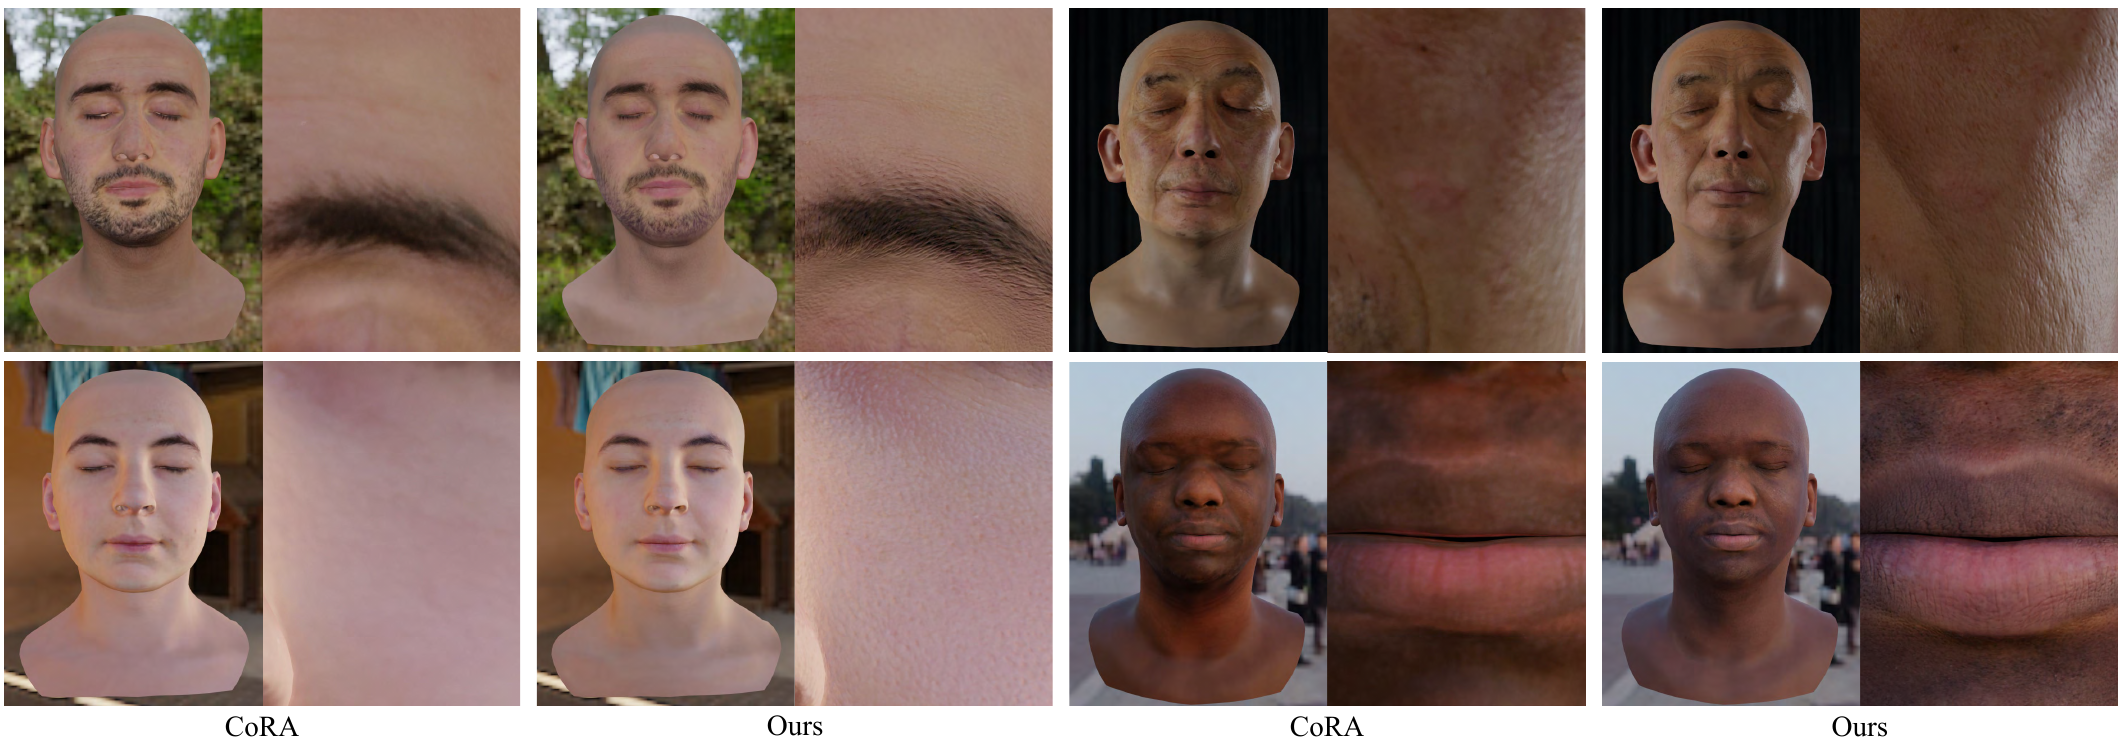
图6|不同环境光下的重打光,展示面部整体与局部细节。来源:原论文图6。
新的光照能帮助观察材质分解是否有用。若一个高光已经被写进反照率,它就可能在新光源下仍停在原位。图6展示了更细致的重打光效果;这些环境示例是渲染结果,不能当成每一种环境都有同条件真人实拍真值。
照片拟合方面,论文在8位人物的留出视角上报告PSNR、SSIM与LPIPS,仅计算面部皮肤区域。
| 方法 | PSNR ↑ | SSIM ↑ | LPIPS ↓ |
|---|---|---|---|
| CoRA | 33.22 | 0.9595 | 0.0653 |
| 本文 | 33.59 | 0.9517 | 0.0631 |
据原论文表1的平均行整理,PSNR单位为dB。
平均PSNR提高0.37 dB,LPIPS降低0.0022,但SSIM下降0.0078。逐人物看也并非全部改善:表中的African M样本PSNR从34.28降到32.81;Cau. M样本LPIPS从0.0552升到0.0589。
这说明本文在更强先验约束下,照片拟合整体仍有竞争力,同时改善了许多可视细节;不能把它总结为所有指标、所有人物都更好。这些指标评价的是渲染图像,也不直接测量材质参数或皮肤几何的绝对准确性。
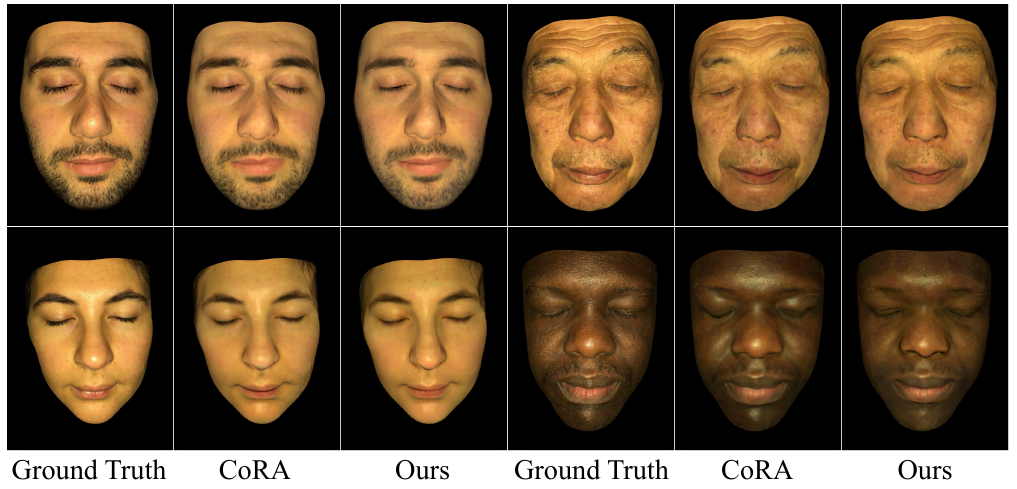
图7|真人参考、CoRA与本文渲染对比。来源:原论文图7。
九、接近专业扫描,比较的是哪一种专业系统?
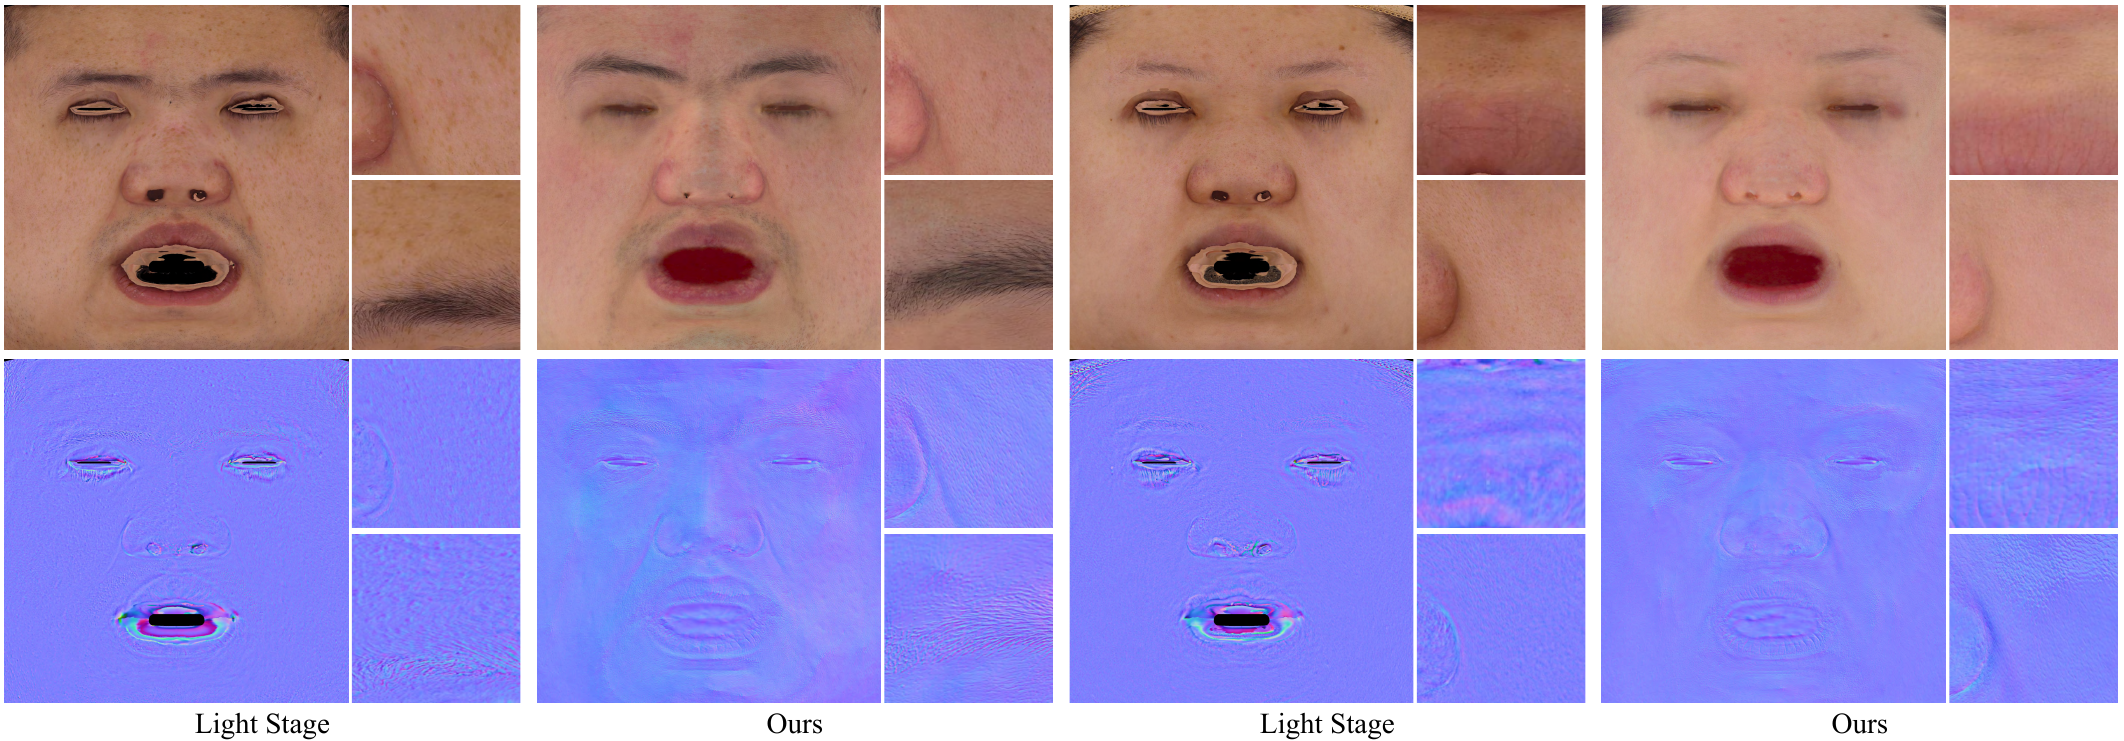
图8|两位人物的漫反射反照率与法线比较,每组左为Light Stage,右为本文。来源:原论文图8。
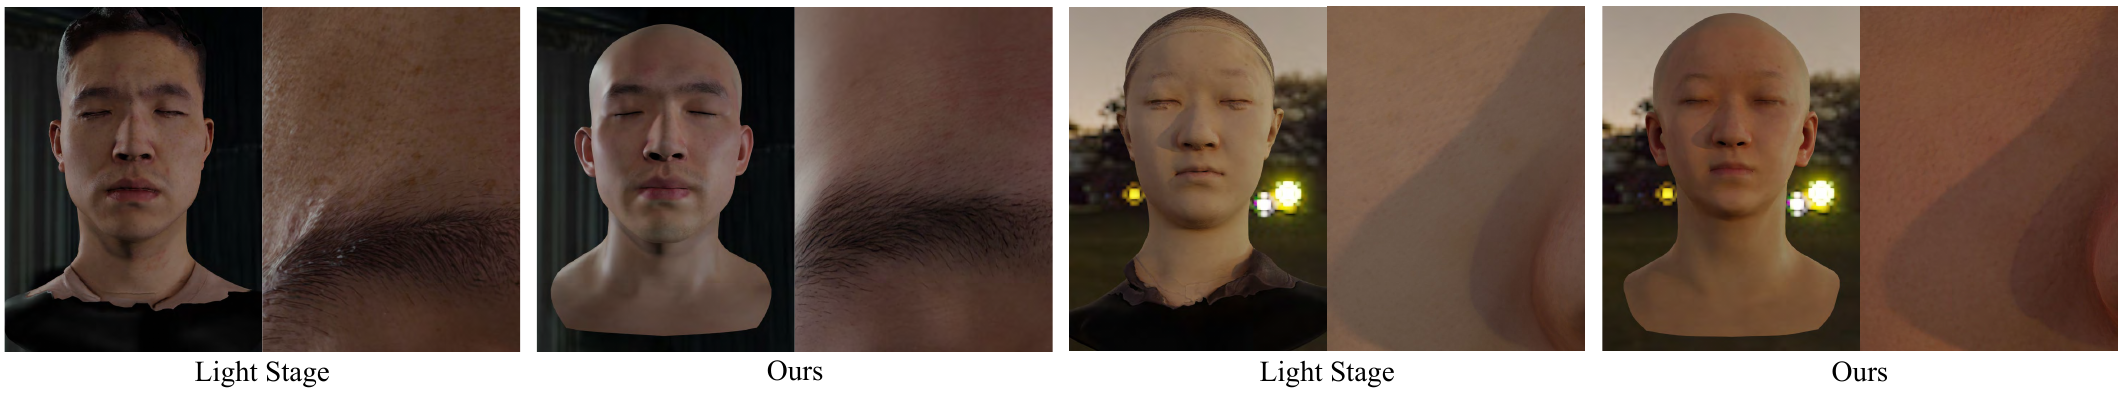
图9|同一人物的两类采集结果在新照明下渲染。来源:原论文图9。
作者让两位人物分别接受手机采集与SoulShell的Light Stage扫描,再比较两类结果。这个设计能直接观察家用流程与实际专业装置的差距。
但原文也说明,该Light Stage是对既有偏振采集方案的受限实现,无法输出镜面反照率与镜面法线,因此图8只比较漫反射反照率和法线。
所以,结果支持手机方案在这些人物、这些输出上的质量接近程度,不能扩大为已经追平所有专业系统的全部材质能力。它也没有给出独立微几何深度真值。
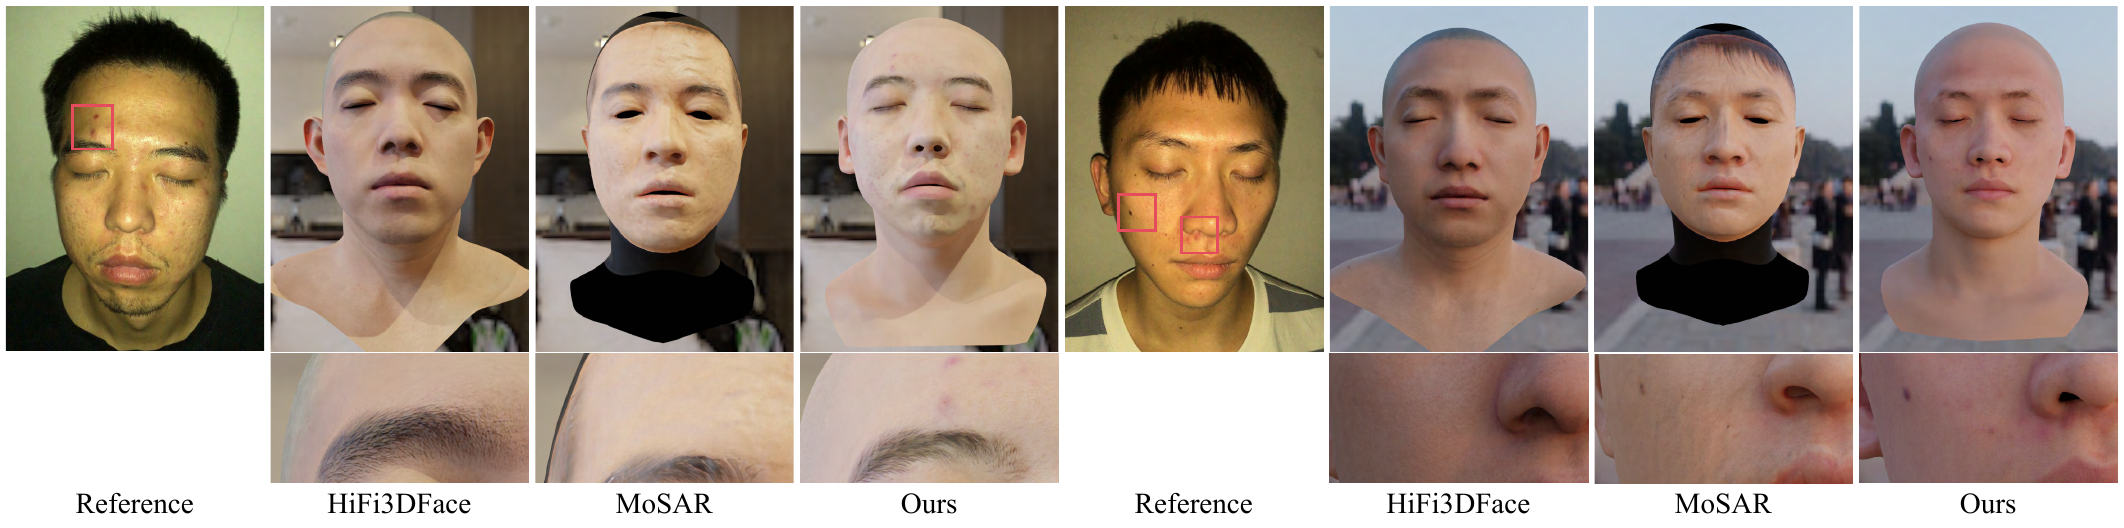
图10|Reference、HiFi3DFace、MoSAR与本文。来源:原论文图10。
与另外两种方法的比较同样需要保留输入条件:HiFi3DFace使用额外拍摄的4张照片,MoSAR使用一张额外正面图,本文使用手机闪光灯序列。结果差异既涉及先验表达,也受到观测数量、几何和训练数据质量影响,不能都归因于扩散网络这一项。
十、接缝、位置和照片约束,每一项都有对应实验
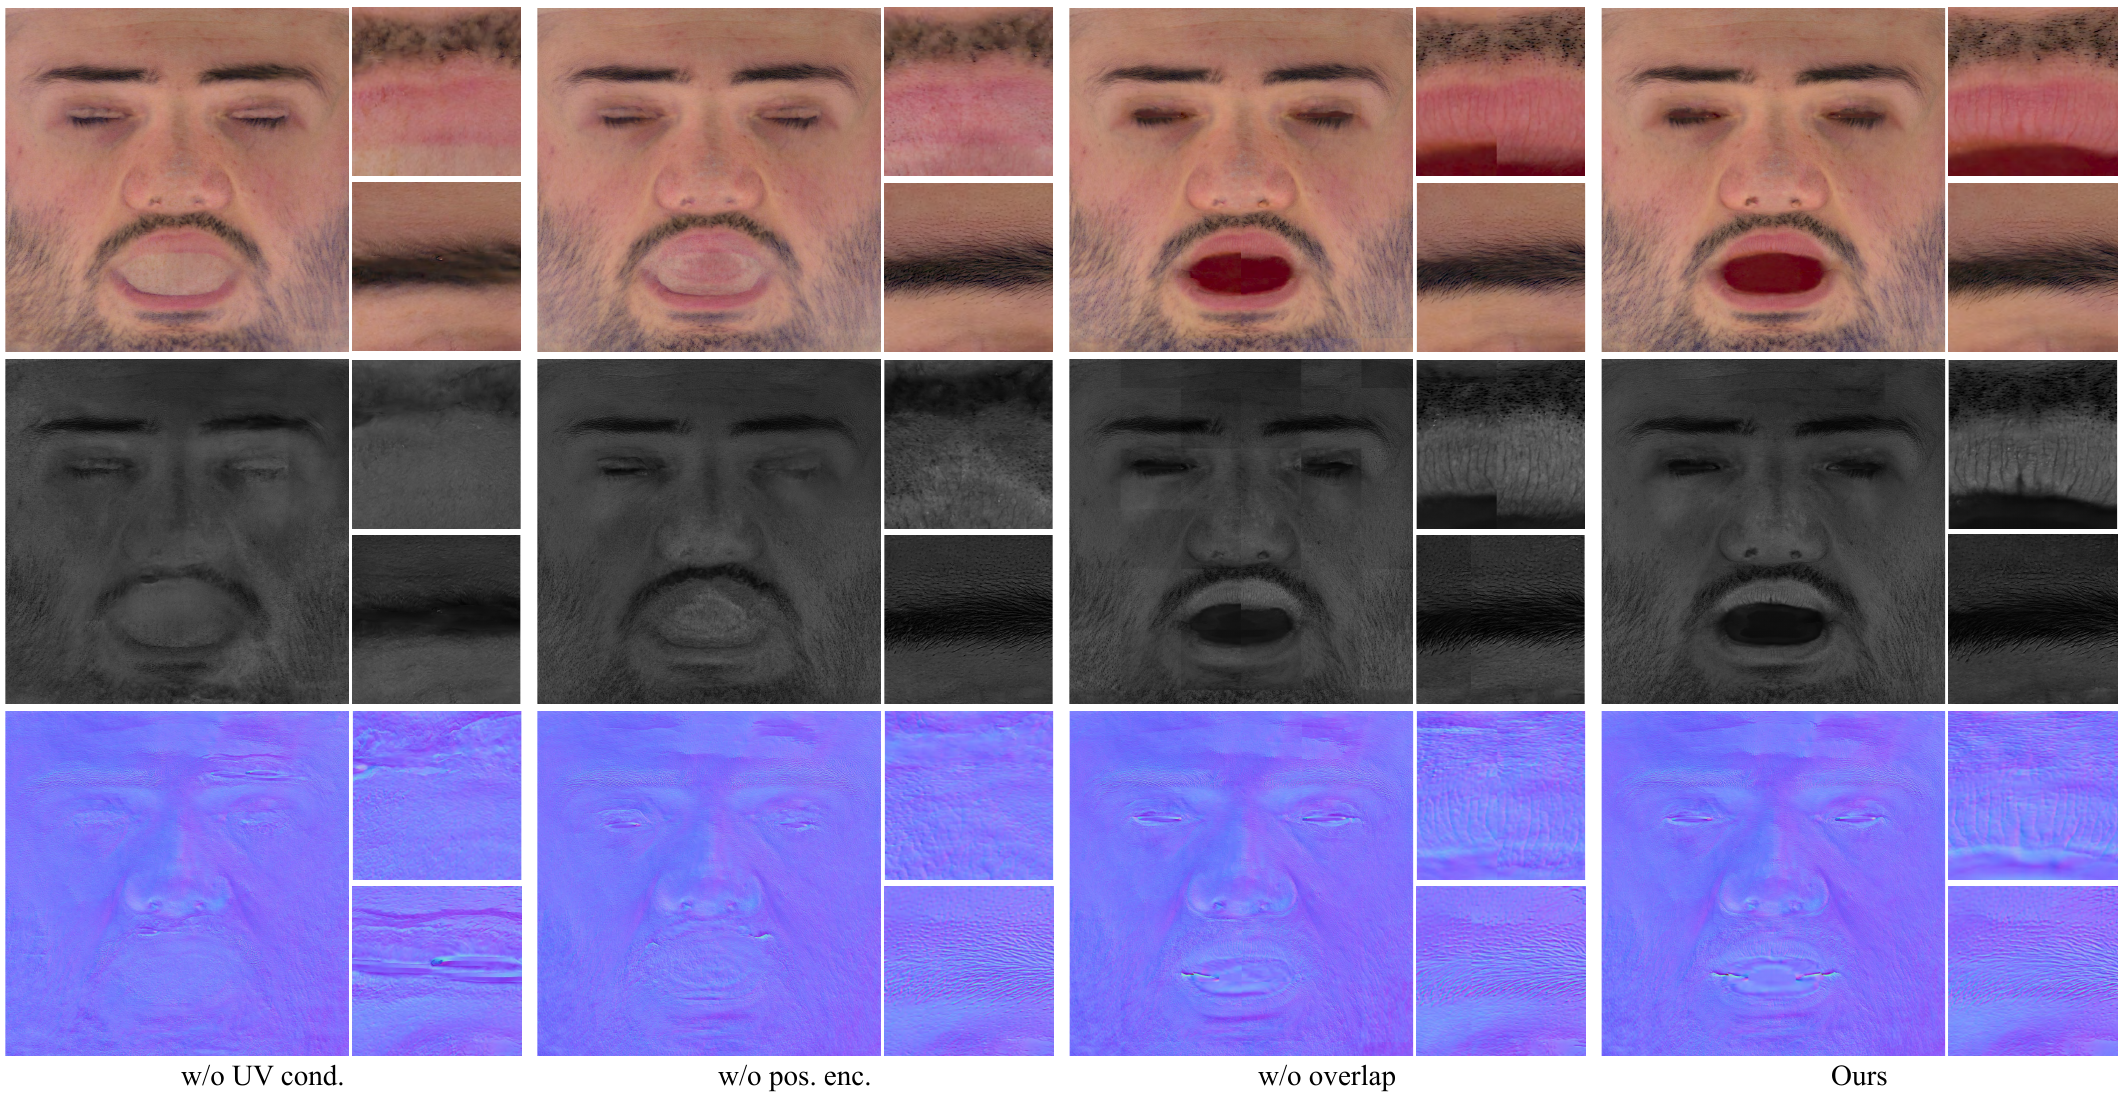
图12|从左到右分别去掉UV条件、去掉UV位置编码、去掉重叠融合,以及完整方法。来源:原论文图12。
去掉UV条件,相当于让一块材质在整个脸部先验空间中寻找解释,眉毛和嘴唇的结构更难恢复。保留UV但去掉位置编码,位置提示的区分能力仍不足。去掉重叠融合,相邻区域容易出现边界不连续。
消融表中的部分数据如下:
| 设置 | PSNR ↑ | SSIM ↑ | LPIPS ↓ |
|---|---|---|---|
| 无UV条件 | 31.75 | 0.9541 | 0.071 |
| 无位置编码 | 31.61 | 0.9517 | 0.072 |
| 无重叠融合 | 31.71 | 0.9530 | 0.071 |
| 完整方法 | 31.87 | 0.9545 | 0.070 |
据原论文表2选取,平均于4位人物,PSNR单位为dB。不能与前面8人主表直接横比。
指标增幅不大,因此还需要结合图12观察区域结构和接缝,不能仅靠数字宣称巨大提升。
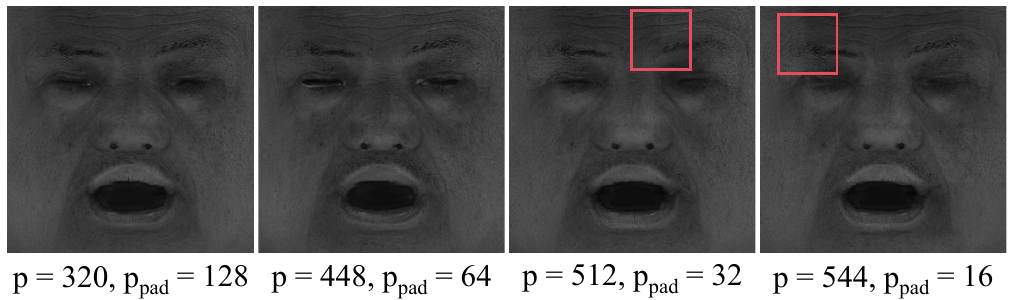
图13|实际网络输入均为576×576,改变内部区域$p$与外扩宽度$p_{pad}$;展示镜面反照率。来源:原论文图13。
重叠越小,重复计算越少,处理更快。但边界之间交流不足,局部质量可能下降。表2中,将设置从默认448/64改为544/16,时间从508分钟降到391分钟,PSNR还略升到31.94;图13却揭示了更小重叠下的局部问题。作者选择默认设置,是效率与可视质量的折中。
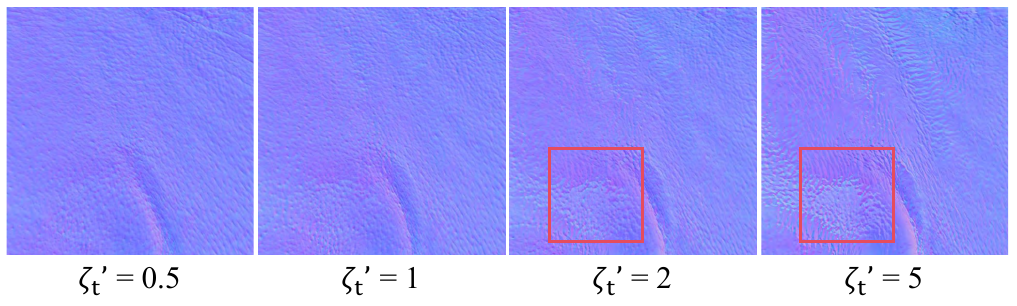
图14|从左到右,归一化引导权重为0.5、1、2、5,展示法线局部。来源:原论文图14。
更强照片引导同样不是无条件更好。权重为5时,消融PSNR从默认31.87升到33.09,但法线可能更加粗糙或不自然。它说明更努力解释手机照片,和保持高质量材质分布之间存在取舍。作者最终选择权重1。
十一、先验补足信息,也会带来数据偏向
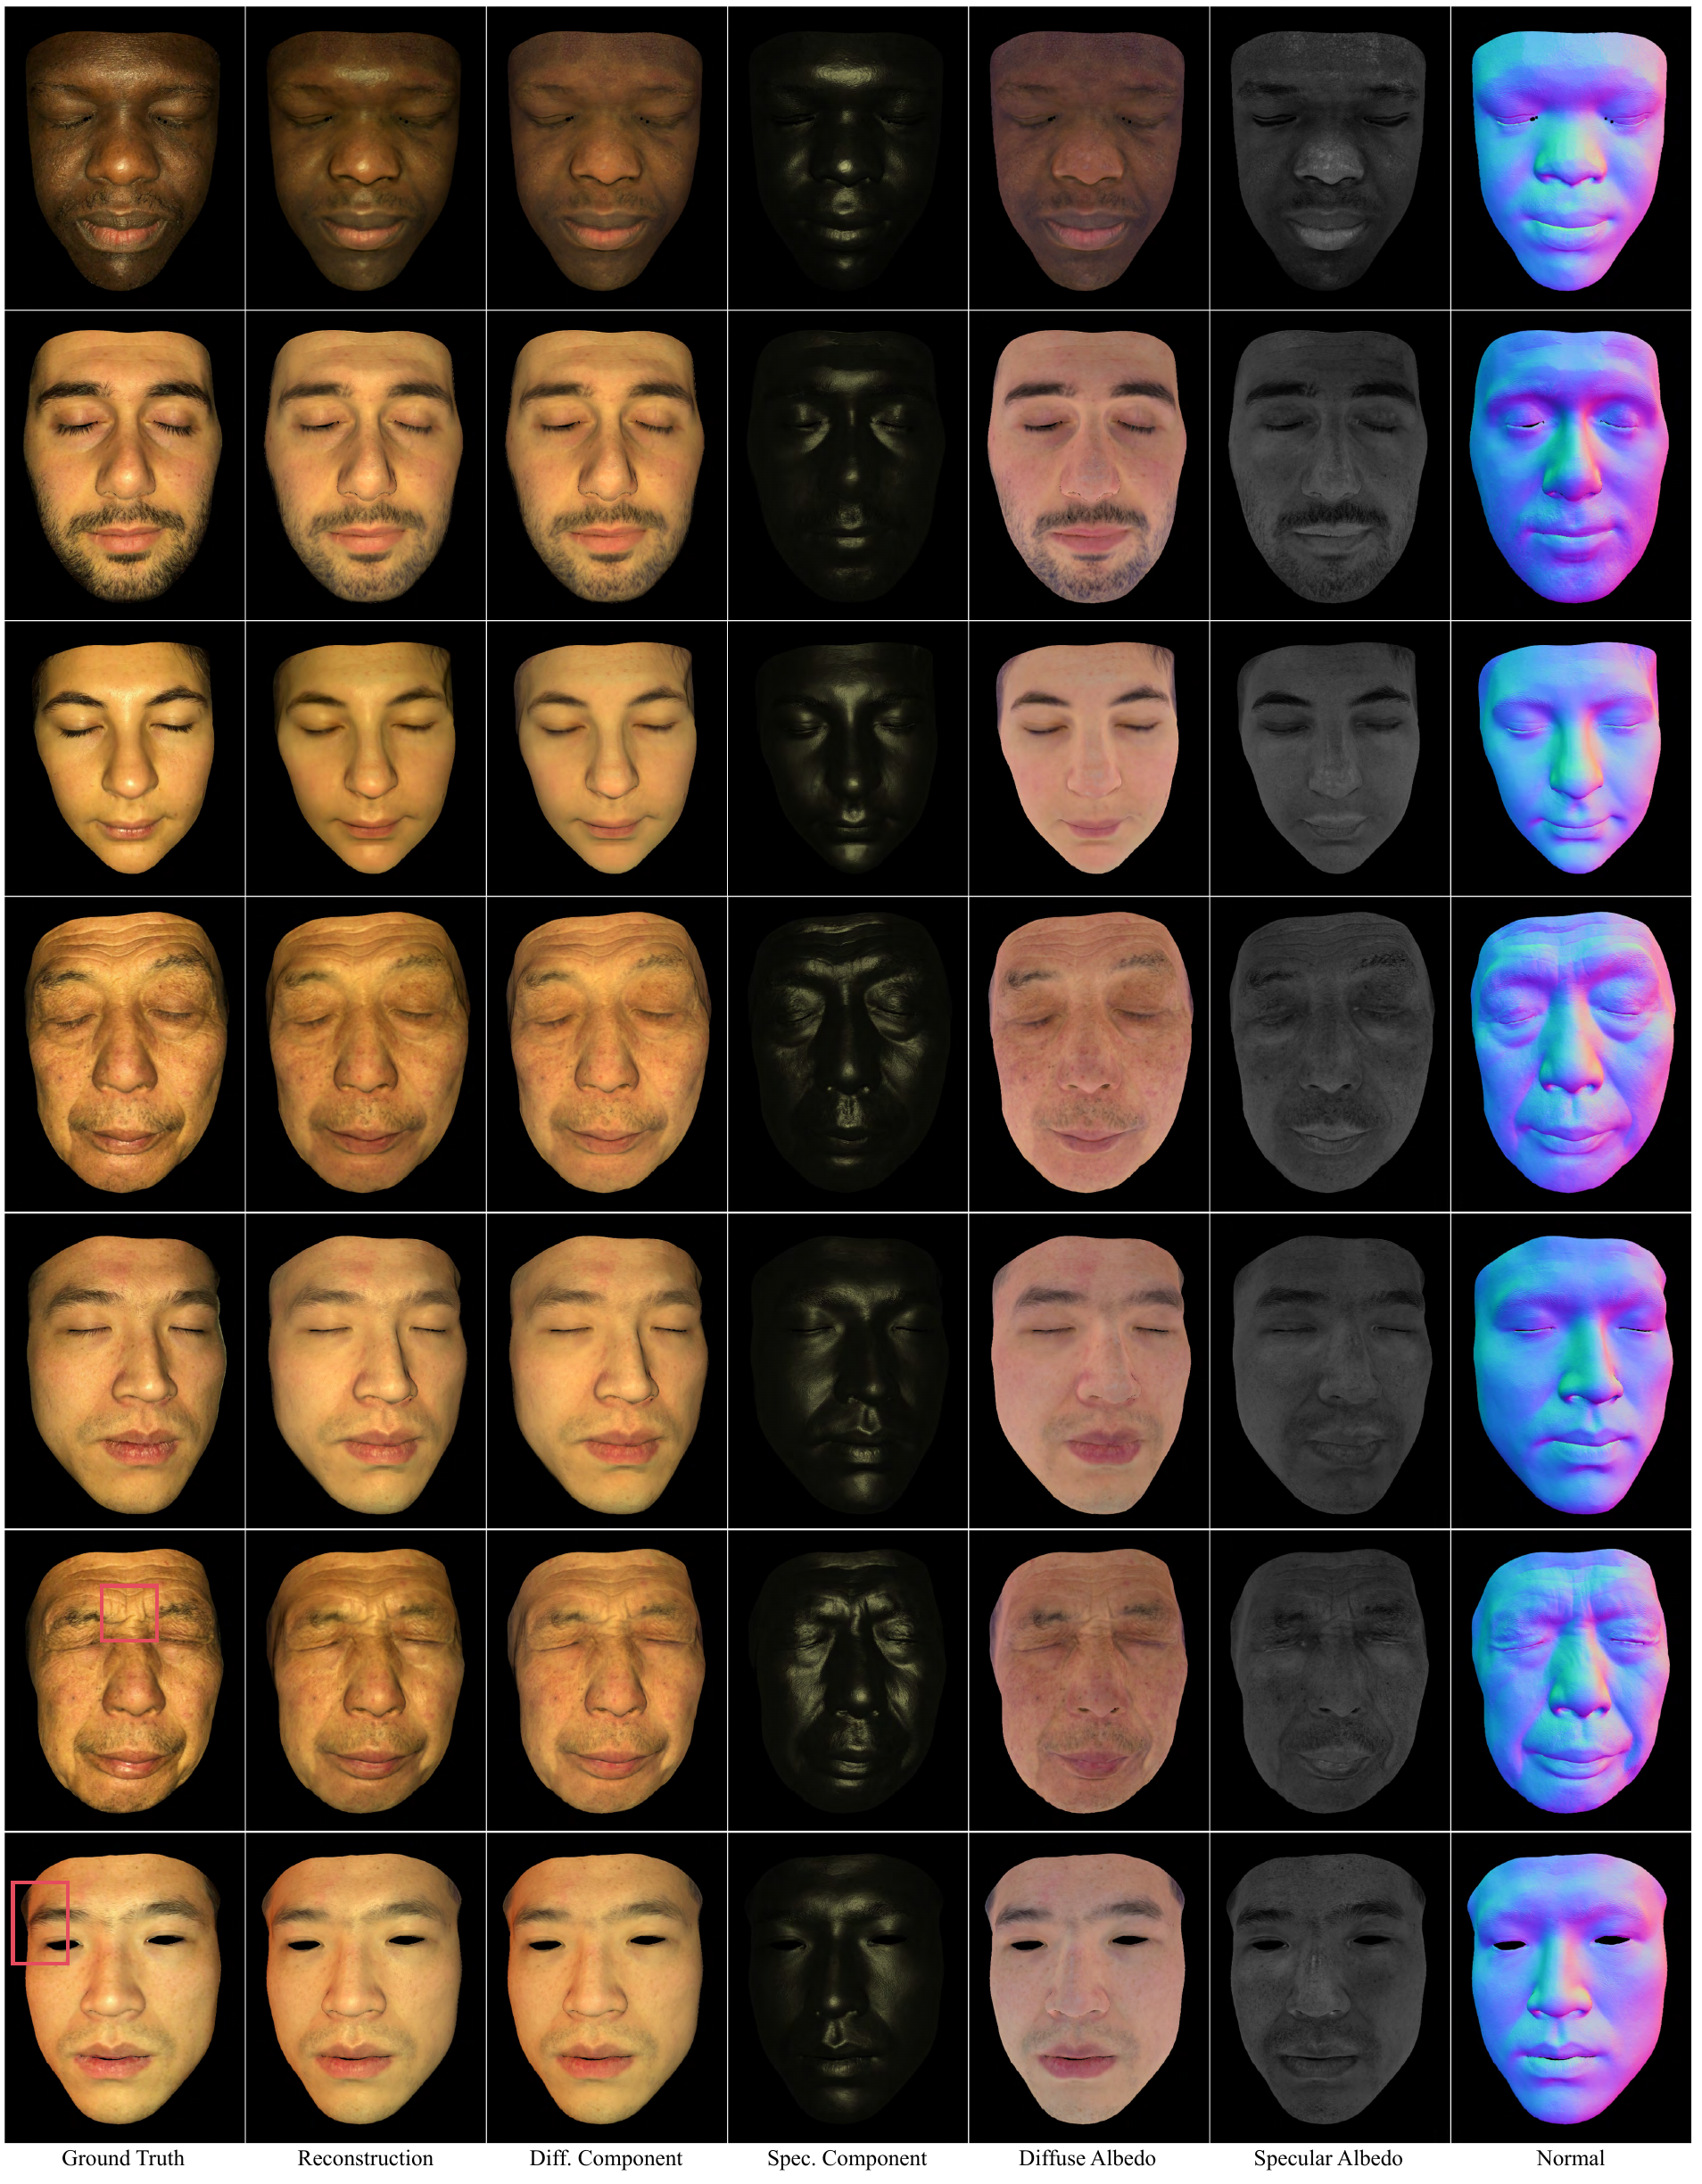
图15|各列为真实图像、重建、漫反射成分、镜面成分、漫反射反照率、镜面反照率和法线;含不同人物、挤眼表情及不对称环境光例子。来源:原论文图15。
论文展示了训练集之外的人物和表情。虽然训练扫描只有中性表情,局部先验结合多视角照片仍能处理一个挤眼例子。这是有限案例的泛化展示,还不足以说明任意动态表演都能稳定恢复。
更直接的数据边界出现在胡须上。
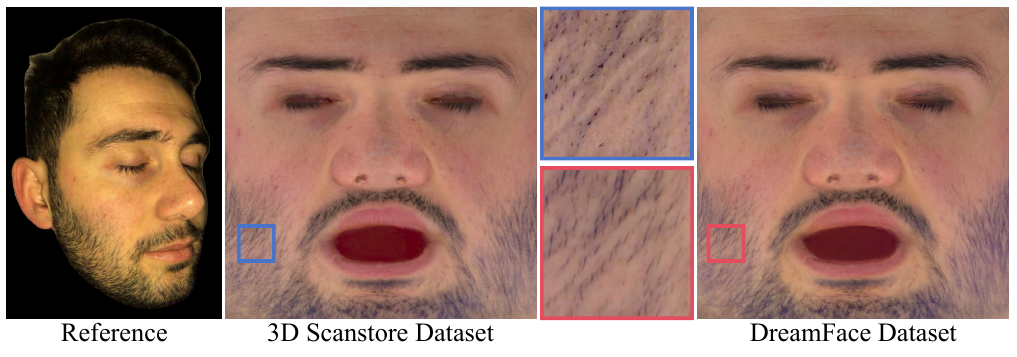
图17|以3D Scanstore训练的先验难以恢复浓密胡须;换成DreamFace数据训练后,胡须表现改善,但整体质量下降。来源:原论文图17。
48份专业扫描中的男性均剃过胡须,因此浓密胡须不在其良好覆盖范围内。作者换用100份DreamFace生成扫描训练另一个先验,胡须变好,整体材质却受到数据质量差异影响。
这个实验说明,先验既能提供细节约束,也会限制可表达的内容。在观测较弱的区域,清楚、自然的纹理仍可能更多来自训练分布,不能仅凭清晰度判断人物细节已被逐一测量。
还有两项与皮肤几何研究直接相关的限制。基础网格与相机若有误差,法线可能弯曲来补偿投影或形状偏差;局部法线更复杂,并不一定意味着表面更准确。当前渲染也忽略了次表面散射与完整全局光照,它们可能影响反射分解的物理真实性。
十二、完整头像展示,包含哪些额外工作?
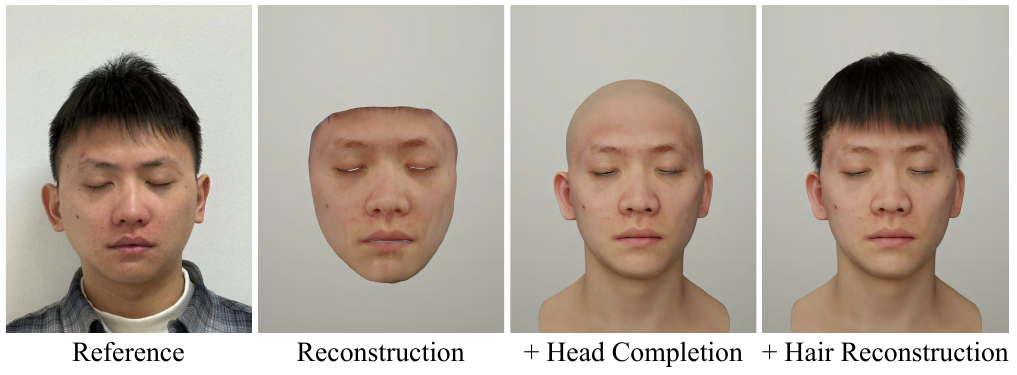
图16|从面部重建,到头部补全,再加入头发。来源:原论文图16。
图16展示的完整头像包含后处理:拟合头部参数模型并做拉普拉斯变形,利用PCA补全整头纹理,再额外拍摄头发视频,运行Gaussian Haircut重建发丝。作者还在Blender中人工对齐头发并调整其反射参数。
因此,这个展示说明面部结果可以接入现有资产制作流程,完整头发并非由同一段手机人脸视频和局部皮肤先验直接恢复。
对于偏振与毛孔级人脸重建,这项工作提出了一个值得继续检验的问题:专业数据先验能补充家用采集缺失的信息,但如何区分“由当前观测支持的细节”和“由数据分布补出的细节”?本文没有增加偏振测量,也没有直接优化微几何位移。若将其思路用于后续3DGS研究,就需要把跨光照渲染、反射分解和独立几何测量分别验证。
这篇论文最具体的推进,是把高质量局部材质分布变成了一个可被真实照片引导的求解条件。手机记录当前人物的证据,专业扫描提供合理材质的范围,逐步融合的局部采样让两者在4K贴图上共同起作用。
