
 洗子
 匿名

一张渲染图看起来像真的,并不意味着它背后的三维表面也准确。
用3D高斯溅射重建一张桌子,换角度观看时,桌面纹理可能很清楚;但把模型转换为三角网格,桌面却可能出现波纹、浮点或孔洞。原来让照片吻合的颜色与透明度组合,并没有唯一确定一张平整的桌面。
这篇SIGGRAPH2024论文研究的就是这种差别。作者希望保留高斯溅射的高效渲染,同时让表示更接近真实表面。他们把有厚度的三维高斯改为放置在三维空间中的二维高斯圆盘,再让像素射线与圆盘求交,直接得到几何位置。
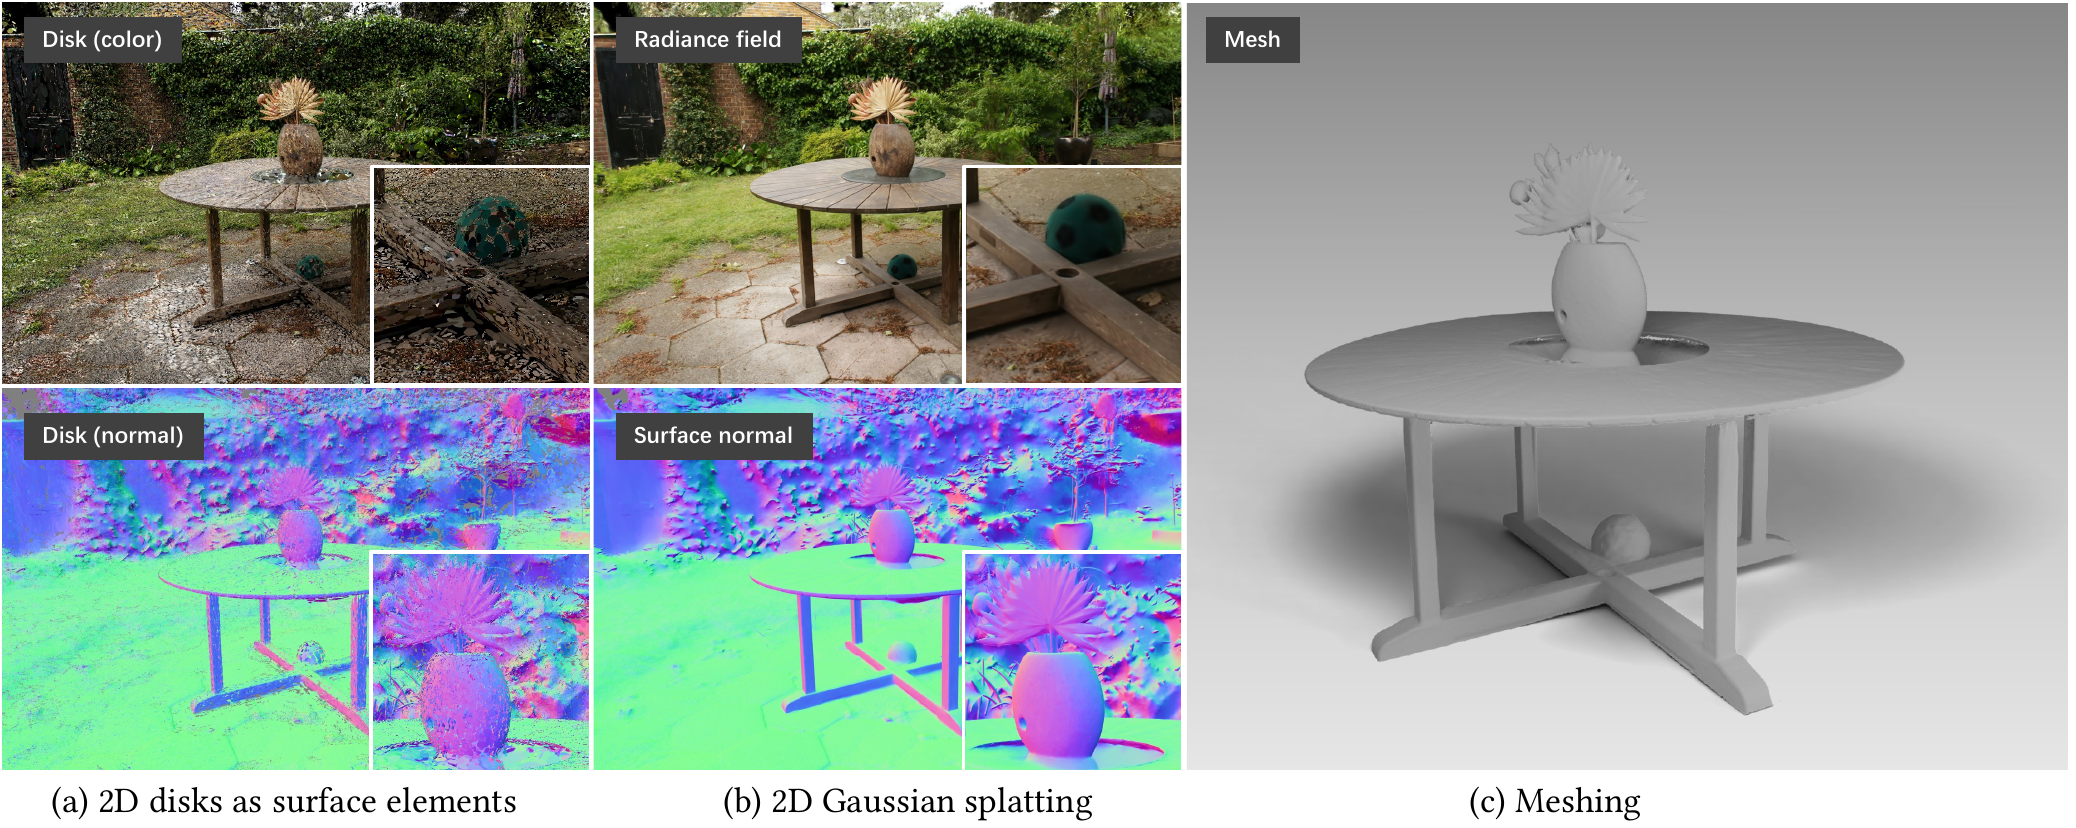
图1|左侧为二维圆盘及其法线,中间为渲染颜色与表面法线,右侧为提取的三角网格。来源:原论文图1。
图1的三部分对应整篇论文的逻辑:先决定用什么表示表面,再决定怎样渲染这些表面,最后从可信的深度中提取网格。两项正则约束贯穿训练,让圆盘的位置和朝向共同接近一张真实表面。
论文信息
| 项目 | 内容 |
|---|---|
| 英文标题 | 2D Gaussian Splatting for Geometrically Accurate Radiance Fields |
| 中文标题 | 面向几何精确辐射场的二维高斯溅射 |
| 发表 | SIGGRAPH 2024,Conference Papers |
| 作者 | Binbin Huang、Zehao Yu、Anpei Chen、Andreas Geiger、Shenghua Gao |
| 机构 | 上海科技大学、图宾根大学、Tübingen AI Center |
| 项目主页 | https://surfsplatting.github.io/ |
| 论文 | https://arxiv.org/abs/2403.17888 |
| DOI | https://doi.org/10.1145/3641519.3657428 |
| 官方代码 | https://github.com/hbb1/2d-gaussian-splatting |
| 关键词 | 二维高斯、表面元、透视正确溅射、深度畸变、法线一致性、网格提取 |
一、3D高斯能把图像拟合好,为什么还会长出错误几何?
一个3D高斯可以理解为三维空间中一团具有方向、大小、颜色和不透明度的柔软椭球。许多椭球投影到屏幕上,从前到后混合,就能生成图像。
对于新视角合成,这种表达很有效。但如果目标是重建桌面、雕塑或墙壁,实体表面通常是一层薄边界。一团有厚度的高斯究竟哪一层属于表面,并没有被直接指定。
此外,3DGS使用局部仿射近似,把三维高斯投影成屏幕上的二维高斯。这种近似在高斯中心附近较准确,在离中心较远的位置、较大的基元或倾斜观察下,可能产生更明显的投影与深度误差。
这里需要区分:3D高斯的中心与形状仍然固定在三维空间中。问题在于它的体积表达与投影求值方式,没有像一张明确平面那样,为不同视角提供一致的表面交点。
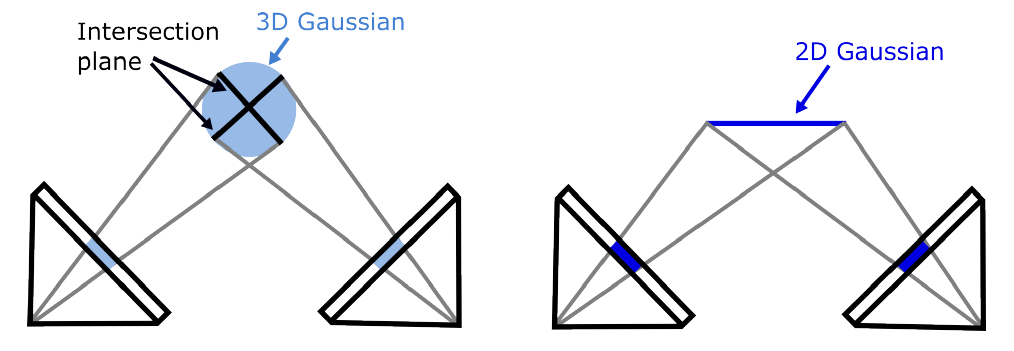
图2|左侧示意3D高斯在不同视角下的求值平面,右侧示意二维高斯使用固定表面平面。来源:原论文图2。
作者选择从表示本身着手:每个高斯直接成为一小块有方向的表面。相机换位置时,看到的还是同一块平面,射线只是在这块平面上落到不同位置。
“二维”描述的是每个基元内部的坐标维度。整个场景仍然是三维的,圆盘可以位于任意三维位置,也可以朝向任意方向。
二、一个二维高斯,怎样放进三维世界?
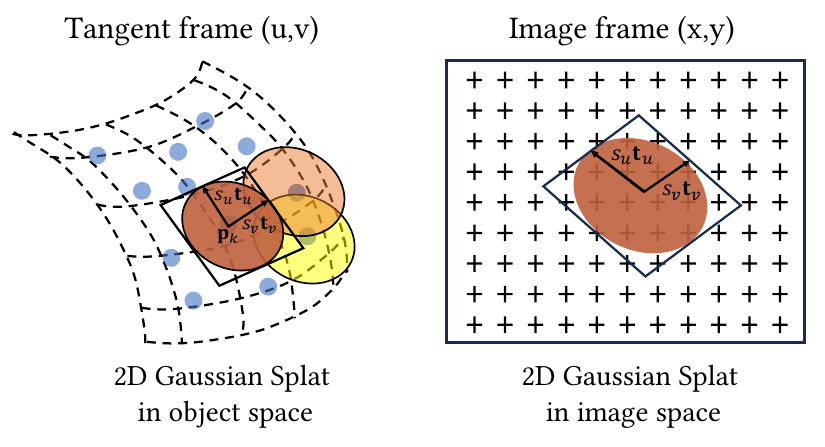
图3|左侧为三维空间中的局部切平面,右侧为投影后的像素采样。来源:原论文图3。
每个圆盘由中心$\mathbf{ p }_k$、两个正交切向量$\mathbf{ t }_u$与$\mathbf{ t }_v$、两个尺度$s_u$与$s_v$描述。局部坐标$(u,v)$对应三维点,原论文式(4)为:
$$ P(u,v)=\mathbf{ p }_k+s_u\mathbf{ t }_u u+s_v\mathbf{ t }_v v. \tag{4} $$
这个式子从中心开始,沿两个切向方向分别走一定距离。两条轴张成一个平面,尺度决定高斯在平面上沿两个方向延伸多远。
在局部坐标中,高斯值为:
$$ \mathcal G(u,v)=\exp\left(-\frac{u^2+v^2}{2}\right). \tag{6} $$
中心贡献最大,向边缘平滑衰减。圆盘因此是带高斯权重的局部平面元,并非一块边界截然分明、完全不透明的硬椭圆。
它的法线自然由两个切向量给出:
$$ \mathbf{ n }=\mathbf{ t }_u\times\mathbf{ t }_v. $$
这来自原文对局部坐标系的定义。法线与圆盘朝向属于同一个几何参数化,旋转圆盘就会同时改变它的平面和法线。
作者仍为每个基元保留不透明度和球谐表示的视角相关颜色,并优化中心、旋转与两个尺度。仅有这些设置还不够,渲染过程也必须承认它是一块平面。
三、把高斯压扁之后,为什么还要重新设计渲染?
可以做一个直观实验:把一组二维圆盘铺在同一平面上,斜着看它们。即使圆盘没有厚度,若仍使用原来的仿射投影近似,估计出的深度也未必保留每块圆盘应有的平面形状。
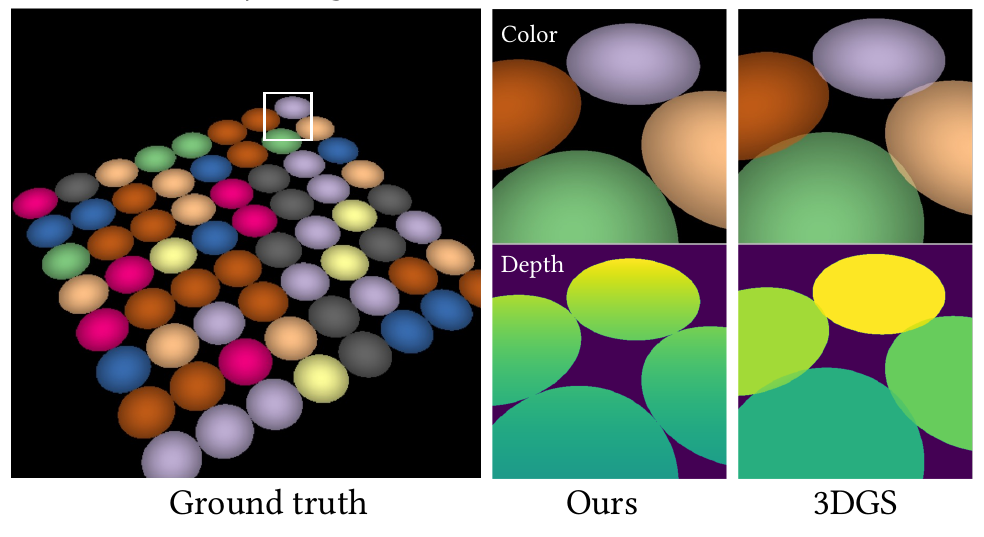
图7|右侧比较2DGS与沿用3DGS式仿射近似的结果,分别展示颜色与深度。来源:原论文图7。
图7中,颜色上的差别未必十分刺眼,深度却暴露了投影误差。论文附录还专门把3D高斯的一个尺度设置到$10^{-6}$,构造“很薄但仍用仿射光栅器”的基线,验证压薄表示与更换渲染器是两项不同的改进。
2DGS的做法是,对每个像素找到射线与圆盘平面的真实交点,再计算交点处的高斯值与深度。这称为透视正确的射线—基元求交。
四、求交公式其实是在解两个一次方程
这部分看似复杂,但核心可以从一个简单问题理解:一个三维点要投影到指定像素,必须同时满足该像素的横坐标与纵坐标条件。
作者在齐次投影空间中,用两个平面的交线表示像素射线。像素$(x,y)$对应:
$$ \mathbf{ h }_x=(-1,0,0,x)^T,\qquad \mathbf{ h }_y=(0,-1,0,y)^T. $$
$\mathbf{ H }$将局部圆盘坐标映射到三维齐次坐标,$\mathbf{ W }$将世界坐标映射到屏幕齐次空间。把像素平面的条件带回局部圆盘坐标,原论文式(8)为:
$$ \mathbf{ h }_u=(\mathbf{ W }\mathbf{ H })^T\mathbf{ h }_x, \qquad \mathbf{ h }_v=(\mathbf{ W }\mathbf{ H })^T\mathbf{ h }_y. \tag{8} $$
为什么是转置?设局部齐次点为$\mathbf{ q }$,它落在像素平面上的条件是$\mathbf{ h }_x^T\mathbf{ W }\mathbf{ H }\mathbf{ q }=0$。将乘法重新结合,就得到$[(\mathbf{ W }\mathbf{ H })^T\mathbf{ h }_x]^T\mathbf{ q }=0$。这是对原式的补充解释,整个过程不需要显式求投影矩阵的逆。
随后要求局部点$(u,v,1,1)^T$同时落在两个变换后的平面上。由于相应第三分量为零,原论文式(9)变成两个关于$u,v$的线性方程:
$$ \begin{cases} h_u^1u+h_u^2v+h_u^4=0,\\ h_v^1u+h_v^2v+h_v^4=0. \end{cases} $$
为便于阅读,这里将原式(9)的点积写开。令行列式$\Delta=h_u^1h_v^2-h_u^2h_v^1$,用二元一次方程的消元或克拉默法则,就得到原论文式(10):
$$ u(x,y)=\frac{h_u^2h_v^4-h_u^4h_v^2}{\Delta}, \qquad v(x,y)=\frac{h_u^4h_v^1-h_u^1h_v^4}{\Delta}. \tag{10} $$
得到$(u,v)$后,式(4)告诉我们交点在哪里,投影关系给出交点深度,式(6)给出它对当前像素的高斯权重。这几步共同把颜色采样与三维几何位置绑定起来。
这里的局部$(u,v)$是单个圆盘的切平面坐标,与人脸材质贴图的整脸UV展开是不同的概念。
五、圆盘侧过来只剩一条线时,怎样继续优化?
圆盘被斜着看时,投影可能窄到几乎覆盖不到像素;接近侧视的几何求交也会变得病态。训练不能简单地把这些基元都硬性丢掉,否则微小旋转就可能引起可见贡献突然变化。
作者加入一个最小屏幕覆盖。原论文式(11)为:
$$ \hat{\mathcal G}(\mathbf{ x })= \max\left\{\mathcal G(\mathbf{ u }(\mathbf{ x })), \mathcal G\left(\frac{\mathbf{ x }-\mathbf{ c }}{\sigma}\right)\right\}. \tag{11} $$
$\mathbf{ c }$是圆盘中心在屏幕上的投影,$\sigma=\sqrt2/2$。第一个值来自真实平面求交,第二个提供一个固定大小的屏幕高斯下界,帮助细小或侧视基元保留一定像素覆盖。
这是稳定光栅化与优化的处理,不意味着任何接近退化的视角都能恢复可靠几何。它也让我们看到,“透视正确”主要指平面求交,整套离散渲染仍包含像素覆盖等工程近似。
之后,2DGS沿用高效的分块光栅化:计算包围盒,按基元中心深度排序,分配到屏幕小块,再从前向后进行透明度混合。
原论文式(12)的核心为:
$$ \mathbf{ c }(\mathbf{ x })=\sum_i\mathbf{ c }_i\alpha_i\hat{\mathcal G}_i \prod_{j<i}(1-\alpha_j\hat{\mathcal G}_j). \tag{12} $$
$\alpha_i\hat{\mathcal G}_i$表示当前交点的覆盖贡献,前面的乘积表示经过更前方基元后还剩多少可见性。为了紧凑,这里省略高斯求值位置的重复记号。
排序依据仍是中心深度,而非每个像素交点的严格重新排序。因此,二维平面改进了局部几何求值,也不能直接推出全局渲染已经没有排序误差。
六、照片吻合之后,还需要让深度聚成一层
多个半透明圆盘分散在一条射线上,仍可能混合出正确颜色。颜色误差并不关心它们沿射线相隔多远;但对于不透明物体,通常希望可见贡献集中在表面附近。
作者用深度畸变损失约束这种分散。原论文式(13)为:
$$ \mathcal L_d=\sum_{i,j}\omega_i\omega_j|z_i-z_j|. \tag{13} $$
$z_i$、$z_j$是两个圆盘交点的深度,$\omega$就是透明度混合时的可见贡献。两个贡献都大、深度又相差很远,就会受到较大惩罚;其中一个几乎不可见,影响就很小。
假设一条射线上两个交点的权重都为0.5,深度相差1。按式(13)的全配对求和,两个非零方向项合计为0.5;两点靠到同一深度,损失变成0。这只是帮助理解的数值例子。
不过,实际实现与这条主文公式有差别。附录A使用平方差,并先把深度转换到NDC空间,以减弱远处基元的影响。平方差也不要求交点深度已经严格排序,这与中心排序的光栅流程相适应。
其形式是每对交点计一次:
$$ \mathcal L=\sum_i\sum_{j<i}\omega_i\omega_j(m_i-m_j)^2, \qquad m_i=\operatorname{NDC}(z_i). $$
这来自原论文式(17)的第一行,和式(13)的原始深度绝对差并非同一表达。
七、两两比较看起来很慢,为什么还能放进快速渲染器?
若对一条射线的每对交点都显式比较,计算量会随交点数量平方增长。附录将平方差展开,变成可以逐点累计的形式。
定义前面交点的累计量:
$$ A_{i-1}=\sum_{j<i}\omega_j,\quad D_{i-1}=\sum_{j<i}\omega_jm_j,\quad Q_{i-1}=\sum_{j<i}\omega_jm_j^2. $$
这里用$Q$指代原文记作$D^2$的二阶累计量,便于避免把它误读成$D$的平方。将$(m_i-m_j)^2=m_i^2+m_j^2-2m_im_j$展开、分别合并求和,就得到原论文式(17)的等价写法:
$$ \mathcal L=\sum_i\omega_i \left(m_i^2A_{i-1}+Q_{i-1}-2m_iD_{i-1}\right). \tag{17} $$
渲染器走到第$i$个交点时,只要读取前面的三个累计值,就能计算它与所有前方交点的畸变贡献,再更新累计量。每条射线因此可以线性扫描完成。
梯度还会传到交点深度,进而推动圆盘移动。这个损失的作用不只是平滑一张事后生成的深度图,它参与了三维基元的位置优化。
八、深度接近了,还要让圆盘朝向与表面一致
一堆圆盘中心即使落在同一层,也可能朝向凌乱。2DGS因此再提出一个问题:圆盘自己的法线,是否与它们共同渲染出的表面法线一致?
作者先从深度图反投影得到邻近三维点$\mathbf{ p }_s$,沿图像两个方向计算有限差分,再叉乘得到法线。原论文式(15)为:
$$ \mathbf{ N }(x,y)= \frac{\nabla_x\mathbf{ p }_s\times\nabla_y\mathbf{ p }_s} {\|\nabla_x\mathbf{ p }_s\times\nabla_y\mathbf{ p }_s\|}. \tag{15} $$
这和用两个表面切向量确定垂直方向,是同一个基础几何关系。透视相机下,先反投影到三维再计算方向很重要,不能只把深度数值当成正交高度场。
随后,原论文式(14)让各圆盘法线接近这个方向:
$$ \mathcal L_n=\sum_i\omega_i(1-\mathbf{ n }_i^T\mathbf{ N }). \tag{14} $$
$\mathbf{ n }_i$朝向相机,$\mathbf{ N }$来自深度;方向一致时,点积接近1,损失较小。贡献较大的圆盘受到更强约束。
这是一种模型内部的几何一致性,没有额外输入真值法线。它要求“我的朝向”和“我共同形成的表面朝向”相吻合,但不能独立保证这张表面已经等于真实物体。
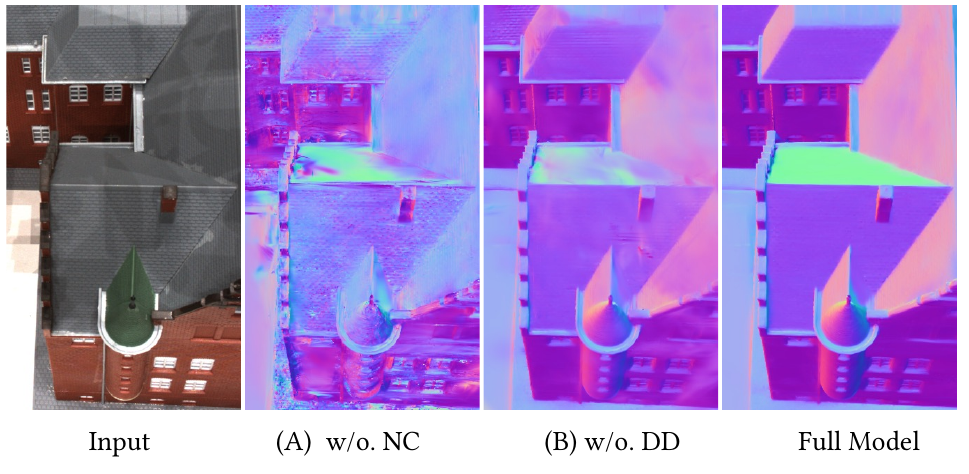
图6|输入、去掉法线一致性、去掉深度畸变、完整模型。来源:原论文图6。
看屋顶和墙面:去掉法线约束,局部朝向噪声较多;去掉深度畸变,结果在一些区域更模糊。两者一起使用,才更容易兼顾平面稳定与边缘清楚。
最终优化目标为原论文式(16):
$$ \mathcal L=\mathcal L_c+\alpha\mathcal L_d+\beta\mathcal L_n. \tag{16} $$
颜色损失$\mathcal L_c$使用L1与D-SSIM;深度损失权重在有界场景为1000、无界场景为100,法线权重为0.05。这里的$\alpha$是损失权重,与前面每个高斯的不透明度$\alpha_i$区分。
九、圆盘怎样变成可以使用的三角网格?
训练从带相机位姿的多视角图像和稀疏标定点云开始。作者使用自定义CUDA渲染器,并延续3DGS的增密与剪枝思路,逐步增加需要的基元、移除低不透明度基元。
训练后,作者没有简单把圆盘中心连成三角形,而是从多个训练视角渲染深度,再使用Open3D的TSDF融合提取网格。TSDF让不同视角共同约束一个体积中的表面零交叉。
深度可以有两种读法。原论文式(18)的均值深度为:
$$ z_{mean}=\frac{\sum_i\omega_i z_i}{\sum_i\omega_i+\epsilon}. \tag{18} $$
分母归一化很重要,否则透明度较低的地方会被错误缩放。均值会综合多个贡献,但也容易被较远的异常贡献拉偏。
主文网格提取采用另一种中位深度规则。附录式(19)为:
$$ z_{median}=\max\{z_i\mid T_i>0.5\}. \tag{19} $$
$T_i$是到第$i$个交点之前的剩余透射率,0.5用于界定表面与自由空间。它依据可见贡献的累积位置,和“把所有深度排序后取中间那个数”不同。若总不透明度未到0.5,原文选择最后一个可见基元。
主文消融中,中位深度比均值更稳健。官方当前代码也提供两者选择,因此做实验时需要记录所用配置,而不是把“2DGS深度”视作只有一种定义。
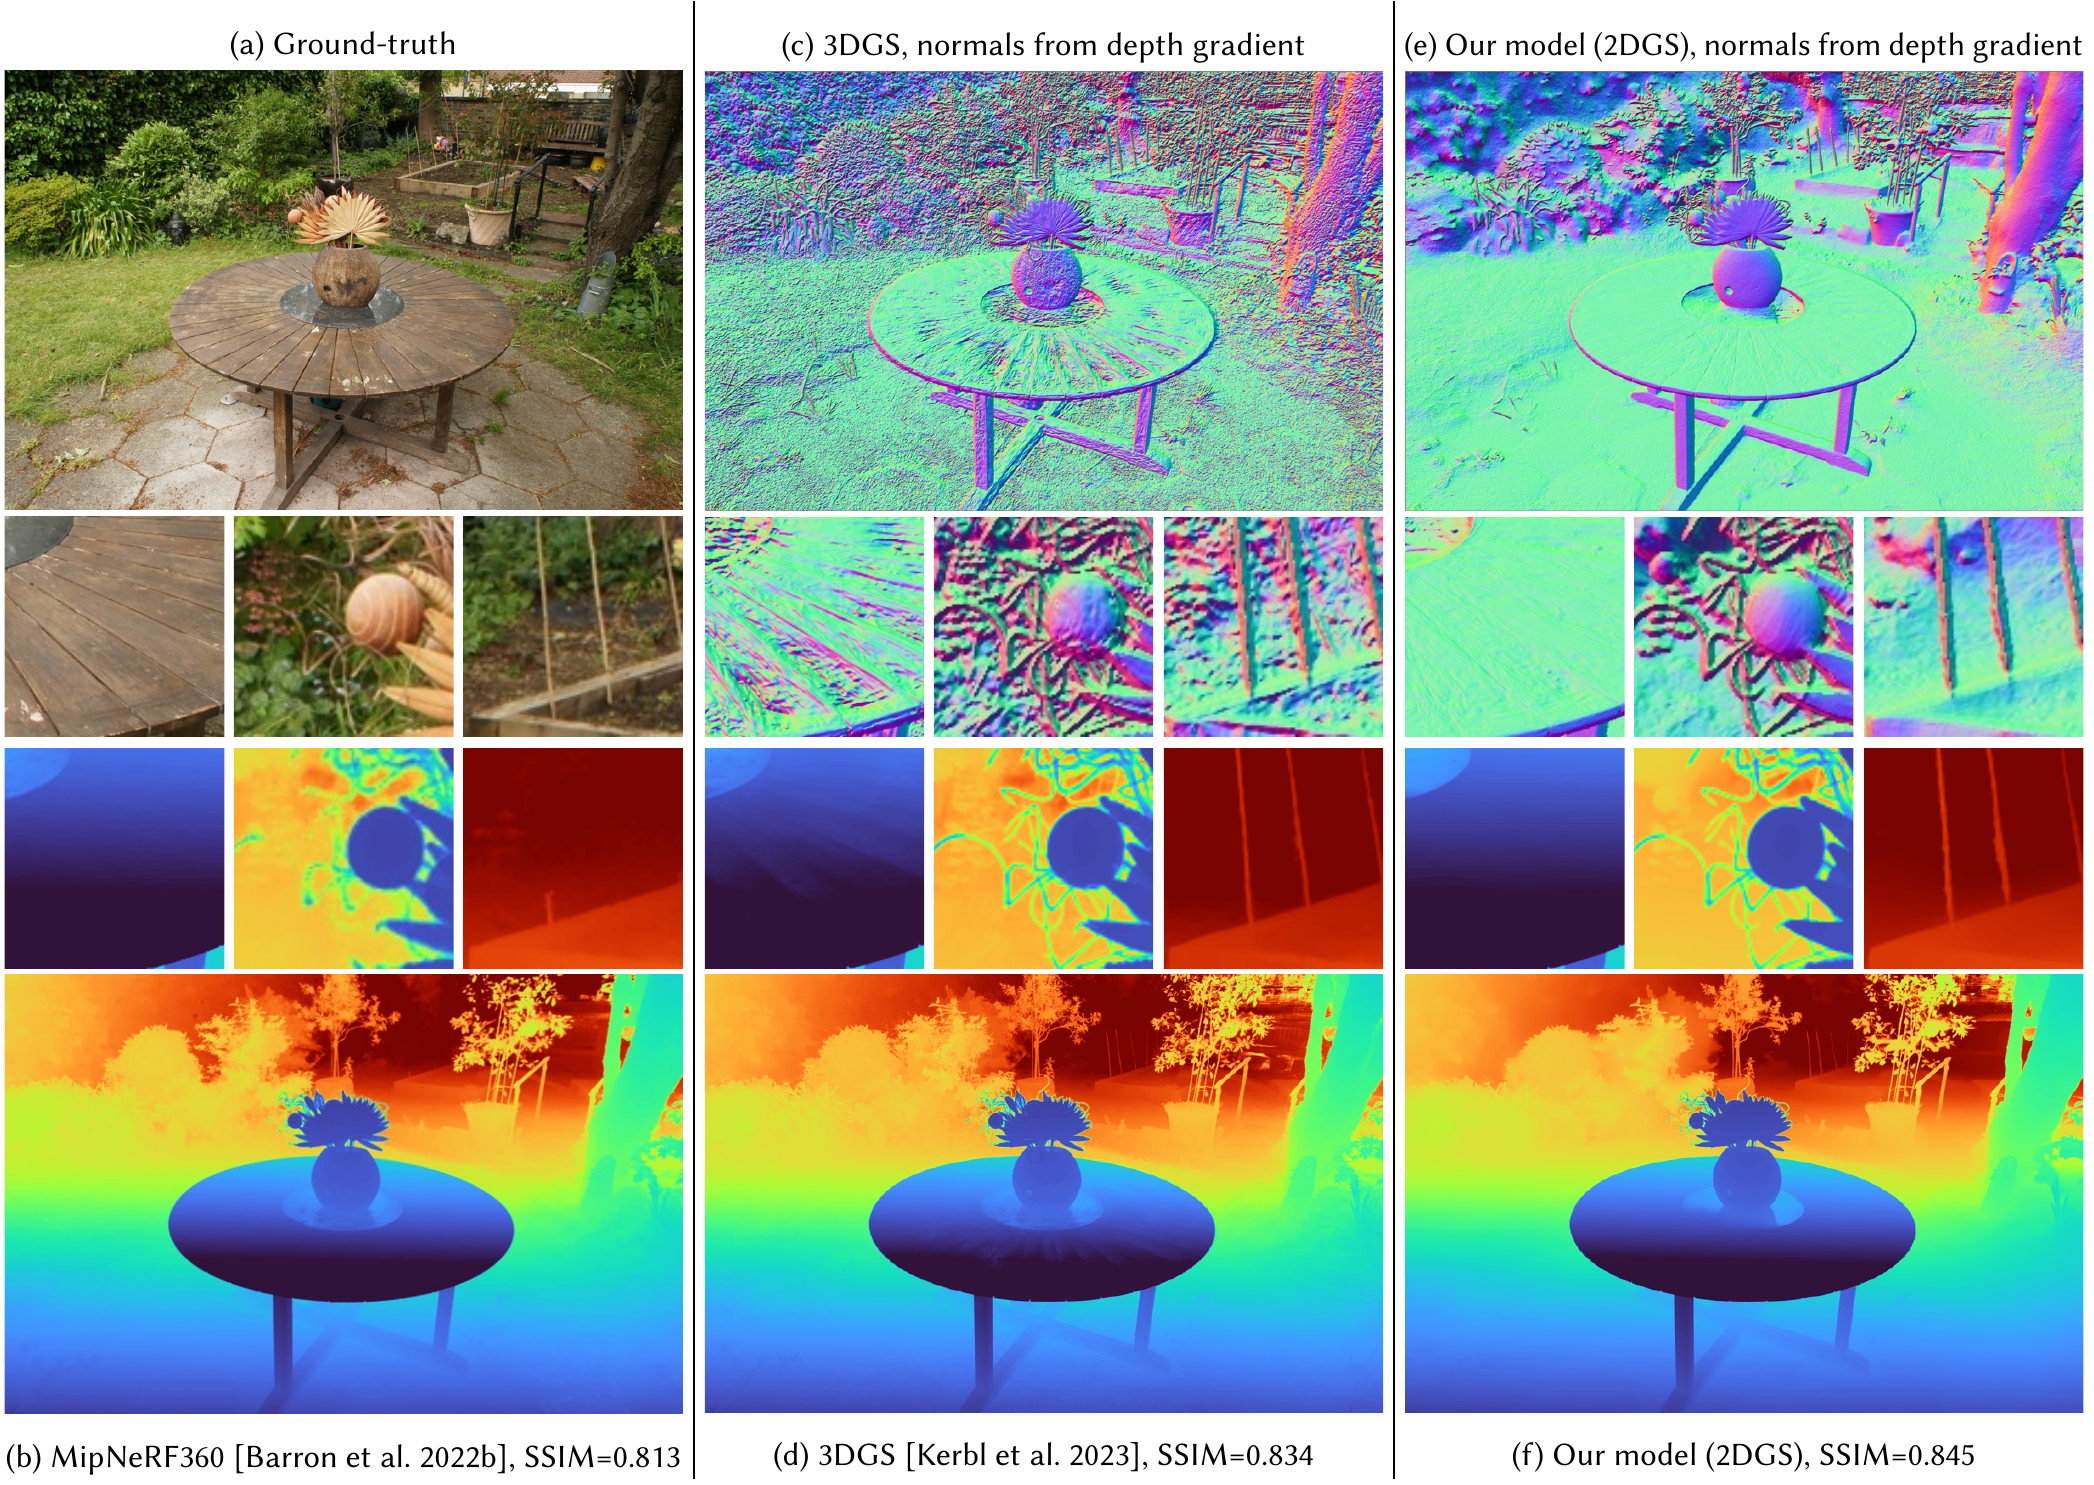
图8|比较Mip-NeRF360、3DGS和2DGS的深度;上部额外展示3DGS与2DGS由深度梯度得到的法线。来源:原论文图8。
这张图最值得看的是桌面和细杆。深度整体形状都可能像一张桌子,但法线图把局部抖动放大了:3DGS桌面有较多方向噪声,2DGS更平稳,有助于后续融合。图中的单例SSIM不能当成整套数据集的平均结论。
十、几何到底改善了多少?先看DTU
DTU实验使用15个场景,每个场景49或69张图像。作者用COLMAP生成稀疏点云,将图像降至800×600进行训练。论文中的几何比较使用提取网格,而不是只看渲染截图。
Chamfer距离可以直观理解为双向最近邻误差:重建表面的点到参考表面有多远,参考表面的点又能否在重建里找到近邻。两边都要看,才能同时关注准确性和完整性。
| 方法 | 平均CD ↓ | 时间 |
|---|---|---|
| VolSDF | 0.86 | >12小时 |
| NeuS | 0.84 | >12小时 |
| 3DGS | 1.96 | 11.2分钟 |
| SuGaR | 1.33 | 约1小时 |
| 2DGS,15k迭代 | 0.83 | 5.5分钟 |
| 2DGS,30k迭代 | 0.80 | 10.9分钟 |
据原论文表1选取平均列和时间;CD按原表评测尺度报告,越低越好。
在这个基准中,30k版2DGS将CD从3DGS的1.96降到0.80,下降约59.2%,同时保持相近训练时间。这一比例按$(1.96-0.80)/1.96$计算,只对应该表设置。
相对于表中需要12小时以上的方法,5.5分钟版本的时间差超过两个数量级。这支持论文所强调的效率优势,但不能转成所有场景、所有硬件与全部流程都固定快100倍。
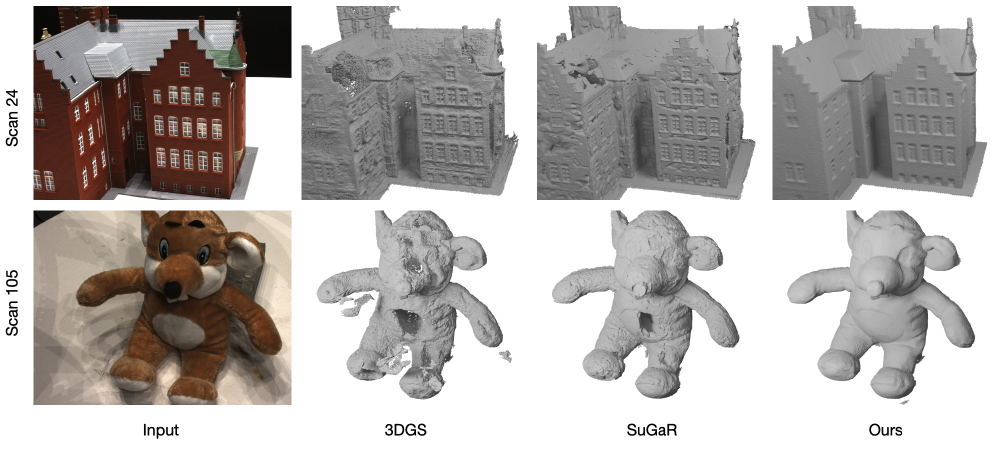
图5|输入、3DGS、SuGaR与2DGS。来源:原论文图5。
建筑表面和玩偶上的噪声减少,与两项正则的设计相呼应。不过,平滑得更好不自动表示所有细节都更准确,仍要结合参考几何与完整性指标。
十一、更大场景与图像指标,呈现的是另一组取舍
在Tanks and Temples上,结果没有变成2DGS全面领先。
| 方法 | 平均F1 ↑ | 时间 |
|---|---|---|
| NeuS | 0.38 | >24小时 |
| Geo-Neus | 0.35 | >24小时 |
| Neuralangelo | 0.50 | >24小时 |
| SuGaR | 0.19 | >1小时 |
| 3DGS | 0.09 | 14.3分钟 |
| 2DGS | 0.32 | 15.5分钟 |
据原论文表2的平均与时间整理,F1同时反映阈值下的准确性与完整性。
2DGS明显改善了表中显式方法的几何,同时远快于这些隐式方法;但平均F1仍低于NeuS、Geo-Neus和Neuralangelo。它的优势应结合重建质量与时间共同理解。
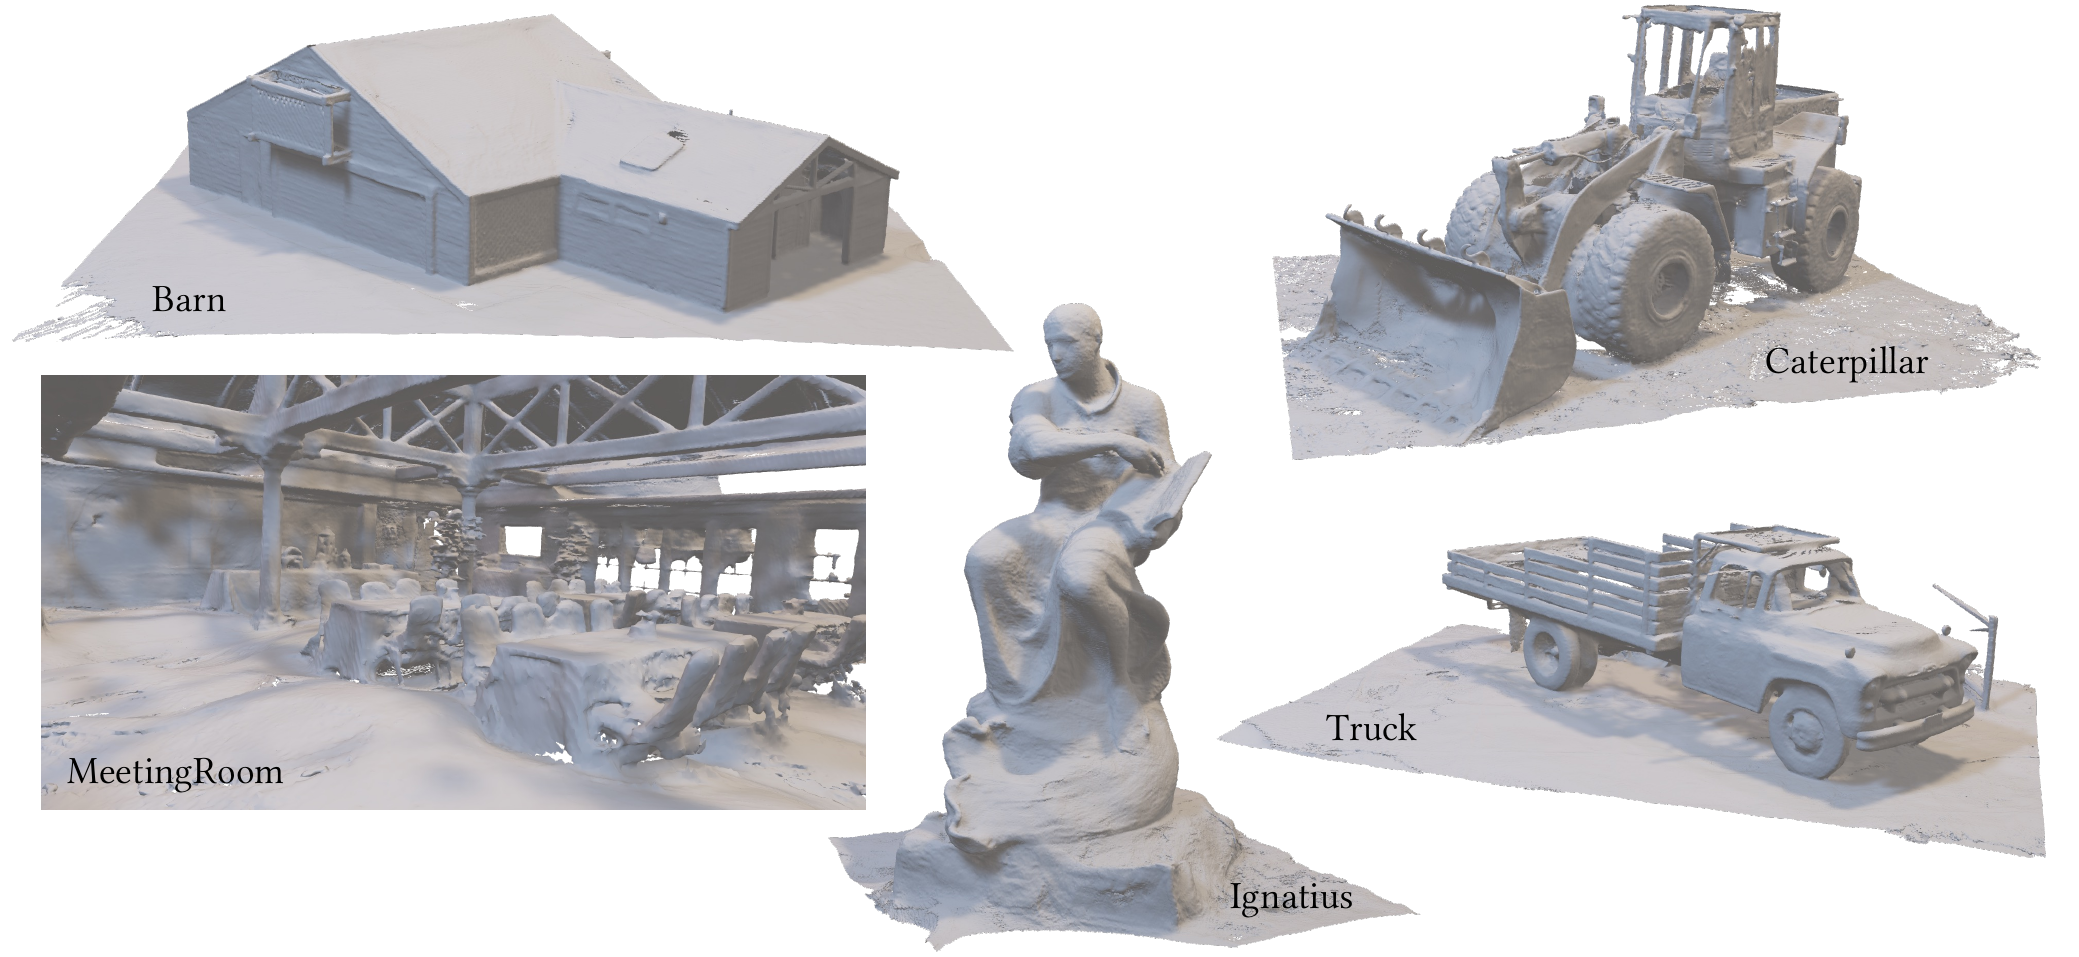
图10|Tanks and Temples中的仓房、机械、雕塑与室内场景。来源:原论文图10。
外观也有代价。DTU表3中,30k版2DGS的训练视角PSNR为34.52,低于3DGS的35.76;模型存储则从113 MB降到52 MB。这是相应实验中的资产大小,不能把52 MB当成任意场景固定大小。
Mip-NeRF360的测试视角结果更能反映新视角合成:
| 方法 | 室外PSNR ↑ | 室外SSIM ↑ | 室外LPIPS ↓ | 室内PSNR ↑ | 室内SSIM ↑ | 室内LPIPS ↓ |
|---|---|---|---|---|---|---|
| 3DGS | 24.64 | 0.731 | 0.234 | 30.41 | 0.920 | 0.189 |
| 2DGS | 24.34 | 0.717 | 0.246 | 30.40 | 0.916 | 0.195 |
据原论文表4选取;PSNR单位为dB。
2DGS的图像质量有竞争力,但在这组平均指标里均略逊于3DGS。本文更明确的收益,是改善深度、法线和网格,而非让所有渲染指标同步提高。
十二、消融实验能否把收益归因到具体设计?
原论文表5在DTU上以15k迭代检查正则和网格提取:
| 设置 | 准确性误差 ↓ | 完整性误差 ↓ | 平均误差 ↓ |
|---|---|---|---|
| 去掉法线一致性 | 1.35 | 1.13 | 1.24 |
| 去掉深度畸变 | 0.89 | 0.87 | 0.88 |
| 改用均值深度 | 0.88 | 1.01 | 0.94 |
| 改用SPSR提网格 | 1.25 | 0.89 | 1.07 |
| 完整模型 | 0.79 | 0.86 | 0.83 |
这张表说明,法线一致性在该设置中的影响较大,深度聚集和稳健深度选择也有收益。SPSR使用圆盘中心与法线提面,却不能同样利用圆盘大小和不透明度,因而弱于本文的深度融合路线。
附录表6又在30k迭代下拆开投影方式:仿射近似加均值TSDF的平均误差为1.08,改用本文求交光栅器后降到0.88,再用中位深度降到0.80。它为“只压薄高斯还不够”提供了更直接的证据。这里的30k结果与上面的15k消融分开读取。
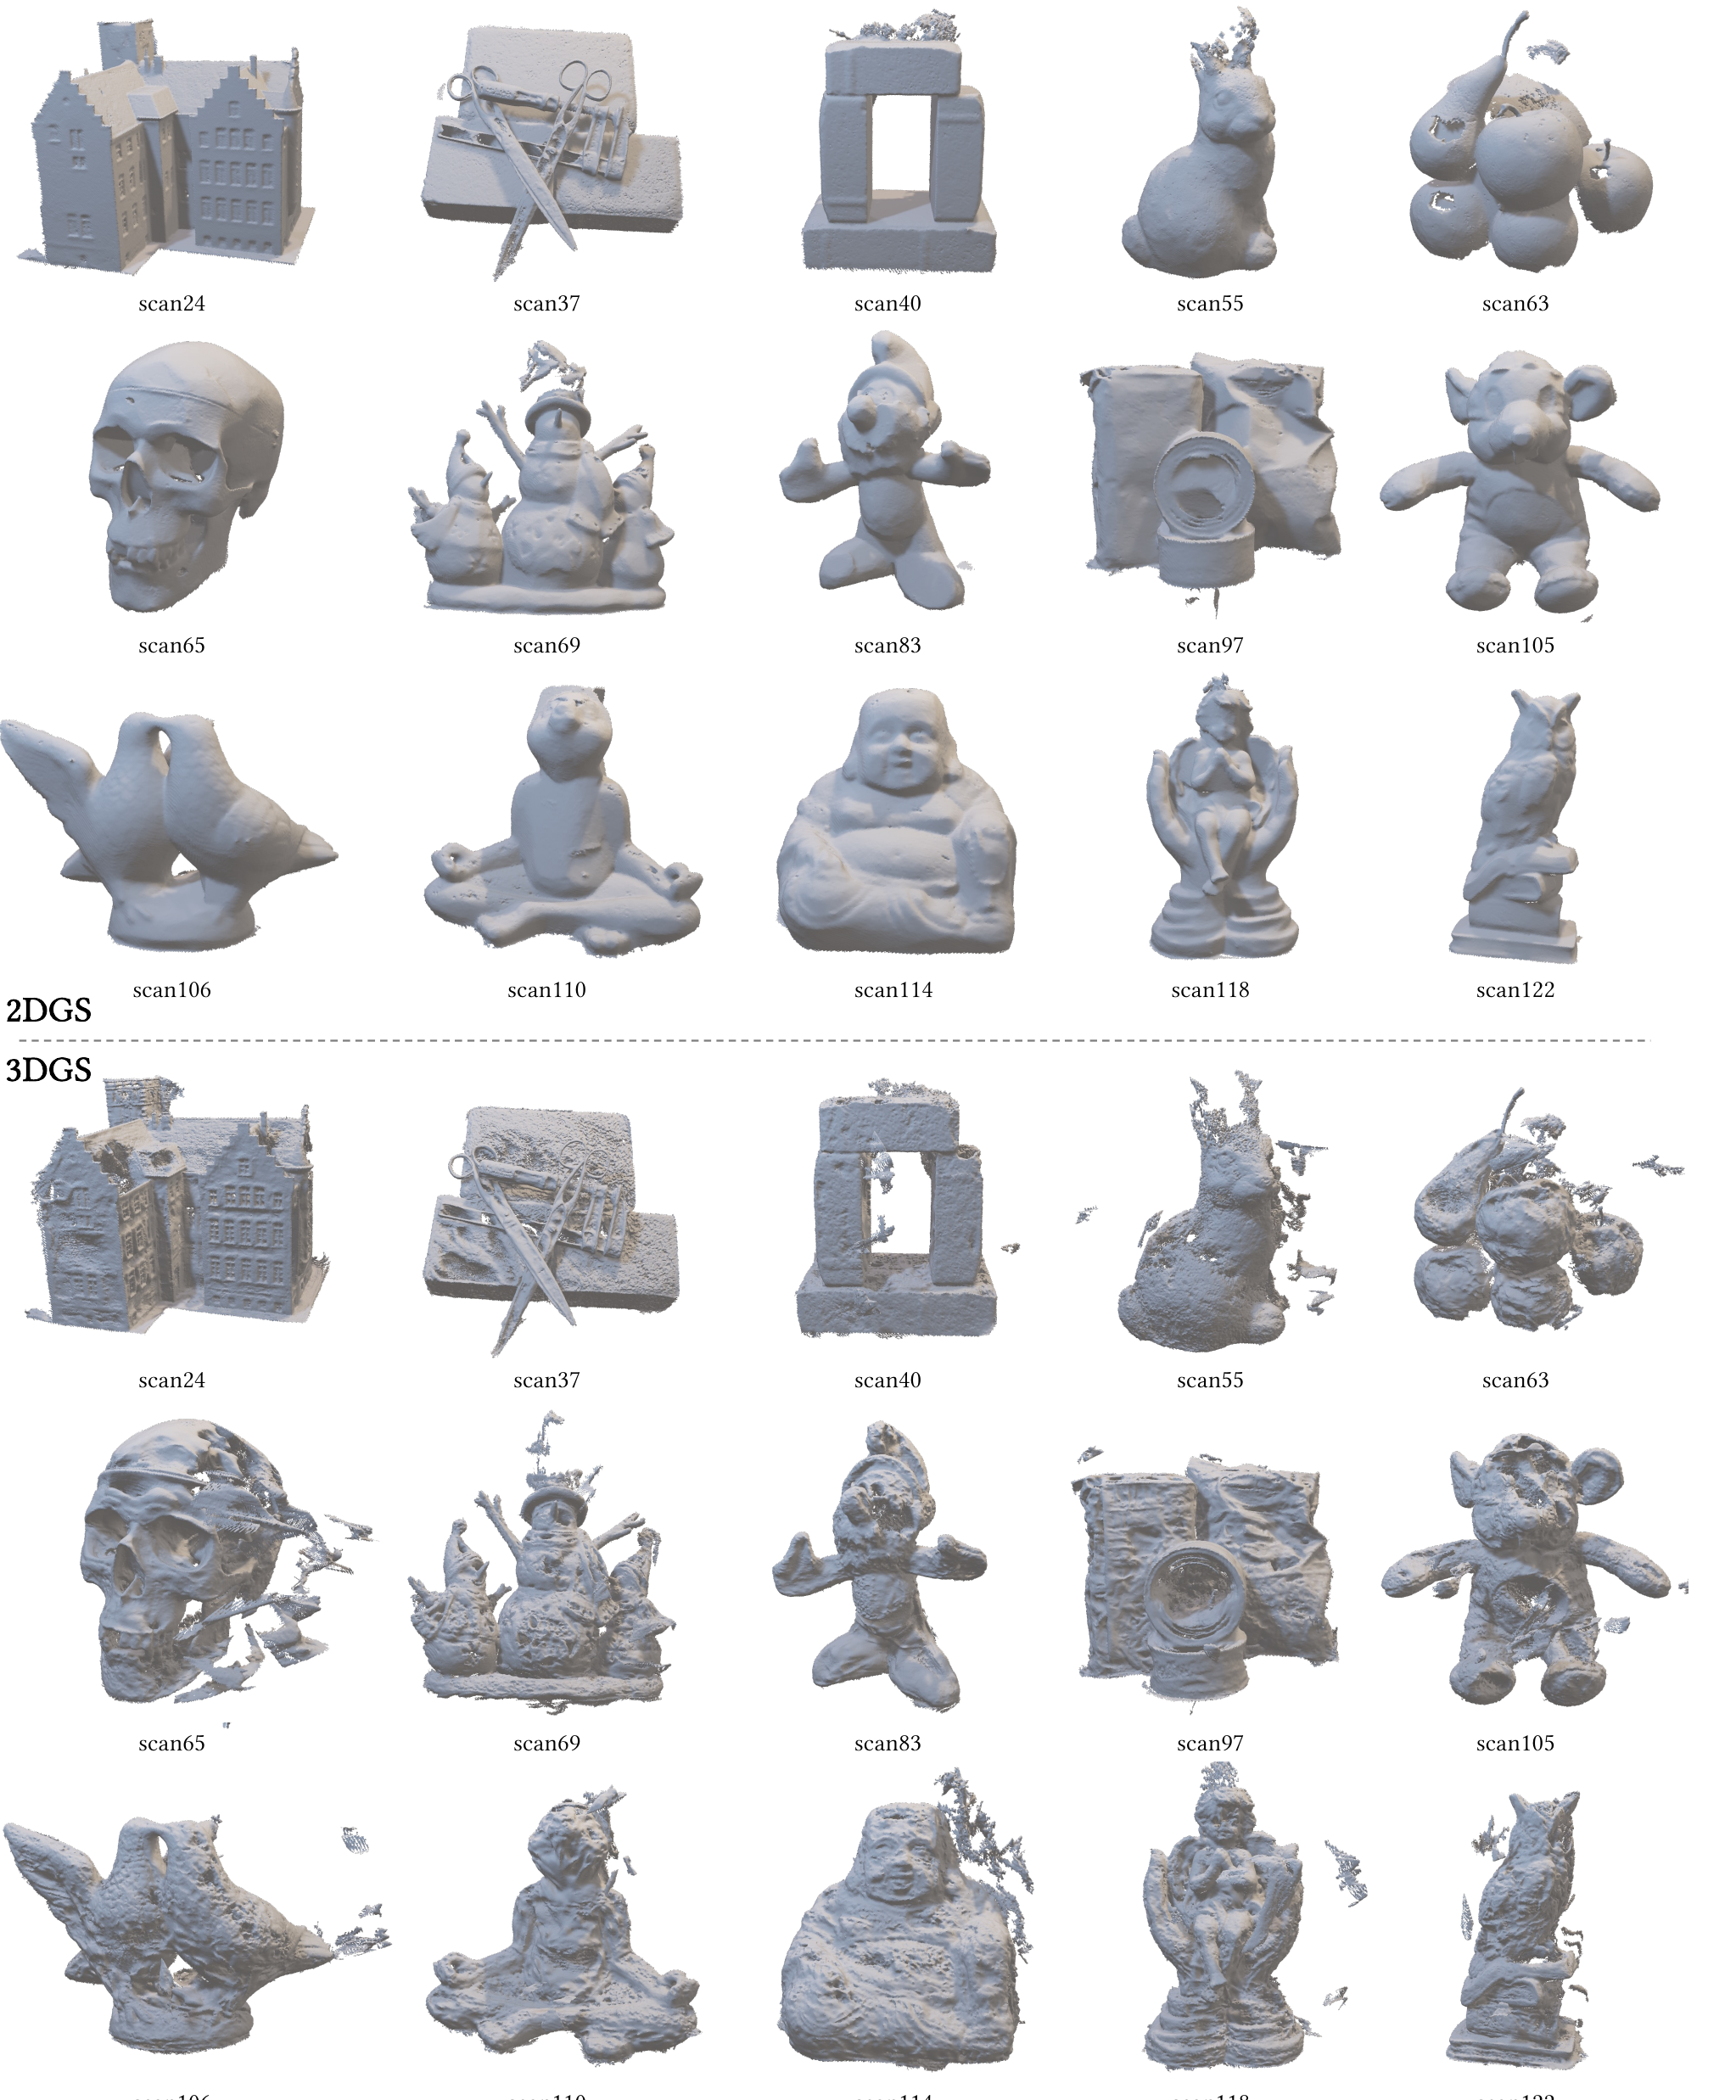
图9|上半为2DGS,下半为3DGS,均从深度图通过TSDF提取网格。来源:原论文图9。
两个方法采用同一类融合方式之后仍有明显差别,说明收益来自表示、渲染和训练约束的共同改变,而不只是事后换了一个提网格工具。
十三、对毛孔级人脸重建,有什么直接启发?
2DGS让基元带有明确切平面和法线,并将射线深度与表面朝向绑定起来。对于需要把偏振法线信息接入高斯表示的研究,这提供了一个清楚的接口:外部观测可以约束基元朝向,深度与法线的内部一致性则帮助避免两套几何各说各话。
这属于基于本文机制的研究延伸。原文输入是多视角RGB与稀疏点云,没有偏振测量,也没有人脸毛孔级评估。朝向更一致、网格更平滑,都不能替代细小凹凸的独立尺度验证。
作者还明确指出,当前增密更偏向纹理丰富的区域,未必能为几何细节丰富但颜色平坦的区域分配足够基元。这一点对皮肤尤其值得关注:毛孔形状不总能用强烈的颜色变化表示,单靠照片梯度决定增密位置可能遗漏关键结构。
同时,法线与深度正则也可能过度平滑。需要保留的微小起伏,与需要抑制的噪声,不能仅凭“表面看起来更平”来区分。
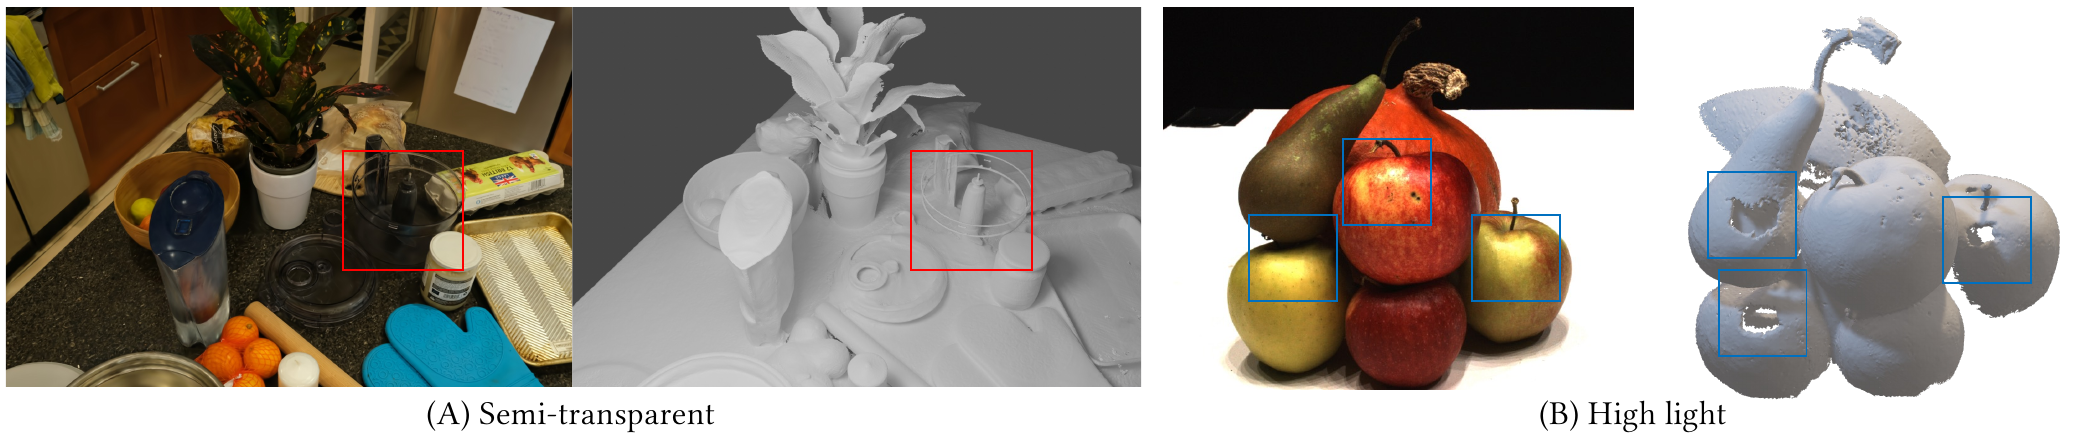
图12|玻璃等半透明材料难以准确恢复;强高光区域也可能出现孔洞。来源:原论文图12。
图12说明材料仍是重要边界。方法的提面流程以不透明表面为主要假设,对透射玻璃和强高光区域仍会失效。二维高斯改进了几何表达,没有自动完成材质、光照与透射的物理分解。
这篇工作的核心进展,是让高斯渲染更直接地承接“表面在哪里、朝向哪里”这两个几何问题。圆盘表示、透视求交、深度聚集与法线一致性共同工作,才让高效的新视角渲染进一步变成可提取、可评价的表面重建。
