
 洗子
 匿名

把一张脸做成三维模型,最难的往往不是让鼻子像鼻子,而是让皮肤看起来像皮肤。
脸型、五官和大致表情已经对了,放大后却仍然像塑料:额头没有随表情变化的细纹,鼻翼与面颊缺少不同的表面起伏,毛孔也只存在于颜色里。更麻烦的是,照片中的暗点不一定是凹陷。一颗痣、一根胡茬和一个毛孔,在图像上可能都很暗,却有着完全不同的几何含义。
这篇CVPR2018论文讨论的,就是如何从较容易获取的人脸纹理中,推断这些细小的三维结构。
作者先用Light Stage采集高质量的纹理与几何配对数据,再训练网络学习两者之间的关系。应用时,系统以一张UV纹理图和已有基础网格为起点,先分别预测皱纹等中频位移与毛孔等高频位移,再把高频部分超分辨率到4K,最后用组合后的位移图细化网格。
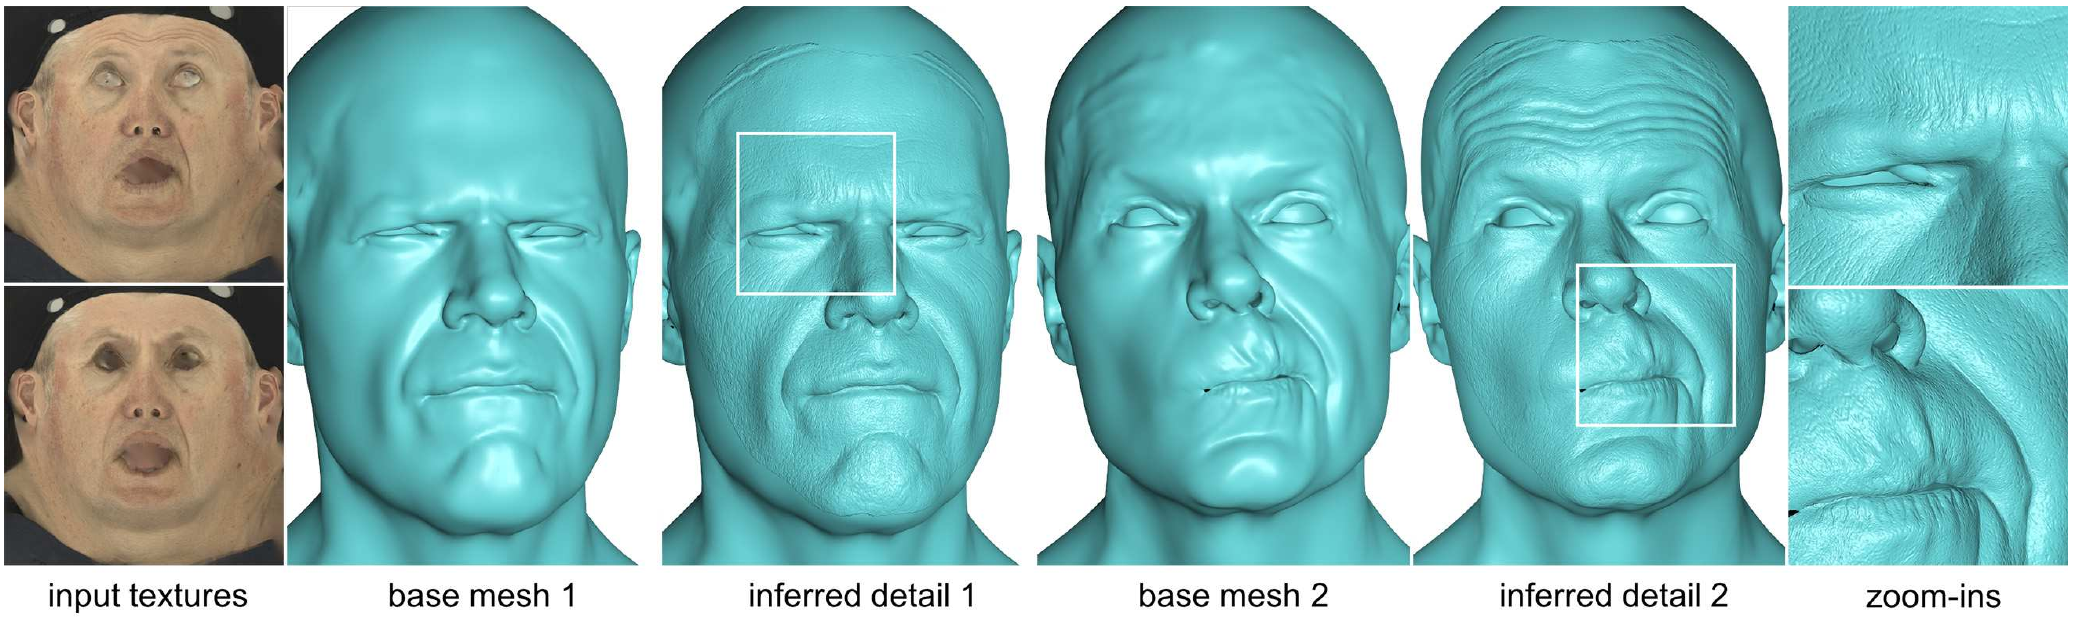
图1|相同人物在不同表情下的纹理、基础网格及推断细节。右侧放大图展示额头、眼周和口周的细小结构。来源:原论文图1。
这里的“介观几何”,可以理解为介于整体脸型与更微观皮肤结构之间、会明显影响外观的细小表面形状,包括细纹、毛孔和局部褶皱。
它的目标不是给一张脸随机铺上一层颗粒,而是让细节与面部区域、输入纹理及表情相适应。但这些细节来自学习推断,不能仅凭渲染清晰,就认定每一个毛孔的位置和深度都等同于直接测量结果。
论文信息
| 项目 | 内容 |
|---|---|
| 英文标题 | Mesoscopic Facial Geometry Inference Using Deep Neural Networks |
| 中文标题 | 使用深度神经网络推断人脸介观几何 |
| 发表 | CVPR 2018 |
| 作者 | Loc Huynh、Weikai Chen、Shunsuke Saito、Jun Xing、Koki Nagano、Andrew Jones、Paul Debevec、Hao Li |
| 机构 | USC Institute for Creative Technologies、University of Southern California、Pinscreen |
| 项目主页 | https://vgl.ict.usc.edu/Research/MFG/ |
| 论文入口 | https://openaccess.thecvf.com/content_cvpr_2018/html/Huynh_Mesoscopic_Facial_Geometry_CVPR_2018_paper.html |
| 代码 | 项目主页未列出公开实现入口 |
| 关键词 | 人脸细节、位移图、条件GAN、U-Net、多尺度学习、超分辨率、Light Stage |
一、为什么“暗的地方更深”会把人脸做错?
一条皮肤褶皱可能因为遮蔽或方向变化而变暗,所以从明暗估计细节,是一个很自然的思路。早期的一些人脸细化方法,便使用类似“dark is deep”的假设:把较暗的纹理解释成较深的表面。
问题是,颜色变化与形状变化在照片中混在一起。
| 图像中的暗区域 | 可能的来源 | 若直接解释为凹陷会怎样 |
|---|---|---|
| 痣 | 色素或局部外观差异,也可能伴随形状变化 | 把颜色本身压成一个坑 |
| 胡茬 | 毛发及其遮挡、反射 | 将毛发误刻进皮肤 |
| 毛孔 | 细小几何与局部遮蔽共同作用 | 形状与深度仍可能被估错 |
| 眉毛 | 密集毛发形成的暗纹理 | 在眉区生成错误的几何起伏 |
因此,想让模型区分它们,就不能只告诉模型“哪里更暗”,还需要让它见过“这类纹理实际对应什么形状”。
作者采用的监督数据来自偏振梯度照明下的Light Stage扫描。它提供较高质量的漫射照明纹理与细节几何,让网络学习纹理、位置、上下文和形状之间的关系。
这里有一个重要的前后分工:训练数据依赖专业采集设备,训练完成后的细节推断则不需要重新执行同样复杂的主动照明扫描。 专业扫描的价值被转移到了训练样本中。
这也解释了论文为什么不把“少拍几张照片”作为唯一重点。它更关心的是:怎样让网络从有限的高质量扫描中学到可迁移的皮肤几何知识,同时避免把色素与凹凸混为一谈。
二、完整流程:先得到一张皮肤地图,再补两层几何
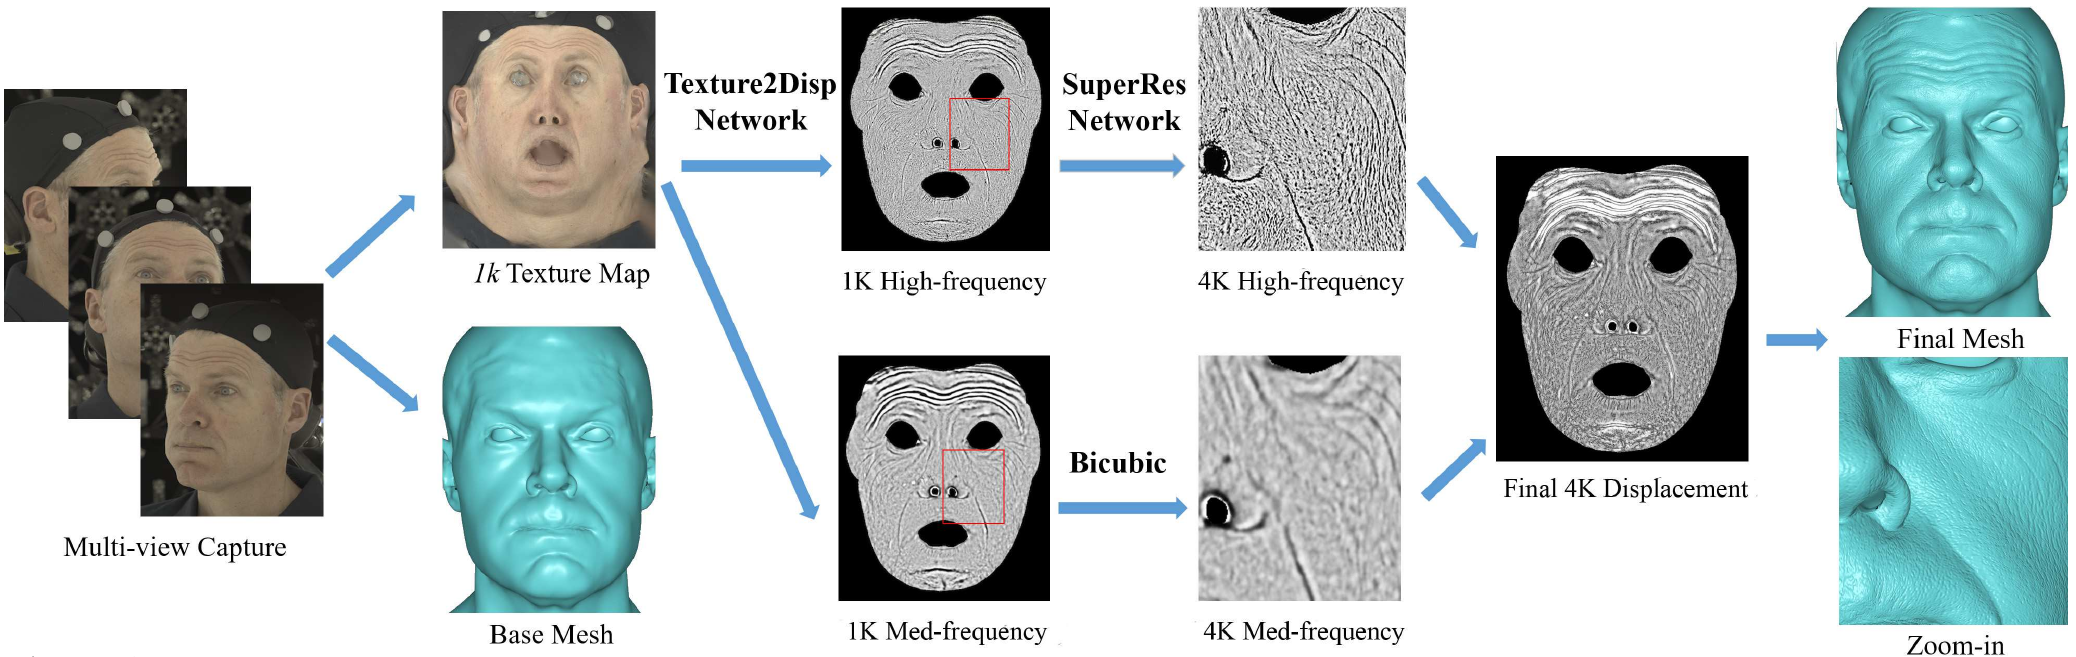
图2|多视角图像生成基础网格与1K纹理;Texture2Disp预测两类1K位移;高频部分经SuperRes提升到4K,中频部分用双三次插值放大,最后组合并作用到网格。来源:原论文图2。
系统的起点不是一个完全没有三维信息的像素数组。作者首先利用已有多视角人脸重建流程,获得基础面部网格,并拟合具有一致拓扑的模板,再生成一张1K分辨率的UV纹理图。
UV图可以理解为把人脸表面展开成二维地图。鼻子、眼周、额头等区域在地图中有相应位置,便于把不同人物与不同表情的观测放到相近的坐标体系中。
输入纹理在均匀、较平坦的照明条件下获取,以减少复杂光照对学习的干扰。它不是任意环境下、无需处理的原始自拍,也不应直接等同于已经严格分离所有阴影的物理反照率图。
进入学习模块后,流程分成两步:
- 纹理到位移。 从1K纹理预测两张1K位移图,一张负责中等尺度形状,一张负责更细的起伏。
- 高频超分辨率。 将高频位移进一步细化为4K;中频位移则采用普通插值放大。两者组合后,形成最终4K位移图。
所以,基础网格负责整体脸型与大范围表情,位移图负责基础网格之外的细小形状。网络不需要从头重新预测每一个三维顶点。
三、位移图:为什么一张灰度图能控制三维皮肤?
直接预测大量三维顶点,既占内存,也不便利用当时成熟的二维卷积网络。位移图把问题转成了二维图像预测。
在UV图的每个位置存一个数,表示对应表面点需要发生多少细小位移。图像看起来像灰度纹理,保存的却是几何量。
为理解它如何作用于网格,可以写出下面的示意关系:
$$ \mathbf{ x }'(u,v) =\mathbf{ x }_0(u,v)+D(u,v)\mathbf{ n }_0(u,v). $$
$\mathbf{ x }_0$是基础表面位置,$\mathbf{ n }_0$是其法线方向,$D$是该位置的位移,$\mathbf{ x }'$是细化后的表面位置。也就是沿基础表面方向,把某些位置略微推高、另一些位置略微压低。
这是一种帮助理解标量位移的几何表达,不是原论文提供的编号公式。论文重点说明了位移表示、网络分解与训练过程,并没有列出一组完整的编号数学模型。
位移图有两个实际好处。
首先,相比直接保存每点三维坐标,它用单通道就能表达细节残差。其次,在统一UV体系中,网络既能看到局部皮肤纹理,也能利用额头、鼻翼、面颊等区域的上下文。
当然,4K位移图不等于基础网格已经具备足以表达全部微细节的顶点密度。要把细小位移变成可显示或可导出的几何,后续网格细分与渲染也需要足够的采样密度。
这张图保存了细化表面的信息,而最终能呈现多少信息,还取决于如何应用它。
四、关键观察:不是毛孔太少,而是它的数值太小
如果已经有真实位移图,直接训练“纹理→完整位移”不就行了吗?
作者发现,这样做容易学不到细节。原因不只是网络容量,而是不同尺度位移的动态范围相差很大。
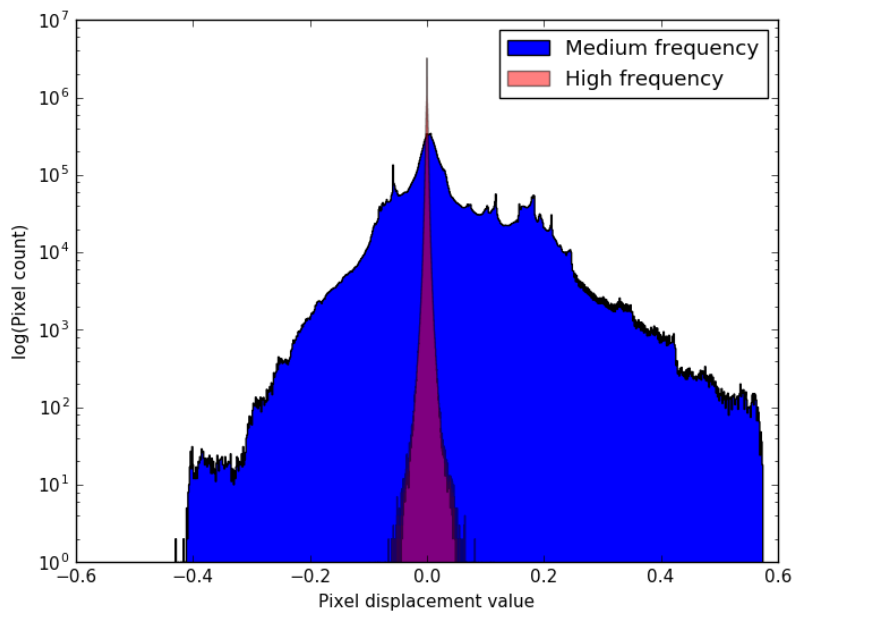
图3|蓝色中频位移分布较宽,红色高频位移集中在很窄的数值区间。纵轴采用对数像素计数。来源:原论文图3。
额头褶皱、面部局部形变带来的位移,与毛孔等细小起伏,并不处在相同的数值尺度上。如果把它们混成一张图训练,网络即使漏掉很多毛孔,只要把大幅度结构预测得差不多,整体损失仍可能相对较小。
可以用一个简单的误差分析理解这种现象。假设某些像素的位移误差为$e$,平方误差项就是$e^2$;在其他条件相同时,幅值相差10倍的误差,其平方项便相差100倍。
这只是说明动态范围如何影响学习的例子,不是说本文实际使用了这一项作为完整训练目标。它说明:小幅度细节并不会因为视觉上重要,就自动在数值优化中获得同样高的权重。
作者的处理方式是先分解真实位移,再分别学习。
根据论文文字过程,可以写为:
$$ D_L=\mathcal{G}(D), \qquad D_H=D-D_L. $$
$D$是原始位移图,$\mathcal{G}$是高斯滤波,$D_L$是滤波得到的较平滑分量,$D_H$是相减后留下的高频残差。这是对原文操作的数学整理;其中残差关系也在原文中明确写出。
注意,下标$L$在本文的分解中对应相对低频的一支,但作者将其称为中频几何。更大尺度的整体脸型已经交给基础网格,因此不应把这一支误解成“重新预测整张脸”。
实现中,作者在4K位移上选用大小为29的高斯滤波核,经验上能较好分离所需细节。原文没有把29写成高斯标准差,也没有给出一个可通用于所有人脸与UV布局的物理尺度阈值。
五、分开以后,还要让两类数值都适合学习
只分成两张图,仍不足以保证小幅度残差被有效学习。作者还进行了数值变换。
高频位移整体放大64倍,让原本挤在狭窄区间中的细小变化,能在有限的像素编码范围内更充分展开。中频位移的变化范围更宽,则用sigmoid变换压入适合的像素范围,避免直接截断较大的位移值。
64倍改变的是学习时的数值表示,不是把真实毛孔放大64倍。最终组合位移时,需要回到兼容的位移尺度;不能把训练编码直接当成真实几何使用。
这一步与高斯分解解决的是不同问题:前者让两类结构不再互相挤占同一个预测任务,后者让各自的数值范围更容易被网络利用。
因此,这篇方法的多尺度处理同时涉及空间频率和数值幅值。 它不是仅仅把图像缩成几种大小,再让网络自己决定关注什么。
六、Texture2Disp:让网络看局部,也知道自己在脸的哪里
纹理到位移模块包含两个分支,两者接收同一张1K纹理,分别预测中频与高频位移。
为便于理解,可以将其输入输出关系写成:
$$ \hat D_L=F_L(T), \qquad \hat D_H=F_H(T). $$
$T$是输入纹理,$F_L$与$F_H$表示两个预测分支,帽号表示预测结果。这些符号用于归纳数据流,不是原文另列的公式。
两个分支采用条件GAN与带跳跃连接的U-Net结构。
1. U-Net:保留位置线索,也汇集较大范围上下文
编码过程逐渐汇集特征,使网络能够判断较大范围的形状与纹理模式;解码过程恢复空间分辨率。跳跃连接把较浅层的局部信息传给相应的解码层,减少细节在压缩过程中丢失。
这对皮肤细节尤其重要。一处暗点应该如何解释,不仅取决于那个像素有多暗,还取决于周围纹理、所在面部区域以及其他样本中的形状关系。
网络因此有机会区分:面颊上的局部色素、鼻翼附近的毛孔,以及口周的胡茬,并不应该使用同一种“压低表面”的规则。
2. 条件GAN:除了逐像素接近,还要具有合理的局部结构
如果训练只追求逐像素接近,而输入本身不足以唯一确定细节,模型很容易在多种可能结果之间折中,输出偏平滑的表面。
条件GAN通过对抗训练,让生成结果除了与输入相关,还需要在局部形态上接近真实扫描的位移。论文采用按局部图块判断真假的判别器,并在空间位置之间共享权重,以学习可重复出现的皮肤结构。
这并不保证模型推断的每个小坑就是原来那一个小坑。对抗学习帮助结果接近真实细节的分布,几何监督则提供与扫描结果对齐的约束;两者的意义不能混为“已经直接测量全部细节”。
原文说明了条件GAN、U-Net和局部判别器的设计,但没有在正文列出完整损失公式与所有权重。因此这里不把通用GAN目标擅自写成这篇论文的具体训练公式。
七、为什么先预测1K,再把高频提升到4K?
即使学到了正确类型的起伏,如果最终位移图分辨率不够,毛孔也可能只占不到几个像素,无法支撑近距离渲染。
作者认为,其设置下至少需要4K位移图,才能表达目标的皮肤细节。但直接对4K整张人脸运行当时的图像翻译网络,计算与显存负担较重。
因此,他们先做1K的整体推断,再把更需要高分辨率的高频部分交给图块超分辨率网络。中频结构已经在较低分辨率下得到表达,实验中使用双三次插值放大即可。
超分辨率训练由4K真实位移生成对应的1K低分辨率样本,从中抽取成对图块:
$$ 64\times64\ \longrightarrow\ 256\times256. $$
这是宽、高各放大4倍,输出像素数量变为16倍。网络学习的不是简单复制像素,而是低分辨率几何模式与高分辨率扫描结构之间的对应关系。
作者采用基于子像素卷积的超分辨率网络。其基本思路是先在低分辨率特征中计算,再把不同通道的信息重新排列到更密集的空间网格,而不是一开始就让所有计算发生在4K图像上。
测试时,系统将高频位移分成规则的$64\times64$图块,分别生成$256\times256$结果,再使用image quilting进行图块拼合,以改善边界处的一致性。
这里“超分辨率”增加的是由训练数据约束的高频结构。它可以改善表面细节的表现,但不能从已经缺失的信息中无条件找回某个人所有真实微结构。
最终的组合过程可以概括为:
$$ \hat D_{4K} =\operatorname{Bicubic}(\hat D_L) +\operatorname{SuperRes}(\hat D_H). $$
该式是数据流示意,默认两分支已恢复到兼容的物理位移尺度。实际实现还包括数值编码的还原和图块拼合,不能把它当作可以跳过这些步骤的完整复现代码。
八、消融图说明:分频与超分分别补上了什么?
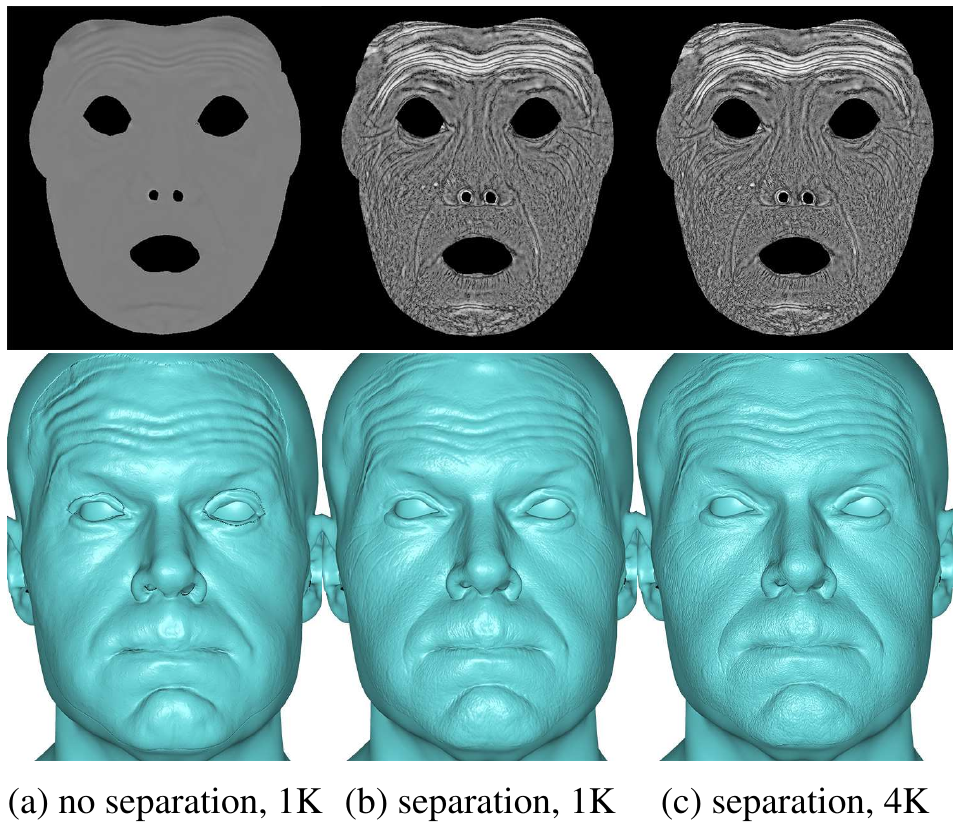
图4|左列不分频、输出1K;中列分频、输出1K;右列分频并提升到4K。上排为位移图,下排为几何效果。来源:原论文图4。
这张图需要分两次比较。
先比较左列与中列。输出同样是1K,改变的是是否分开学习中频与高频。未分频结果丢失了许多细小结构,中等尺度也出现不理想的起伏;分频之后,主要形状与细微纹理能够同时保留。
再比较中列与右列。分频策略相同,改变的是高频超分辨率。4K结果表现出更丰富、更清晰的介观皮肤结构。
这两组比较对应两种瓶颈:分频帮助网络学到原本容易被忽略的小幅度变化;超分辨率则让这些变化在输出空间中有足够的采样密度。
如果第一步根本没有学到合理细节,单纯把输出变大并不能解决问题;如果输出采样太粗,已经学到的细节也难以充分呈现。
九、训练数据和耗时:专业扫描的知识如何被复用?
论文使用328组配对Light Stage扫描,来自19名训练受试者,年龄为11—56岁,并包含同一人物的多种表情。另用6名受试者测试系统性能。
328不是328名不同的人,而是扫描样本数。多表情数据让网络看到同一张脸在不同状态下的纹理与几何变化;统一UV则帮助模型将不同样本中的相似面部区域联系起来。
它不要求不同人物的毛孔逐个一一对应,因为跨个体并不存在有意义的“同一个毛孔”。但训练仍依赖经过仔细处理的纹理与位移配对,以及大致一致的面部区域对应。
在论文使用的12GB显存Titan X上,作者报告了以下耗时:
| 环节 | 原文报告 |
|---|---|
| 纹理到位移网络训练 | 约8小时 |
| 超分辨率网络训练 | 不到2小时 |
| 由1K纹理得到两张1K位移 | 约1秒 |
| 得到最终4K位移 | 约5秒 |
这些数字反映的是文中环境下的细节学习与生成流程。它们不能直接当作从相机拍摄、标定、多视角重建到最终网格的全部端到端耗时,也不能据此宣称系统已经实时运行。
十、不同人物和表情:细节是否真的跟着输入变化?
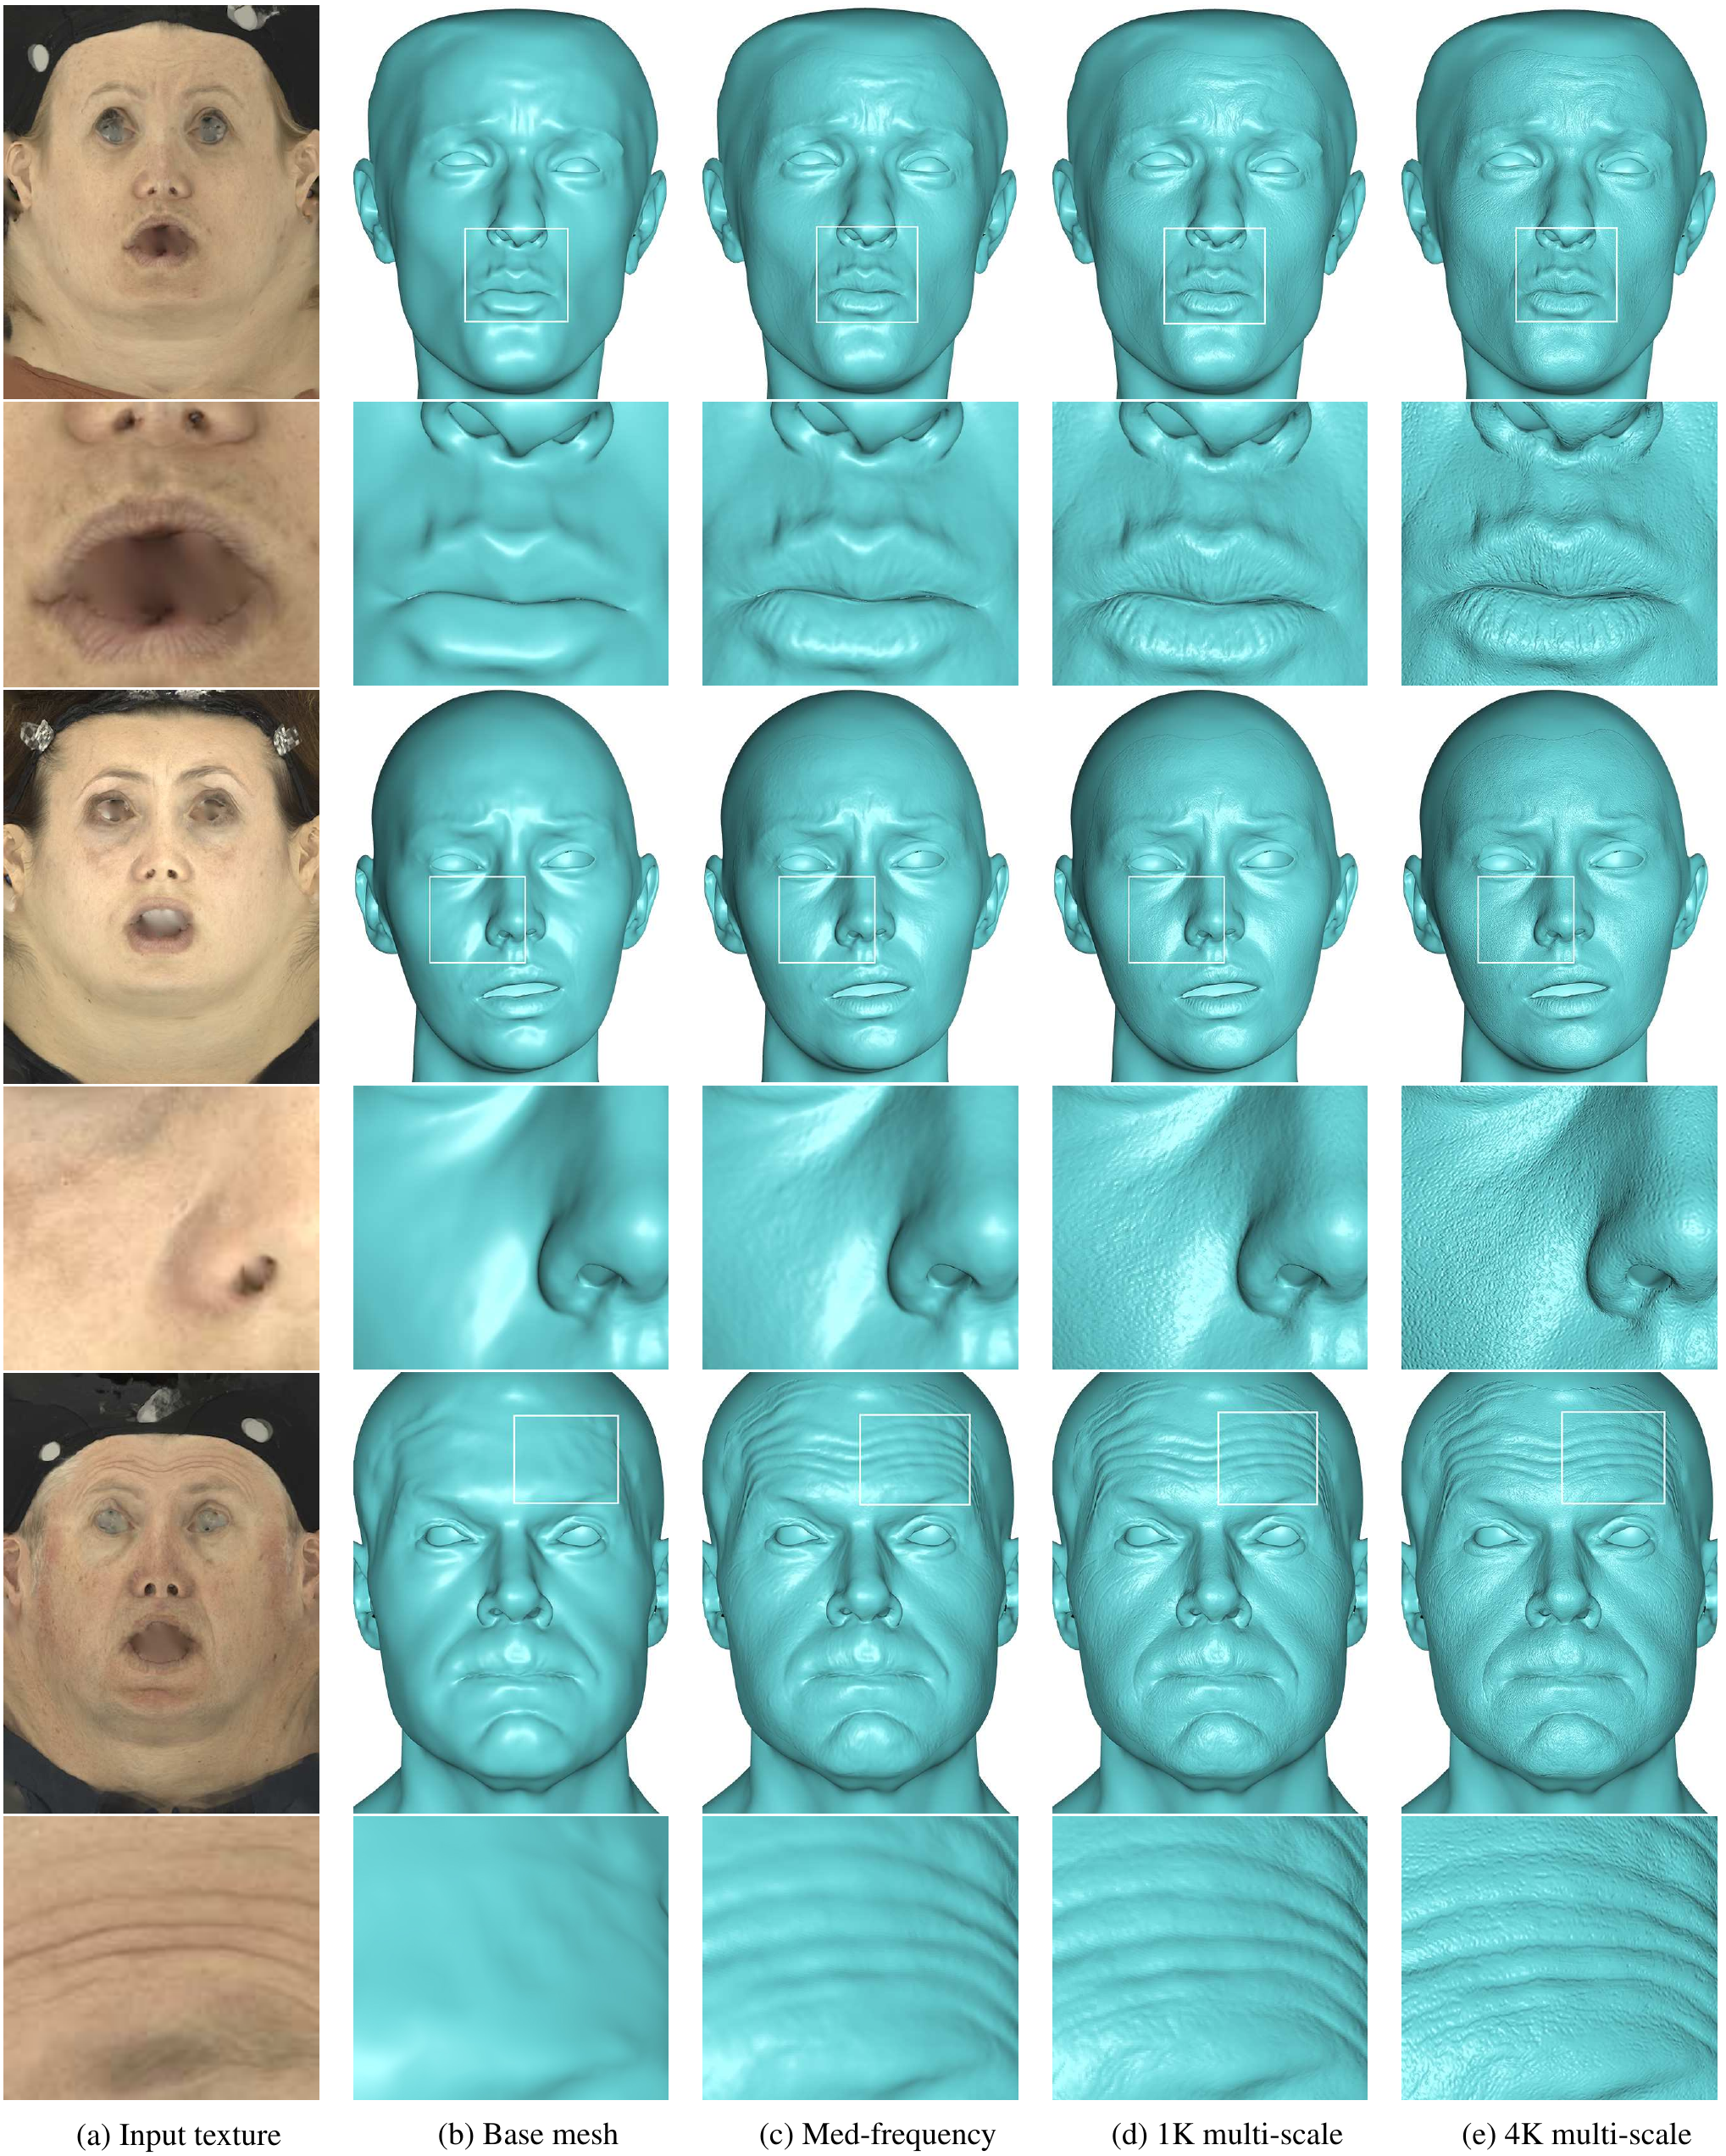
图5|从左到右为输入纹理、基础网格、仅中频几何、1K多尺度几何、4K多尺度几何。每组下方展示相同区域的放大结果。来源:原论文图5。
这张长图把输出逐层展开。
基础网格保留了脸型和主要表情,但皮肤比较平滑。加入中频后,口周、额头等区域的大一些的褶皱更加明显。组合高频之后,表面进一步出现细小起伏;到4K阶段,这些结构在局部放大中更清楚。
为了便于手机上比较,可以单独看额头区域:
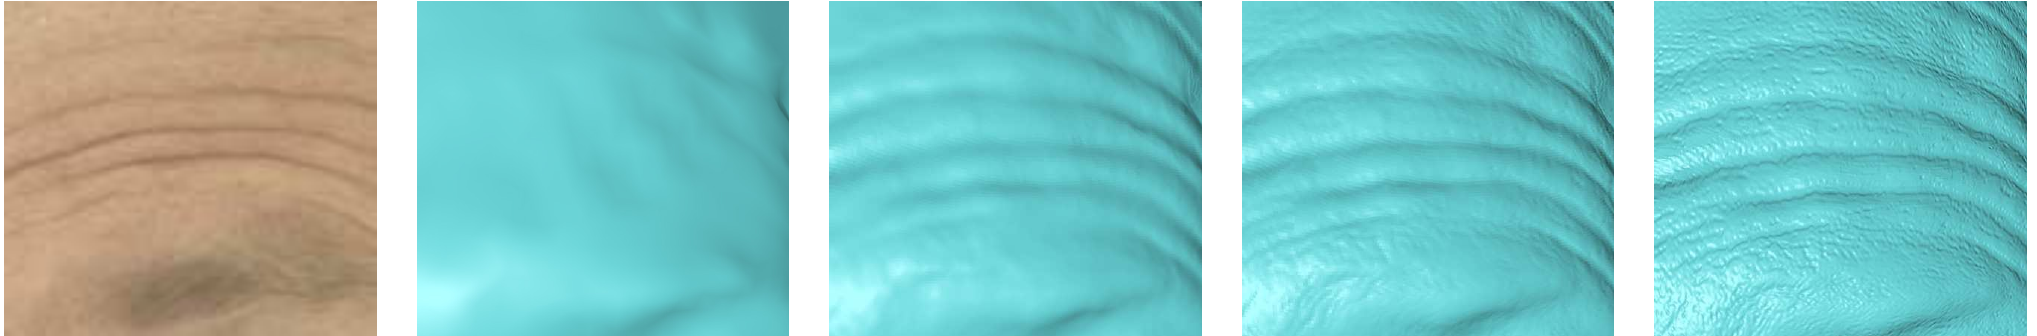
图5局部|列顺序与完整图相同。中频主要补充褶皱形状,高频与超分辨率进一步补充其表面的细纹和皮肤起伏。来源:原论文图5局部。
作者说明,展示的测试人物没有用于训练。这支持网络能够迁移到训练集之外的部分人物和表情,而不是只记住某几张训练纹理。
但测试覆盖仍然有限。不同年龄和肤色的示例能够说明一定适用范围,不能替代更大规模、分人群的系统误差评估。
十一、与“暗即深”比较:重点看痣、胡茬和局部表面差异
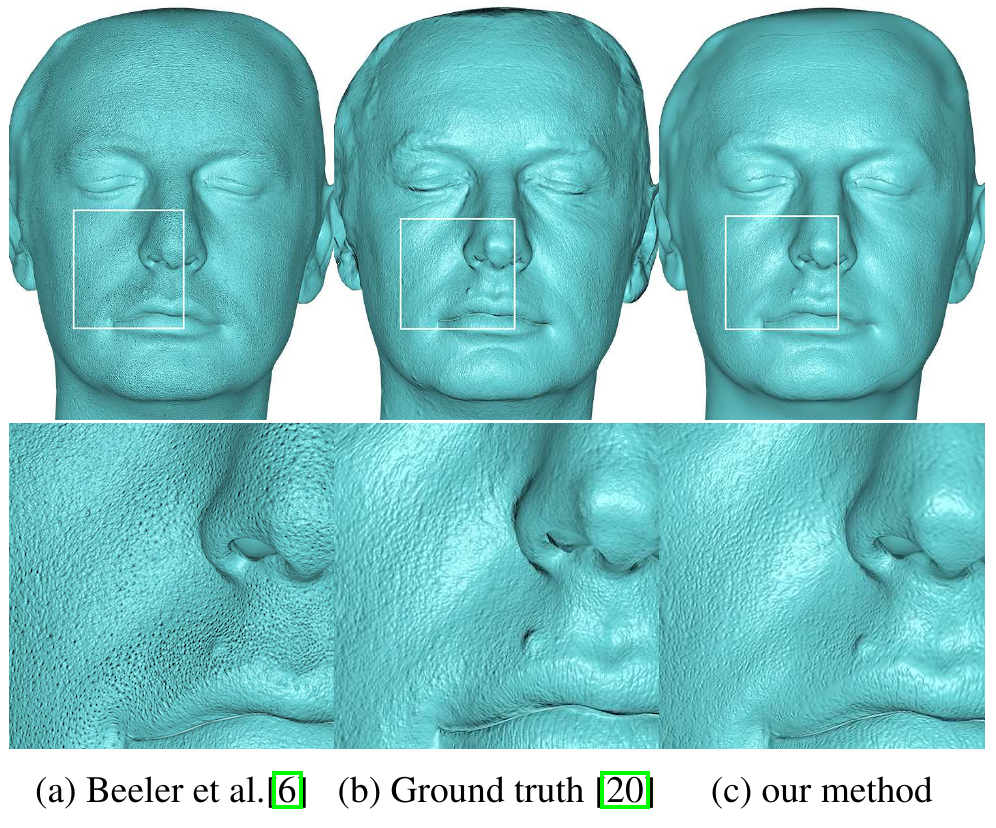
图6|左列为既有细节推断结果,中列为Light Stage扫描参考,右列为本文结果。鼻部、面颊和口周放大图用于比较不同区域的起伏特征。来源:原论文图6。
论文指出,本文结果与扫描参考在鼻尖与面颊的表面起伏差异、上唇附近痣的几何表现上更一致。这里比较的是几何表面纹理,不是独立估计了一张BRDF粗糙度材质图。
这与训练设计形成呼应:当网络能够利用面部上下文及扫描监督,就不必将所有暗纹理都解释为相同类型的凹陷。
作者进一步用位移误差图进行比较。
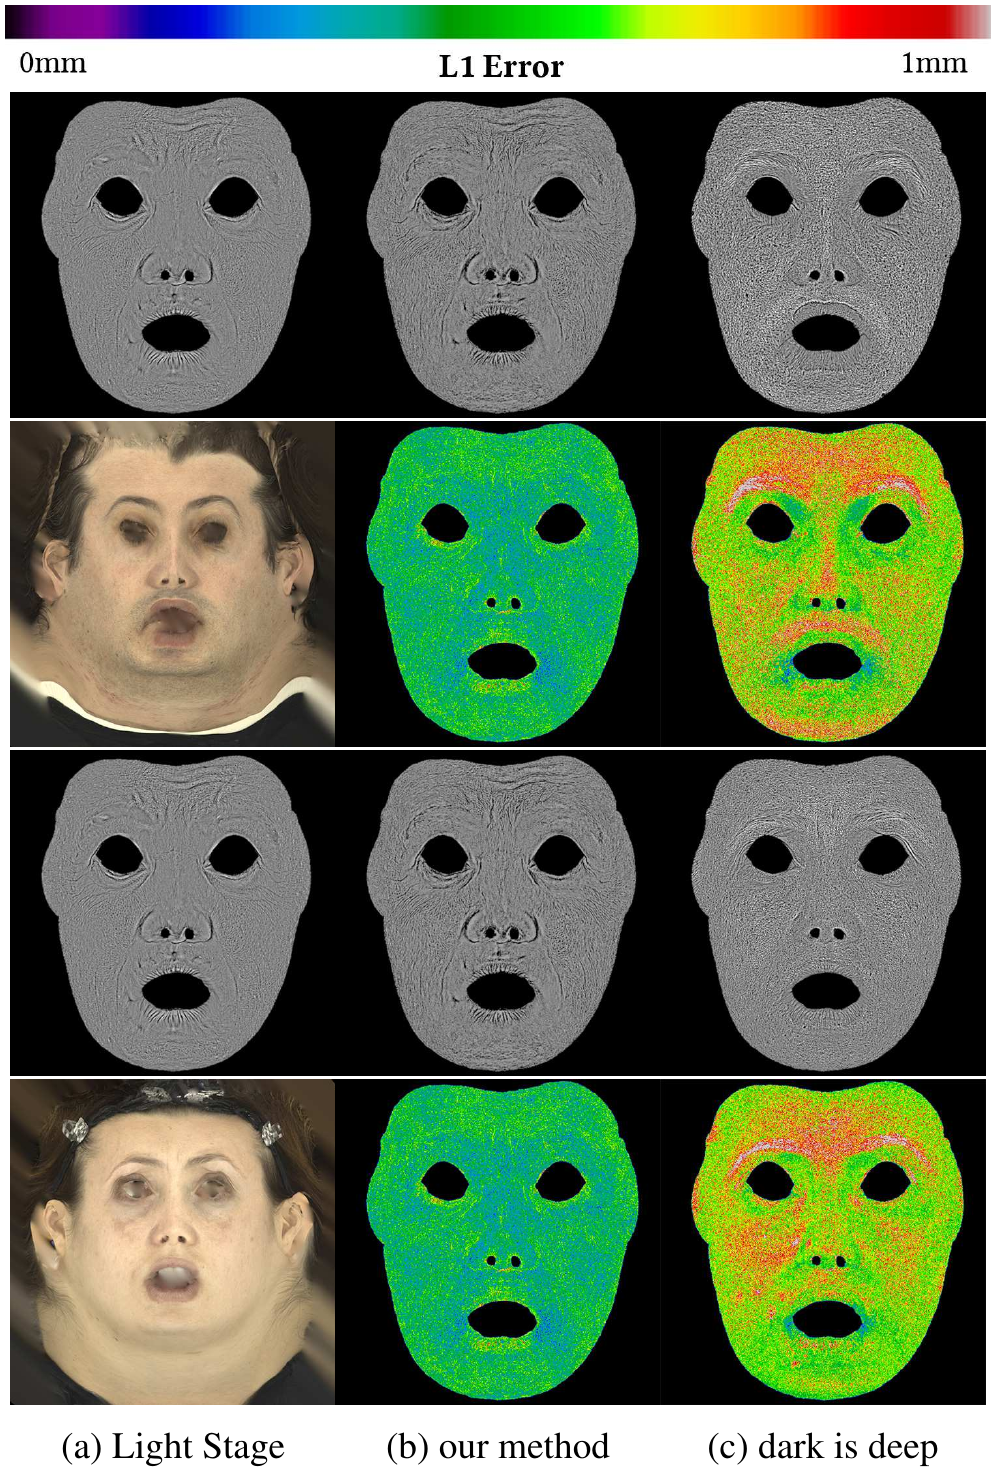
图7|三列分别为Light Stage参考、本文方法和“dark is deep”方法。彩色图表示与参考位移的L1误差,图示色标从0到1毫米。来源:原论文图7。
按原文定义,误差是在对应UV位置上比较预测位移与Light Stage位移。对于单个像素,可写为:
$$ e(u,v)=|\hat D(u,v)-D_{\mathrm{ref}}(u,v)|. $$
这只是对论文所述L1误差的展开。它衡量同一位置的位移差,不是两份任意网格之间的Chamfer Distance,也不是法线的角度误差。
图中,胡茬、眉区等容易把颜色与几何混淆的位置,在传统启发式方法中出现较明显误差。本文方法的误差相对更低,支持其在这些区域更稳健的结论。
但色标上限为1毫米,不代表本文平均误差就是某个固定的亚毫米数值。主文没有给出一张全测试集的位移均值误差表,也没有逐项报告毛孔定位、深度或轮廓准确率,因此不能替图表补造这些数值。
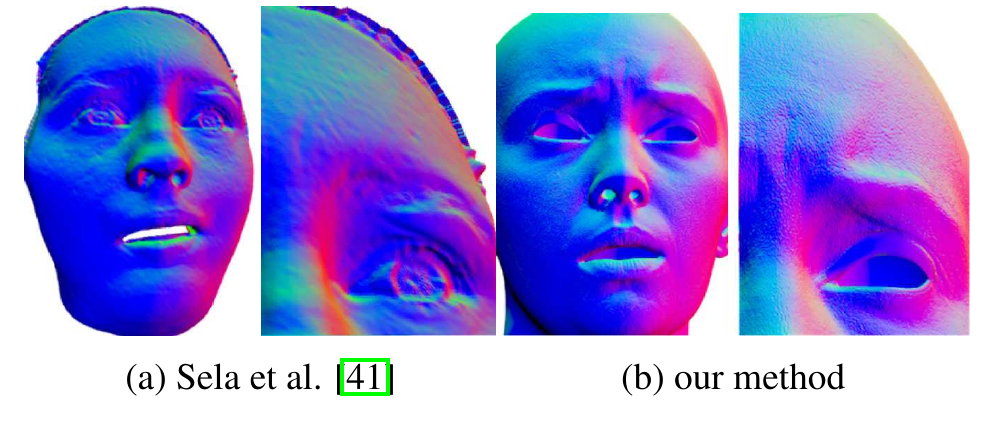
图8|本文与Sela等方法的法线图比较,右侧结果具有更丰富的局部方向变化。来源:原论文图8。
这张图说明两类方法表达细节的差别。Sela等方法从图像推断深度与对应,再进行几何细化;本文则直接以扫描位移中的细节为监督目标。图中的清晰程度支持视觉比较,但不能单独替代统一协议下的几何准确性统计。
十二、用户觉得它像真人吗?Light Stage仍然领先
作者还进行了一次不带皮肤颜色纹理的几何真实感排序实验。三类结果分别来自本文、Light Stage扫描,以及“dark is deep”方法。它们采用一致的头部朝向并随机排列,减少显示方式造成的偏差。
实验使用6个测试人物的渲染,25名参与者一共提交58份回答。原文报告的“最真实”选择比例为:
| 结果来源 | 被选为最真实的比例 |
|---|---|
| Light Stage | 67.2% |
| 本文方法 | 20.7% |
| “dark is deep” | 12.1% |
这个结果很有分量,因为它没有把“看起来接近专业扫描”写成“已经与专业扫描没有差别”。Light Stage仍然占明显优势;本文在这个小规模研究中,相比启发式细节推断获得了更多最真实选择。
同时,25名参与者与58份回答不是同一个统计量,不能把这些比例直接换算成25人中的人数。这是一项有限规模的感知研究,也不等同于几何测量精度评估。
十三、动态视频和普通照片:可以延伸到哪里?
1. 动态结果依赖稳定输入,而不是额外的时序网络
作者报告,将方法逐帧应用到表情序列时,可以得到较稳定的动态位移,并在补充视频中展示变化的皱纹与毛孔。
主文描述的网络是逐帧预测,并没有额外给出循环网络或时序损失。不能因为论文称结果具有时间一致性,就反推它使用了某种没有说明的时序约束。
从方法流程看,一致拓扑与UV有助于让同一块皮肤在不同帧保持可比的位置,而输入纹理随表情的变化,则为动态细节提供线索。这是理解结果的一条合理路径,仍不等于对所有视频、快速运动和遮挡都提供稳定性保证。
2. 无约束照片需要额外的纹理处理
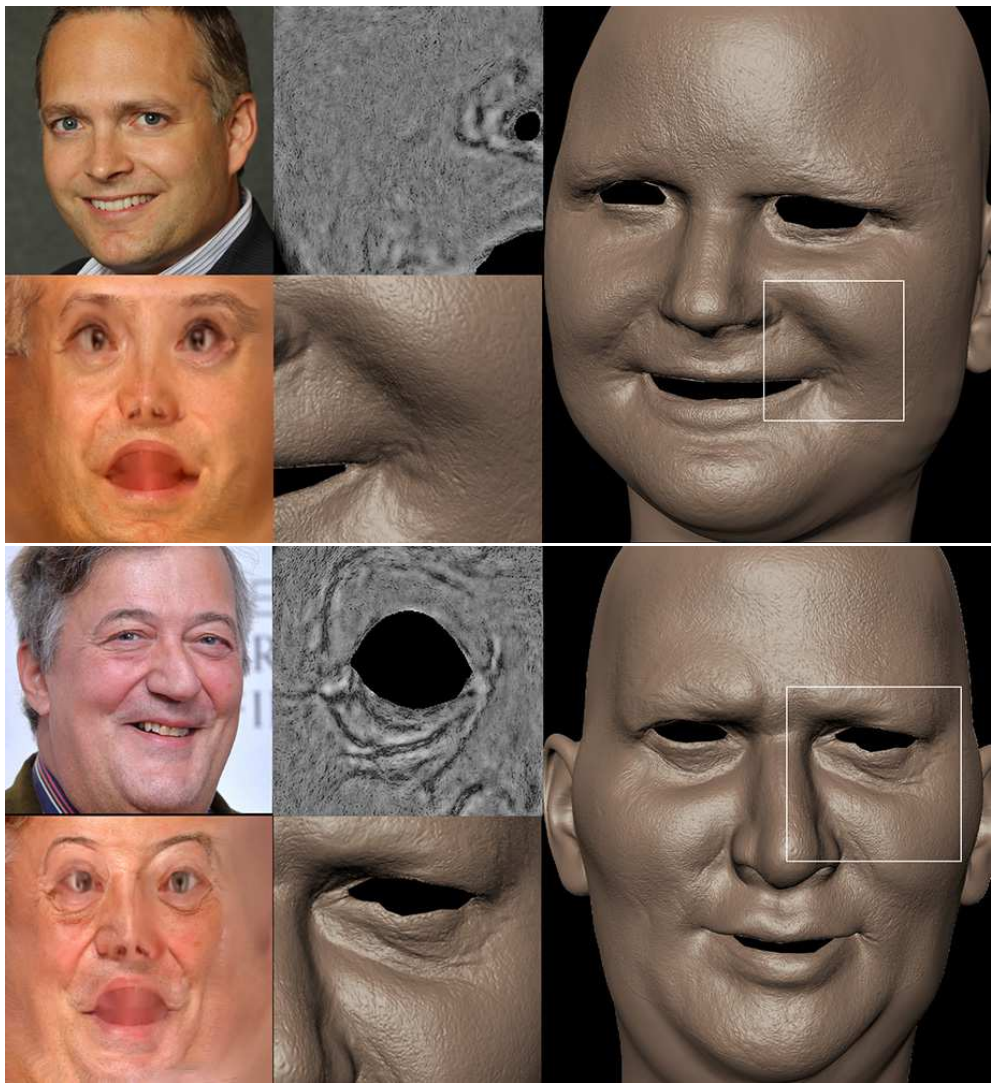
图9|普通图像经过纹理与基础模型处理后,用于推断位移细节。中间展示局部位移和渲染,右侧展示最终几何。来源:原论文图9。
训练主要使用均匀照明纹理,现实照片却可能有强阴影、遮挡或缺失区域。作者因此讨论与既有反照率合成方法结合,补偿照明变化、补齐纹理,再把得到的纹理交给细节网络。
图9展示的是这种组合使用的潜力,不是证明网络可以忽略输入条件,直接对任意原始照片进行同等精度的几何测量。
论文也明确提到,较浓重的舞台妆可能带来位移伪影;罕见的痣、斑点与疤痕等,还需要更多相应训练数据。一个模型学到的纹理—形状关系,如果超出训练覆盖,就可能给出不合适的解释。
十四、这篇论文留下的启发:细节生成既要看得清,也要分得开
这项工作的价值,不只在于用了条件GAN或超分辨率,而在于把问题拆成了适合学习的形式。
用统一UV位移图承载细节,减少了直接预测密集三维坐标的负担;分开中频与高频,避免幅值大的结构淹没细小起伏;再对高频进行超分辨率,让细节能够在输出中得到足够采样。每个设计,都对应了一个明确的表达或学习瓶颈。
对于毛孔级人脸重建,它也提出了一个需要持续面对的问题:视觉上合理的高频结构,与这个人真实存在的微细几何,应该怎样分别验证?
这篇论文已经用Light Stage位移参考和感知实验提供了证据,也展示了学习先验能减少简单明暗假设带来的错误。但当输入没有足够信息时,生成结果仍然包含从训练样本中获得的推断。
更丰富的几何形变、镜面反射与其他物理观测,有机会进一步约束这种推断。作者也将几何应力和局部高光列为后续可加入的输入线索。让细节既符合真实皮肤的统计规律,又受到当前这张脸的观测约束,是从“看起来像皮肤”继续走向“更准确地还原这块皮肤”的关键。
